METR skizziert, wie Prüfer eine KI-getriebene Beschleunigung der KI-Entwicklung untersuchen könnten
METR hat einen Vorschlag veröffentlicht, wie ein externer Prüfer untersuchen könnte, ob die Automatisierung von KI-Forschung und -Entwicklung den Fortschritt bei den Fähigkeiten drastisch beschleunigt. Der Beitrag vom 14. Oktober 2026 nennt vier zu klärende Fragen und die internen Daten, die Entwickler bereitstellen müssten.
- METR hat am 14. Oktober 2026 einen Vorschlag veröffentlicht, wie ein Prüfer die KI-getriebene Beschleunigung der KI-Forschung und -Entwicklung untersuchen könnte.
- Die Prüfung umfasst den Fortschritt bei den Fähigkeiten, den KI-bedingten Anteil der Beschleunigung, Wachstumsengpässe und die Grenzen der Methoden.
- Die Belege würden Benchmarks, Zwischenmaße wie den Pretraining-Loss, Schätzungen des algorithmischen Fortschritts und Interviews mit Forschenden kombinieren.
- Die Daten könnten auf der Hardware der Entwickler analysiert werden, und laut METR ist nur ein minimaler Zugang zur Entwicklerinfrastruktur nötig.
Vier Fragen, die eine Prüfung beantworten würde
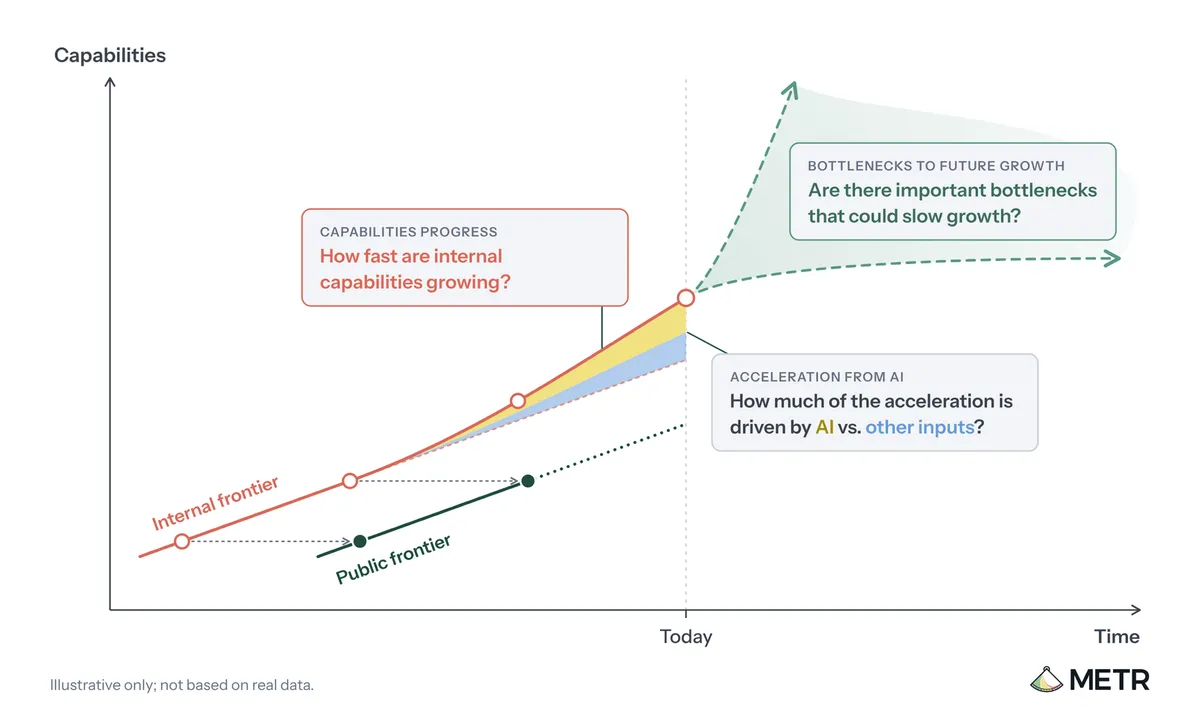
Laut METR würde eine solche Prüfung vier Bereiche abdecken. Der erste ist der Fortschritt bei den Fähigkeiten: wie schnell sich die internen Fähigkeiten verbessern und wie stark sich dieser Fortschritt zuletzt beschleunigt hat. Der zweite ist die Beschleunigung durch KI: Falls es eine Beschleunigung gibt, wie viel davon geht auf KI-Automatisierung zurück und wie viel auf andere Faktoren.
Der dritte Bereich sind Engpässe für künftiges Wachstum, also die Frage, ob Beschränkungen das Wachstum kurzfristig bremsen oder die Beschleunigung begrenzen könnten. Der vierte sind die Grenzen der Methoden: ob sie eine deutlich dramatischere Beschleunigung zuverlässig erkennen würden, wenn sie eingetreten wäre.
METR zufolge müsste dafür die Leistungsfähigkeit unveröffentlichter Modelle analysiert werden. Hinzu kämen ein Verständnis der Entwicklung zentraler Inputs der KI-Forschung und -Entwicklung (Arbeitskraft, Rechenleistung, Daten und Algorithmen) sowie offene Gespräche mit den zuständigen Forschenden darüber, wie KI ihre Arbeit beeinflusst.
Wie Fortschritt und die Rolle der KI gemessen würden
METR argumentiert, dass sich KI-Fähigkeiten nicht mit einem einzelnen Ansatz verstehen lassen. Der Prüfer solle daher mehrere Methoden kombinieren. Dazu zählen Benchmarks und aggregierte Maße wie ECI, Zwischenindikatoren wie der Pretraining-Loss sowie die Einschätzungen der Forschenden selbst, die in Interviews oder Umfragen erhoben werden. Bei Bedarf könnten weitere Näherungswerte hinzukommen.
Um zu beurteilen, ob KI hinter einer Beschleunigung steckt, würde der Prüfer die Inputs untersuchen, die am ehesten von Automatisierung betroffen sind. Eine Frage lautet, wie viel der Beschleunigung bei den Fähigkeiten auf algorithmischen Fortschritt oder Daten zurückgeht, verglichen mit Inputs wie der Skalierung von Rechenleistung, auf die KI-Automatisierung weniger Einfluss hat. Eine zweite lautet, wie viel der Beschleunigung beim algorithmischen Fortschritt oder bei den Daten auf KI-Unterstützung oder -Automatisierung zurückzuführen ist, verglichen mit Inputs wie Experimentier-Rechenleistung und Arbeitskraft.
METR räumt ein, dass es schwierig ist, ein kontrafaktisches Szenario „ohne KI“ zu bestimmen. Eine gut kalibrierte Schätzung erfordere voraussichtlich mehrere Belege: Ausgaben für KI-Agenten (idealerweise nach Team und im Zeitverlauf, in Tokens und Inferenzkosten), qualitative Schilderungen der Forschenden, wie der Fortschritt mit Modellen entsteht, sowie Schätzungen der Arbeitsproduktivität, etwa Codezeilen pro Forschenden und Tag oder selbst berichtete Produktivitätsgewinne.
Daten und Zugang, die der Prüfer benötigen würde
Der Prüfer bräuchte Messwerte zu Inputs und Outputs entlang der gesamten Modellentwicklungs-Pipeline. METR zufolge sollten die Daten einen möglichst langen Zeitraum abdecken, genaue Datumsangaben enthalten, damit sich Veränderungen mit einer historischen Basislinie vergleichen lassen, und wo sinnvoll nach Team oder Bereich aufgeschlüsselt sein.
Der im Beitrag aufgeführte notwendige Zugang umfasst:
- Fähigkeitsmaße über interne Modelle hinweg, darunter Benchmarks und wichtige Zwischenmaße
- Schätzungen des algorithmischen Fortschritts beim Pretraining, Posttraining und in anderen Schlüsselbereichen
- Messwerte zu zentralen Inputs der Forschung und Entwicklung, etwa Trainings-Rechenleistung je Modell, Experimentier-Rechenleistung und Arbeitskraft im Zeitverlauf
- Interviews mit Forschenden über den Fortschritt und den Einfluss von KI auf ihre Arbeit
Bei Benchmarks verlangt METR die Ergebnisse aller gemessenen Benchmarks für sämtliche Frontier-Modelle, auch rein interne, samt Beispielfragen, Details zur Bewertung und Beispielantworten der Modelle. Beim algorithmischen Fortschritt geht METR davon aus, dass Entwickler bereits einige Schätzungen führen, möglicherweise ähnlich einer veröffentlichten Methode, die Forschungsfortschritte auf eine Verringerung der Rechenleistung abbildet, die nötig ist, um bestimmte Leistungsniveaus zu erreichen. Details zu den einzelnen Forschungsfortschritten braucht der Prüfer nicht, nur deren geschätzte Effekte im Zeitverlauf und zwischen Modellen.
Zur Sicherheit erklärt METR, die Daten könnten auf der Hardware der Entwickler analysiert werden, möglicherweise vor Ort in deren Räumlichkeiten, und es sei nur ein minimaler Zugang zur Infrastruktur der Entwickler nötig.
Was das bedeutet
Der Vorschlag ist eine methodische Skizze und kein Bericht über Ergebnisse. Er zeigt, was eine glaubwürdige externe Überprüfung von Behauptungen über KI-beschleunigte KI-Forschung von den Entwicklern verlangen würde: detaillierte, datierte interne Daten und offene Gespräche mit den Beschäftigten. Zudem enthält er einen Test der eigenen Verlässlichkeit, indem er fragt, ob die Methoden eine deutlich stärkere Beschleunigung erkannt hätten und wie interne Belege im Vergleich zu öffentlichen abschneiden. Das soll der Öffentlichkeit helfen einzuschätzen, wie sicher sie sein kann, dass eine dramatische Beschleunigung bemerkt und kommuniziert würde.