Microsoft: Grounding und Konfidenzwerte senken Prüfaufwand eines Versicherers bei Dokumenten um fast 50 Prozent
Ein großer Versicherungskonzern hat laut Microsoft seinen manuellen Prüfaufwand um fast 50 Prozent gesenkt, und zwar mit den Grounding- und Konfidenzfunktionen von Azure Content Understanding. In einem Beitrag im Foundry-Blog berichtet das Unternehmen zudem, das Onboarding von Formularen sei im Vergleich zu früheren Lösungen um 75 Prozent schneller gelaufen.
- Laut Microsoft hat ein Versicherer mit Content Understanding den manuellen Prüfaufwand um fast 50 Prozent gesenkt und das Onboarding von Formularen um 75 Prozent beschleunigt.
- Grounding verknüpft extrahierte Werte mit Belegen im Dokument; laut Microsoft senkte die tiefere Integration den Token-Verbrauch bei der Inferenz um bis zu 28 Prozent.
- Konfidenzwerte stammen von einem separaten, gemeinsam genutzten Modell und nicht aus der Selbsteinschätzung des LLM; ihre AUROC verbesserte sich um bis zu 14 Prozent.
- Kunden kalibrieren Schwellenwerte anhand eigener, menschlich verifizierter Dokumente, statt das Modell neu zu trainieren.
- Der Versicherer ließ weiterhin jedes Feld von Menschen prüfen; die Konfidenzlabels priorisierten lediglich die Prüfung.
Was der Versicherer erreicht hat
Laut Microsoft arbeitete der Versicherer mit dem Forward-Deployed-Engineering-Team des Unternehmens daran, zu entscheiden, welche extrahierten Werte die menschliche Aufmerksamkeit am dringendsten brauchen. Die Lösung nutzte die Funktionen von Content Understanding für Klassifizierung, Extraktion, Grounding und Konfidenz. Microsoft nennt eine Reduzierung des manuellen Prüfaufwands um fast 50 Prozent und ein um 75 Prozent schnelleres Onboarding von Formularen im Vergleich zu früheren Lösungen.
Das Unternehmen führt diese Ergebnisse auf eine Klassifizierungsgenauigkeit von über 97 Prozent auf Seitenebene sowie auf ein Routing anhand von Konfidenz und Grounding zurück. Dadurch hätten sich die Prüfer auf die Ergebnisse konzentriert, die am wahrscheinlichsten Fehler enthalten. Microsoft betont, das Resultat sei nicht auf einen einzelnen Schwellenwert zurückzuführen. Entscheidend sei gewesen zu verstehen, was Konfidenzwerte bedeuten, und sie anhand realer, repräsentativer Dokumente zu kalibrieren.
Grounding und Konfidenz im Überblick
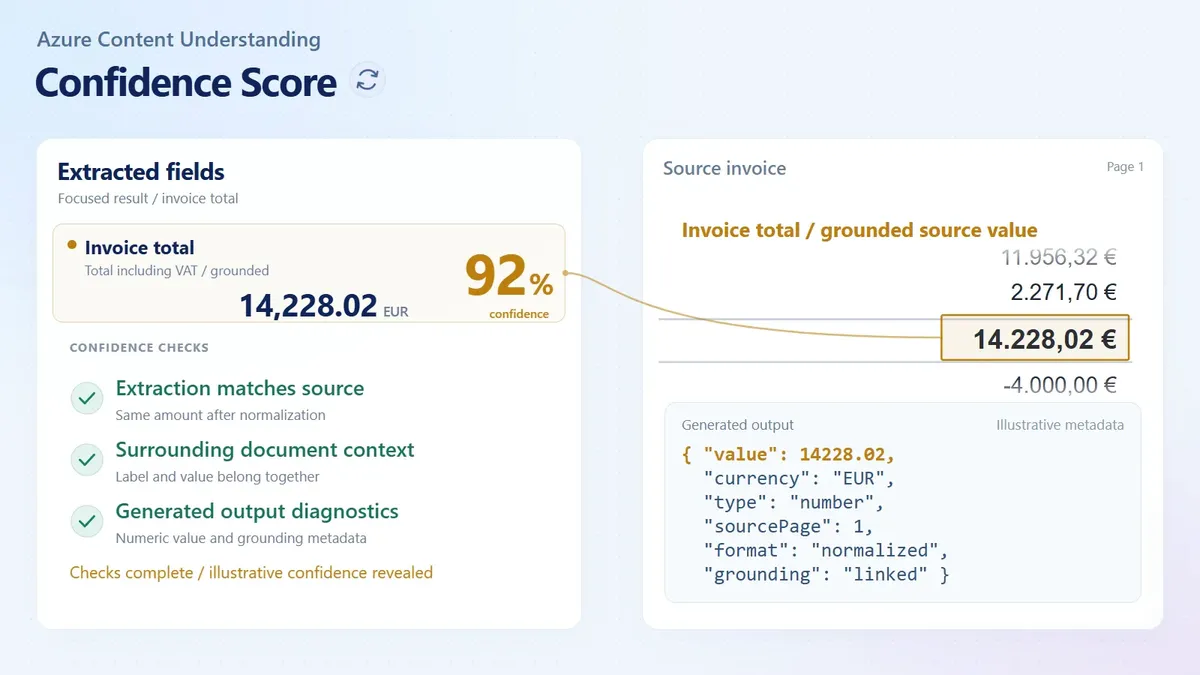
Grounding verknüpft einen extrahierten Wert mit dem Inhalt im Dokument, der ihn belegt. Liefert der Dienst beispielsweise einen Rechnungsbetrag von 14.228,02 US-Dollar, verweist das Grounding auf den zugehörigen Beleg. Laut Microsoft können Anwendungen so Prüfern die Belege anzeigen, einen Wert gemeinsam mit seinem Beleg validieren und einen Prüfpfad bis zur Quellseite führen. Im jüngsten Release habe man das Grounding tiefer in den Extraktionsablauf integriert, wodurch der durchschnittliche Token-Verbrauch bei der Inferenz um bis zu 28 Prozent gesunken und die Genauigkeit gestiegen sei.
Ein Konfidenzwert ist eine gelernte Schätzung dafür, wie verlässlich das Ergebnis für ein bestimmtes Feld ist, mit einem Wert zwischen 0 und 1 für unterstützte Felder. Laut Microsoft hat das jüngste Update die Genauigkeit der Konfidenzwerte, gemessen als AUROC, um bis zu 14 Prozent verbessert.
Das Unternehmen stellt klar, dass der Wert nicht die Selbsteinschätzung des Sprachmodells ist, und verweist darauf, dass LLMs notorisch zu Selbstüberschätzung neigen. Stattdessen wertet ein separates Konfidenzmodell Signale aus wie:
- das Dokument und den verankerten Beleg, einschließlich der Stelle und der Art, wie der Wert auf der Seite erscheint;
- das Feld und das Ergebnis, einschließlich Feldtyp, Position im Schema und vorhergesagtem Wert;
- gelabelte Beispiele, sofern vorhanden;
- Diagnoseinformationen aus der Extraktion selbst, etwa Hinweise auf Mehrdeutigkeit.
Der Wert berücksichtigt den Kontext. Laut Microsoft kann derselbe Wert als Feld der obersten Ebene einen anderen Score erhalten als innerhalb einer Tabelle oder eines Objekts.
Ein gemeinsames Modell, von Kunden kalibriert
Laut Microsoft wird das Konfidenzmodell mit von Microsoft kuratierten Daten trainiert, nicht mit Kundendaten. Es handelt sich um ein gemeinsames Modell auf Dienstebene, Kunden trainieren also nicht für jeden Analyzer ein eigenes, und Microsoft aktualisiert es regelmäßig. Stattdessen prüfen Kunden die Werte anhand kontrollierter Beispiele aus ihrem eigenen Workflow und wählen Schwellenwerte, die zu ihren Geschäftszielen passen.
Das Unternehmen beschreibt den Wert vor allem als Ranking-Signal für das Risiko: Ergebnisse mit niedrigerem Score sollten einen deutlich größeren Anteil der Fehler enthalten. Da Teams nicht alles prüfen können, zeigt der Wert an, wo man zuerst hinschauen sollte.
So war der Workflow des Versicherers aufgebaut
Content Understanding klassifizierte und segmentierte eingehende Seiten zunächst nach Formulartyp. Jedes relevante Segment ging anschließend an einen formulartypspezifischen Klassifikator, der die Version bestimmte, gefolgt vom passenden Analyzer für die Feldextraktion. Um einen großen Dokumentenkatalog zu bewältigen, wurde die Klassifizierung auf mehrere Analyzer in zwei Stufen verteilt, wobei die Segmentierung nur in der ersten aktiviert war.
Microsoft weist darauf hin, dass Content Understanding v1 keine Konfidenzwerte für Klassifizierungen liefert, weshalb alle Klassifizierungen weiterhin manuell geprüft werden mussten. Wo für den Dokumenttyp und die Extraktionskonfiguration eine gültige Kalibrierung vorlag, setzten Konfidenzregeln auf Feldebene Prioritätslabels im Human-in-the-Loop-Prüfwerkzeug. Andere Ergebnisse blieben in der Standardprüfung.
Weil Versicherungsdaten sensibel sind, kontrollierten Menschen weiterhin jedes Feld. Die Labels lenkten die Aufmerksamkeit, ersetzten aber keine automatische Durchlaufverarbeitung. Laut Microsoft könnten weniger sensible Workflows dieselben kalibrierten Regeln nutzen, um nicht markierte Werte direkt durchzuleiten.
Erst die Dokumente betrachten, nicht den Score
Der erste der drei von Microsoft beschriebenen Schritte lautet, die Extraktionsgenauigkeit über verschiedene Dokumenttypen hinweg zu prüfen, bevor man einen Schwellenwert festlegt. Die Qualität kann je nach Formularversion schwanken, etwa bei einem Steuerformular von 2024 gegenüber einer Version von 2026, die ein Feld ergänzt oder eine Tabelle ändert, sowie je nach Quelle, denn manche Anbieter schicken saubere Dokumente, andere dichte oder gescannte.
Microsoft rät, manuell geprüfte Ergebnisse nach Formular- oder Dokumentfamilie, Version und Quelle aufzuschlüsseln und anhand realer, repräsentativer Produktivdokumente mit menschlich verifizierten Antworten zu kalibrieren. Das Unternehmen warnt, dass die Kalibrierung nur für die untersuchten Dokumenttypen, Quellen, Analyzer-Konfigurationen, Feldschemata und das zugrunde liegende Extraktionsmodell gilt und keine übertragbare Garantie für andere Dokumente ist.
Microsoft Foundry: From extraction to action: Using grounding and confidence to build reliable document workflows