NVIDIA veröffentlicht quelloffene C++-Beispiele für lokale KI mit TensorRT RTX
NVIDIA hat Do Inference Now (DIN) Deploy veröffentlicht, eine quelloffene Sammlung von C++-Beispielen, die ONNX Runtime mit dem NVIDIA TensorRT RTX Execution Provider kombiniert. Laut NVIDIA soll sie Entwicklern helfen, unter Windows und Linux vom Modell-Checkpoint zu einer nativen, hardwarebeschleunigten Anwendung zu gelangen.
- DIN Deploy ist eine quelloffene Sammlung von C++-Beispielen, die ONNX Runtime mit dem NVIDIA TensorRT RTX Execution Provider kombiniert.
- Die Beispiele umfassen Whisper, Parakeet TDT und Nemotron ASR Streaming für Sprache, Meta SAM 2.1 für Segmentierung und FLUX.2-klein-4B für Bildgenerierung.
- Auf DGX Spark erreicht Parakeet TDT das 206,41-Fache der Echtzeit auf der GPU gegenüber dem 14,44-Fachen auf der CPU, SAM 2.1 läuft mit 38,3 FPS auf der GPU gegenüber 0,5 FPS auf der CPU.
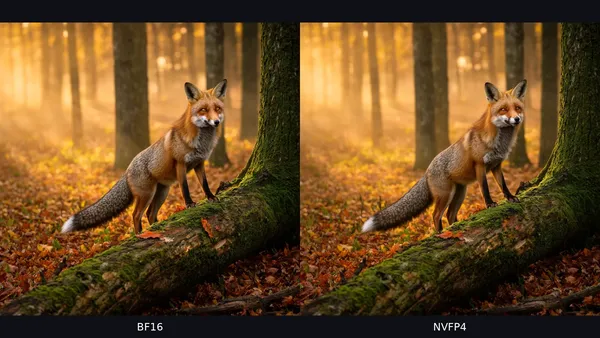
- Das FLUX.2-Beispiel nutzt die Grafik-Interop von ONNX Runtime 1.25 mit Vulkan und DirectX und zeigt ein quantisiertes ONNX-Modell als direkten Ersatz.
- CMake-Presets decken Windows, Linux, x86-64 und Arm64 ab.
Vom Hugging-Face-Checkpoint zur nativen C++-App
Jedes DIN-Deploy-Beispiel beginnt mit einem Python-Exporter, der einen Modell-Checkpoint von Hugging Face herunterlädt und in ein ONNX-Artefakt umwandelt. Die Anwendungsseite bildet eine native C++-Kommandozeilenschnittstelle auf Basis von ONNX Runtime (ORT). Laut NVIDIA trennt diese Aufteilung die Modellkonvertierung von der Deployment-Logik, sodass Entwickler ein exportiertes Modell ohne modellspezifische Laufzeitumgebung in eine lokale Anwendung übernehmen können.
Der Großteil des Beispielcodes stützt sich auf die Session- und Tensor-APIs von ONNX Runtime in C++. Herstellerspezifischer Code, darunter CUDA-APIs und -Kernel, findet sich nur in optionalen beschleunigten Pfaden. Execution Provider, die die benötigten Tensor-APIs von ONNX Runtime unterstützen, können den gemeinsamen Code ausführen, und die Copy-Tensor-API von ORT hält die Datenlokalität beherrschbar, ohne dass im gemeinsamen Code herstellerspezifische APIs nötig wären. Auf dieselbe ONNX-Runtime-API lässt sich auch über WinML 2.0 zugreifen.
Das Repository enthält CMake-Presets für Windows und Linux, einschließlich Arm64-Varianten. DirectX steht nur unter Windows zur Verfügung.
Spracherkennung, Segmentierung und Bildgenerierung
Für die automatische Spracherkennung unterstützt DIN Deploy Offline- und Streaming-Pipelines. OpenAI Whisper deckt die Offline-Transkription über verschiedene Modellgrößen hinweg ab, während NVIDIA Parakeet TDT und NVIDIA Nemotron ASR Streaming Streaming-Pipelines bereitstellen.
Die Beispiele mit Meta SAM 2.1 unterstützen interaktives Maskieren für Bilder und Videos. Sie wandeln Modellausgaben in Segmentierungsmasken um, die native Anwendungen für Auswahl, Tracking und andere Computer-Vision-Workflows nutzen können.
Das Beispiel mit FLUX.2-klein-4B deckt die promptgesteuerte Bildgenerierung ab. Es enthält Interoperabilität mit den Grafik-APIs Vulkan und DirectX, mit der Anwendungen GPU-residente Ressourcen über eine herstellerübergreifende Shader-Schnittstelle einbinden können. Für die Vor- und Nachverarbeitung rund um das exportierte Modell nutzt es die in Version 1.25 eingeführte Grafik-Interop-Funktion von ONNX Runtime.
Das Beispiel demonstriert zudem die Post-Training-Quantisierung (PTQ) mit NVIDIA Model Optimizer, die ein quantisiertes ONNX-Modell erzeugt. NVIDIA weist darauf hin, dass die Quantisierung hardwareabhängig ist. Da die ONNX-Schnittstellen jedoch unverändert bleiben, lässt sich das quantisierte Modell ohne Änderungen am Anwendungscode als direkter Ersatz einsetzen.
Leistung auf DGX Spark
NVIDIA hat GPU- und CPU-Messwerte für ausgewählte Workloads auf DGX Spark veröffentlicht. Die Audioergebnisse werden als Vielfaches der Echtzeit angegeben, wobei höhere Werte schneller bedeuten.
- openai/whisper-large-v3-turbo: 58,5x auf der GPU, 3,8x auf der CPU
- nvidia/nemotron-3.5-asr-streaming-0.6b: 39,01x auf der GPU, 3,24x auf der CPU
- nvidia/parakeet-tdt-0.6b-v3: 206,41x auf der GPU, 14,44x auf der CPU
- facebook/sam2.1-hiera-base-plus: 38,3 FPS auf der GPU, 0,5 FPS auf der CPU
Einstieg und Bedeutung für Entwickler
NVIDIA empfiehlt, mit den CMake-Presets des Repositorys für Windows, Linux, x86-64 und Arm64 zu beginnen. Nach der Konfiguration und dem Build des Projekts können Entwickler ein Modell nach ONNX exportieren und die Kommandozeilenanwendung mit TensorRT RTX ausführen oder den Code in die eigene Anwendung kopieren und die Pipeline-Implementierungen wiederverwenden. CMake lädt standardmäßig ONNX Runtime und TensorRT RTX herunter.
Für Teams, die lokale KI-Funktionen entwickeln, bieten die Beispiele funktionierenden Referenzcode für mehrere gängige Aufgaben, darunter Transkription, Segmentierung und Bildgenerierung, in einer nativen C++-Umgebung. Die Zahlen stammen aus NVIDIAs eigenen Tests auf DGX Spark, auf anderer Hardware können die Ergebnisse daher abweichen.
NVIDIA Developer: Build Local AI Apps with C++ and NVIDIA TensorRT RTX Samples