NVIDIA Mission Control 2.5 bringt autonome Wiederherstellung auf Kubernetes
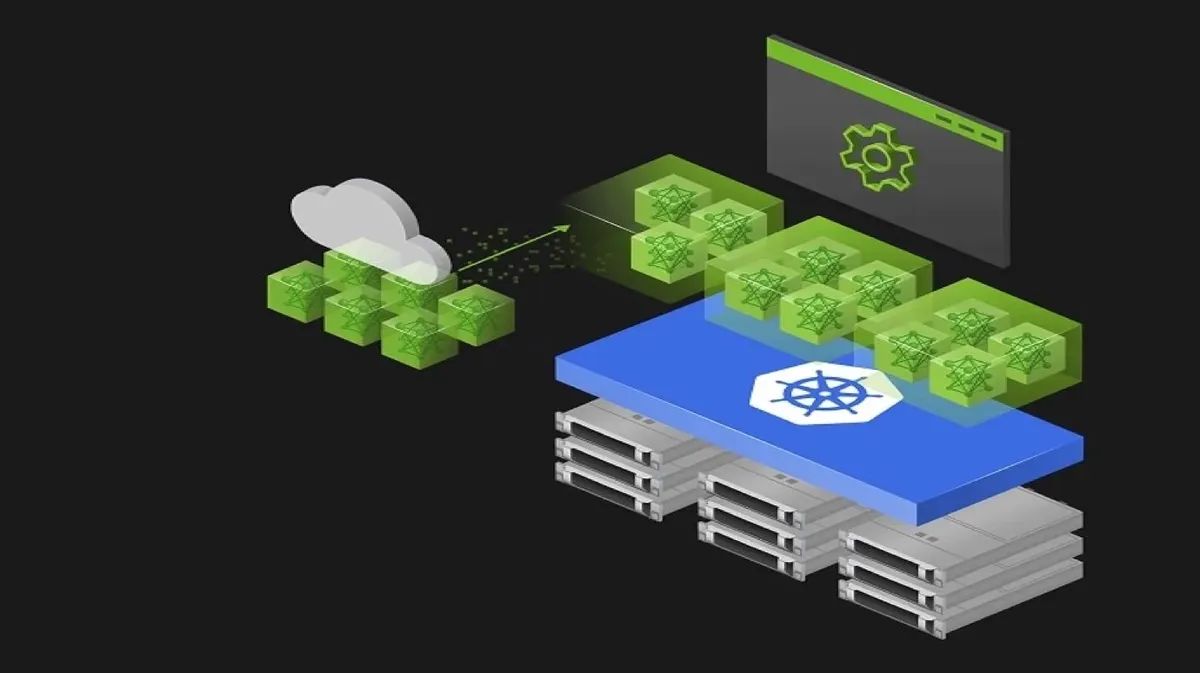
NVIDIA Mission Control 2.5 dehnt die autonome Recovery-Engine auf Kubernetes-basierte Workloads aus, die mit NVIDIA Run:ai verwaltet werden. Bislang war die Engine, die Anomalien im gesamten Stack erkennt, diagnostiziert und behebt, laut NVIDIA auf HPC-Workloads unter Slurm beschränkt.
- NVIDIA Mission Control 2.5 weitet die autonome Recovery-Engine von Slurm-HPC-Workloads auf Kubernetes-Workloads aus, die mit NVIDIA Run:ai verwaltet werden.
- Die Engine kombiniert den Kubernetes-Scheduler, einen autonomen Job-Recovery-Dienst und einen autonomen Hardware-Recovery-Dienst in einem Regelkreis mit drei Ebenen.
- Bei einem Hardwarefehler laufen Job-Wiederherstellung und Knoten-Quarantäne samt Diagnose parallel, sodass Workloads nicht auf die Ursachenanalyse warten.
- Vorübergehende Softwarefehler werden erneut versucht, ohne Hardware-Reparaturmaßnahmen auszulösen.
- Sich verschlechternde Knoten können aus dem Scheduling-Pool genommen werden, bevor ein Job gestört wird.
Von Slurm zu Kubernetes
Nach Angaben von NVIDIA hat das Training von KI-Modellen in großem Maßstab das Betriebsmodell von Rechenzentren verändert. Moderne KI-Fabriken führen verteilte Trainingsjobs über Hunderte Knoten hinweg aus, und das über Tage oder Wochen. In dieser Größenordnung müssen Hardwareanomalien, Softwarefehler, Netzwerk-Timeouts und Ressourcenkonflikte proaktiv beherrscht werden. Manuelle Eingriffe, statisches Checkpointing und reaktives Monitoring skalierten nicht, argumentiert das Unternehmen, wenn Organisationen Dutzende gleichzeitiger Multi-Node-Workloads auf gemeinsam genutzter Infrastruktur betreiben.
Die autonome Recovery-Engine in Mission Control ist NVIDIAs Antwort auf dieses Problem. Mit Version 2.5 deckt der Dienst neben Slurm nun auch Kubernetes-Workloads ab, die über NVIDIA Run:ai verwaltet werden. Das Ziel beschreibt NVIDIA so: Der Betrieb von KI-Fabriken soll von reaktiver Wartung zu proaktiver, selbstheilender Infrastruktur übergehen.
Ein Regelkreis mit drei Ebenen
NVIDIA beschreibt das System nicht als einzelne Recovery-Funktion, sondern als Regelkreis mit drei klar getrennten Rollen.
- Kubernetes-Scheduler: In Mission Control ist NVIDIA Run:ai der standardmäßige Kubernetes-Scheduler und in der Software enthalten. Er verwaltet Kubernetes-basierte KI-Workloads, Warteschlangen und Richtlinien und platziert Jobs auf verfügbarer Kapazität.
- Autonomer Job-Recovery-Dienst: Dies ist die Ebene mit Workload-Kontext. Sie überwacht laufende Jobs, verfolgt, wo diese jeweils ausgeführt werden, und klassifiziert anhand von Fehlerhistorie und Job-Topologie, welcher Wiederherstellungspfad sinnvoll ist. Die Integration des Ressourcenmanagers setzt diese Empfehlung anschließend in einen Neustart, einen erneuten Versuch, eine erneute Einreihung in die Warteschlange oder eine Platzierungsaktion um.
- Autonomer Hardware-Recovery-Dienst: Dies ist die Ebene für den Zustand der Infrastruktur. Sie überwacht Knoten und GPUs, nimmt auffällige Komponenten bei Bedarf aus dem Scheduling und führt Diagnosen oder Reparaturmaßnahmen durch, damit sich Hardwareprobleme nicht auf neue Jobs ausweiten.
Laut NVIDIA macht die Trennung dieser Zuständigkeiten das Modell portabel. Der Job-Recovery-Dienst muss keine Hardware reparieren, und der Hardware-Recovery-Dienst muss nicht jedes Trainings-Framework verstehen. Der Scheduler kann Workloads zudem auf bereitstehende Kapazität lenken, ohne auf eine Ursachendiagnose zu warten.
Drei Fehlerszenarien
NVIDIA geht drei Fälle durch, um zu zeigen, wie sich der Regelkreis je nach Fehlersignal verhält.
Hardwarefehler während des Trainings. Beginnt eine GPU auszufallen, zeigt sich das Symptom zunächst womöglich als ECC-Fehler, hängender Worker oder Kommunikations-Timeout. Die Wiederherstellung teilt sich dann in zwei parallele Stränge. Der Job-Recovery-Dienst erfasst den Job-Kontext und identifiziert den verdächtigen Knoten oder die verdächtige GPU, und die Scheduler-Integration startet den Job neu oder plant ihn um. Gleichzeitig isoliert der Hardware-Recovery-Dienst den Knoten, protokolliert den Grund und startet Diagnosen. Laut NVIDIA wartet der Workload nicht auf die Ursachenanalyse, und der fehlerhafte Knoten wird nicht an den nächsten Job vergeben.
Vorübergehender Softwarefehler. Ein Trainings-Worker kann sich beenden, auf einen behebbaren Timeout stoßen oder kurz die Koordination verlieren, während der Knoten gesund ist. Sieht die Fehlerhistorie nach einem vorübergehenden Problem aus, wiederholt das System den Versuch gemäß der Scheduler-Richtlinie, statt Hardware unter Quarantäne zu stellen, die gar nicht repariert werden muss. Wiederholbare Softwarefehler führen zu einem automatischen Neustart, bei wiederholtem Auftreten werden sie gemeldet. Der Vorteil liegt laut NVIDIA in der Zurückhaltung: kein unnötiger Alarmrauschen für Operatoren und keine Verkleinerung des Scheduling-Pools.
Früh erkannte Hardware-Degradation. Ein Knoten kann wiederholt GPU-Gesundheitswarnungen, Verbindungsprobleme oder andere riskante Signale zeigen. Der Hardware-Recovery-Dienst kann ihn proaktiv aus dem Scheduling ausschließen und Diagnosen starten, bevor ein Trainingsjob dort landet. Der Job-Recovery-Dienst muss dann womöglich gar nicht eingreifen.
Was das für Betreiber bedeutet
Für Teams, die KI-Workloads mit NVIDIA Run:ai auf Kubernetes betreiben, bringt das Update dasselbe Recovery-Framework, das Slurm-Nutzern bereits zur Verfügung stand. NVIDIA verweist für Upgrade-Anleitungen auf seinen Dokumentationsbereich und für weitere Funktionen auf die vollständigen Release Notes, darunter eine KI-gestützte Erkennung von Netzwerkanomalien. Eine Lösungsübersicht erläutert, wie Mission Control den Betrieb von KI-Fabriken vereinfachen soll.
NVIDIA Developer: How NVIDIA Mission Control 2.5 Brings Autonomous Recovery to Kubernetes