NVIDIA Vera Rubin NVL72 führt MLPerf-Tests für agentische Inferenz an
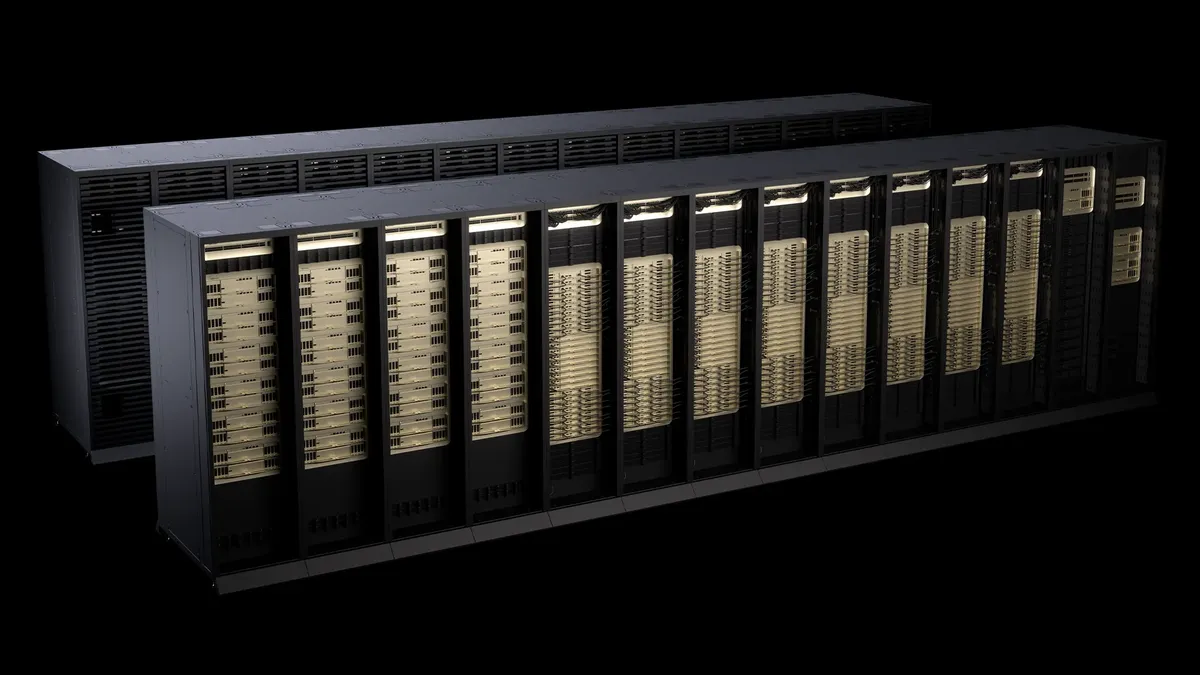
Laut NVIDIA erzielte Vera Rubin NVL72 in vorläufigen Ergebnissen von MLPerf Endpoints v1.0 bei drei Modellen für agentische KI einen 5- bis 10-mal höheren Durchsatz pro Kilowatt als GB300 NVL72. Bei gleicher Parallelität zeigen die Vergleiche außerdem eine 3- bis 5-mal höhere Ende-zu-Ende-Interaktivität.
- Vera Rubin NVL72 erzielte bei drei Modellen einen 5- bis 10-mal höheren Durchsatz pro Kilowatt.
- Bei gleicher Parallelität war die Ende-zu-Ende-Interaktivität 3- bis 5-mal höher.
- Die Tests umfassten Kimi K3, DeepSeek-V4.1-Flash und Qwen3.6-35B-A3B.
- Die Ergebnisse für Vera Rubin sind vorläufig und müssen noch von der MLCommons Association verifiziert werden.
Vera Rubin liegt bei drei Modellen vorn
Die Ergebnisse decken Kimi K3, DeepSeek-V4.1-Flash und Qwen3.6-35B-A3B ab. NVIDIA meldet im Vergleich zu NVIDIA GB300 NVL72 ein Verhältnis beim Durchsatz pro Kilowatt von 10:1 für Kimi K3, 9:1 für DeepSeek-V4.1-Flash und 5:1 für Qwen3.6-35B-A3B.
Für den Vergleich wurde bei jeder Plattform der beste Durchsatz pro bereitgestelltem Kilowatt herangezogen, wobei eine angegebene Mindestschwelle für die durchschnittliche Ende-zu-Ende-Interaktivität eingehalten werden musste. Bei Kimi K3 wurden beide Plattformen bei einer gemeinsamen Mindestvorgabe von 50 Tokens pro Sekunde und Nutzer verglichen. Laut NVIDIA erreichte Vera Rubin bei gleicher Anzahl paralleler Anfragen außerdem eine 3- bis 5-mal höhere Ende-zu-Ende-Interaktivität: 3-mal bei Kimi K3, 5-mal bei DeepSeek-V4.1-Flash und 3-mal bei Qwen3.6-35B-A3B.
Eine auf agentische Systeme zugeschnittene Arbeitslast
MLPerf Endpoints v1.0 bewertet das Verhältnis zwischen Bereitstellungskapazität und Reaktionsfähigkeit anhand von Programmier- und Unternehmens-Workflows, die über API-Endpunkte aufgerufen werden. Der Datensatz bildet die Anforderungen mehrstufiger Agenten ab, darunter wachsende Gesprächsverläufe, Schlussfolgerungen, Tool-Aufrufe und Antworten.
Während der Leistungstests werden generierte Tool-Aufrufe und die Absicht des Workflows mit Referenzwerten abgeglichen. Separate SWE-bench-Verified-Evaluierungen prüfen laut NVIDIA die Fähigkeit zur Lösung von Aufgaben von Anfang bis Ende. Damit soll bewertet werden, ob eine schnellere Bereitstellung die Modellqualität bewahrt.
In einem Ergebnis für Kimi K3 nutzte Vera Rubin NVL72 32 Beschleuniger und erreichte einen Systemdurchsatz von 41.414,2 Tokens pro Sekunde bei 100,89 kW. Das Ergebnis für GB300 NVL72 basierte auf 48 Beschleunigern und wies 2.210,4 Tokens pro Sekunde bei 60 kW aus. Beim gemeldeten Ergebnis für Vera Rubin lag die durchschnittliche Ende-zu-Ende-Interaktivität bei 50,4 Tokens pro Sekunde und Nutzer, beim Ergebnis für GB300 bei 56,2.
Optimierungen bei Hard- und Software
Laut NVIDIA kombinieren Rubin-GPUs HBM4-Speicher, NVIDIA Tensor Cores und NVIDIA NVLink der sechsten Generation für agentische Inferenz. HBM4 ermöglicht den Zugriff auf Modellgewichte und den Gesprächszustand, Tensor Cores beschleunigen Matrixoperationen und NVLink unterstützt die Kommunikation zwischen GPUs.
Das Unternehmen verweist außerdem auf kontextbewusste Bereitstellungstechniken wie Prefix-Caching, die Wiederverwendung von Zuständen und das Routing mit NVIDIA Dynamo. Diese Verfahren nutzen bereits ausgeführte Berechnungen erneut und verteilen die Bereitstellungslast über agentische Arbeitslasten hinweg. Zu den modellspezifischen Optimierungen gehören DeepSeeks MegaMoE-Kernel sowie Qwens Multi-Token-Prediction mit Tensor-Core-Verifizierung. Laut NVIDIA reduzieren sie die Datenbewegungen und die Zahl sequenzieller Dekodierungsschritte.
Die Ergebnisse sind weiterhin vorläufig
Die Zahlen für Vera Rubin wurden als vorläufige Ergebnisse veröffentlicht und müssen noch von der MLCommons Association verifiziert werden. Laut NVIDIA können sie sich im Zuge der Begutachtung durch Fachkollegen noch ändern. Die Ergebnisse für GB300 wurden von der MLCommons Association verifiziert.
Für Organisationen, die Agenten betreiben, könnte die gemeldete Effizienz mehr gleichzeitig aktive Agenten innerhalb desselben Energiebudgets ermöglichen, während eine ähnliche Reaktionsfähigkeit erreicht wird. Die Benchmark-Ergebnisse positionieren Vera Rubin NVL72 damit als Plattform für den wachsenden Bereitstellungsbedarf mehrstufiger Programmier- und Unternehmens-Workflows. Der endgültige Status der MLPerf-Ergebnisse bleibt jedoch offen.
NVIDIA Developer: NVIDIA Vera Rubin NVL72 Leads Agentic Inference Performance on MLPerf Endpoints v1.0