Open-Weight-Modelle liegen bei Cybersicherheit 6 bis 7 Monate hinter geschlossenen KI-Modellen, so Epoch AI
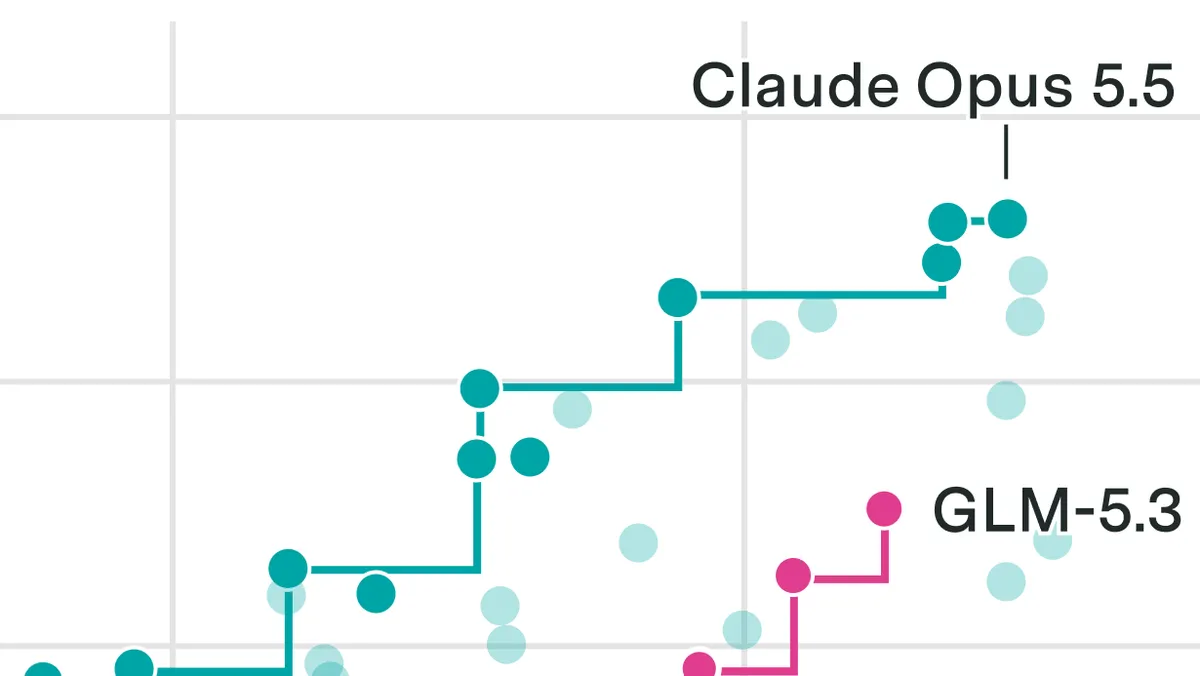
Open-Weight-KI-Modelle liegen bei Aufgaben der Cybersicherheit rund 6 bis 7 Monate hinter der Spitze der geschlossenen Modelle zurück, so Epoch AI. Z.ais GLM-5.3 ist mit einem Wert von 160 das beste Open-Weight-Modell im Cyber ECI, vor OpenAIs GPT-5.4, aber hinter Claude Mythos Preview und GPT-5.5.
- Z.ais GLM-5.3 ist mit einem Wert von 160 das beste Open-Weight-Modell im Cyber ECI von Epoch AI.
- Es schlägt GPT-5.4, liegt aber hinter Claude Mythos Preview und GPT-5.5, beide aus dem April 2026.
- Epoch AI sieht die offene Cyber-Spitze etwa 6 bis 7 Monate hinter der geschlossenen.
- Claude Opus 5.5 und GPT-6 Astra führen die geschlossene Spitze mit 171 an.
- Der Wert von GLM-5.3 beruht auf nur drei CAISI-Benchmark-Ergebnissen.
GLM-5.3 führt das Feld der Open-Weight-Modelle an
Epoch AI veröffentlicht den Cyber ECI, eine auf Cybersicherheit ausgerichtete Version seines Epoch Capabilities Index (ECI). Nach diesem Maßstab erzielt Z.ais GLM-5.3 den höchsten Wert unter den Open-Weight-Modellen. Das Modell erschien am 14.08.2026 unter einer Open-Weights-Lizenz mit eingeschränkter Nutzung. Der zentrale Schätzwert liegt bei 160,10, das 90-Prozent-Intervall reicht von 155,83 bis 166,97.
Damit liegt GLM-5.3 über OpenAIs GPT-5.4, das im März 2026 erschien und 157,04 erreicht. Unter Claude Mythos Preview (April) mit 164,82 und GPT-5.5 mit 162,22, beide aus dem April 2026, bleibt es dagegen. Epoch AI folgert, dass die offene Cyber-Spitze ungefähr dort steht, wo die geschlossene Spitze vor 6 bis 7 Monaten stand.
Andere Open-Weight-Modelle im Datensatz schneiden schlechter ab. Kimi K3 von Moonshot kommt auf 157,60, GLM-5.2 auf 154,12, GLM-5.1 auf 152,91 und DeepSeek-V4-Pro auf 150,35.
Die Spitze der geschlossenen Modelle rückt weiter vor
Auch die Modelle mit geschlossenen Gewichten haben sich weiterentwickelt. Laut Epoch AI wird die Spitze derzeit von Anthropics Claude Opus 5.5 und OpenAIs GPT-6 Astra angeführt, beide mit einem Cyber ECI von 171. Die zentralen Schätzwerte betragen 171,14 beziehungsweise 171,03.
Um den Rückstand zu schätzen, betrachtete Epoch AI jene geschlossenen Modelle, deren Werte GLM-5.3 am engsten einrahmen. GPT-5.4, veröffentlicht am 5. März 2026, liegt darunter, Mythos Preview, veröffentlicht am 7. April 2026, darüber. Zum Stichtag der Daten lagen diese Veröffentlichungen 7 beziehungsweise 6 Monate zurück.
Epoch AI vergleicht Modelle anhand der zentralen Schätzwerte. Das Institut erwartet in Kürze Änderungen an der Methodik, die bessere Schätzungen der Unsicherheit bei Unterschieden zwischen Modellen erlauben sollen.
So ist der Index aufgebaut
Der Cyber ECI ist eine domänenspezifische Version des ECI auf Basis von Cybersicherheits-Benchmarks. Epoch AI übernimmt die Benchmark-Parameter aus einer gemeinsamen Anpassung des ECI an allgemeine und Cyber-Benchmarks und schätzt dann den Wert jedes Modells allein anhand seiner Cyber-Ergebnisse. Die Werte liegen auf derselben Skala wie der allgemeine ECI.
Die Daten stammen vom 8. Oktober 2026. Mit dem Oktober-Update wuchs der Index von 56 auf 76 Modelle und von 20 auf 35 Cybersicherheits-Benchmarks, insgesamt auf 324 Ergebnisse für Modell-Benchmark-Paare. Zu den Quellen zählen das britische AI Security Institute (AISI), CAISI, das auf KI-Cyberbewertungen spezialisierte Unternehmen Irregular, Berichte der Modellentwickler und weitere öffentliche Quellen. Die Analyse umfasst die 57 Modelle mit mindestens zwei Cyber-Benchmark-Ergebnissen.
Einschränkungen und Bedeutung
Epoch AI nennt mehrere Vorbehalte:
- Wenige Ergebnisse pro Modell. Der Wert von GLM-5.3 beruht auf drei CAISI-Benchmark-Ergebnissen, der von Opus 5.5 auf vier von Anthropic gemeldeten Benchmarks. Opus 5.5 und Astra teilen keine Benchmarks, und ihre Konfidenzintervalle überlappen fast vollständig.
- Erschlossene Identitäten. CAISI nannte die geprüften US-Modelle nicht beim Namen, weshalb Epoch AI diese Ergebnisse den Modellen zuordnete, die es zum jeweiligen Zeitpunkt für am wahrscheinlichsten führend hält, etwa GPT-6 Astra und Claude Mythos Preview.
- Neuanpassungen verändern Werte. Die Neuanpassung im Oktober senkte mehrere Spitzenwerte, Claude Mythos 5 fiel um 3,9 Punkte, GPT-5.6 Sol um 4,7. Werte aus früheren Veröffentlichungen von Epoch AI sind daher nicht direkt mit den neuen vergleichbar.
Für alle, die Cyber-Fähigkeiten verfolgen, lautet der Befund: Frei herunterladbare Modelle sind den führenden geschlossenen Systemen nah, aber nicht auf Augenhöhe. Der Abstand bemisst sich in Monaten, nicht in Jahren, auch wenn die dünne Benchmark-Abdeckung bei GLM-5.3 die Schätzung mit echter Unsicherheit behaftet.
Epoch AI: Open-weight AI models are 6-7 months behind on cyber