Open-Weight-Modelle gehen in Produktion, berichtet Kilo-Panel
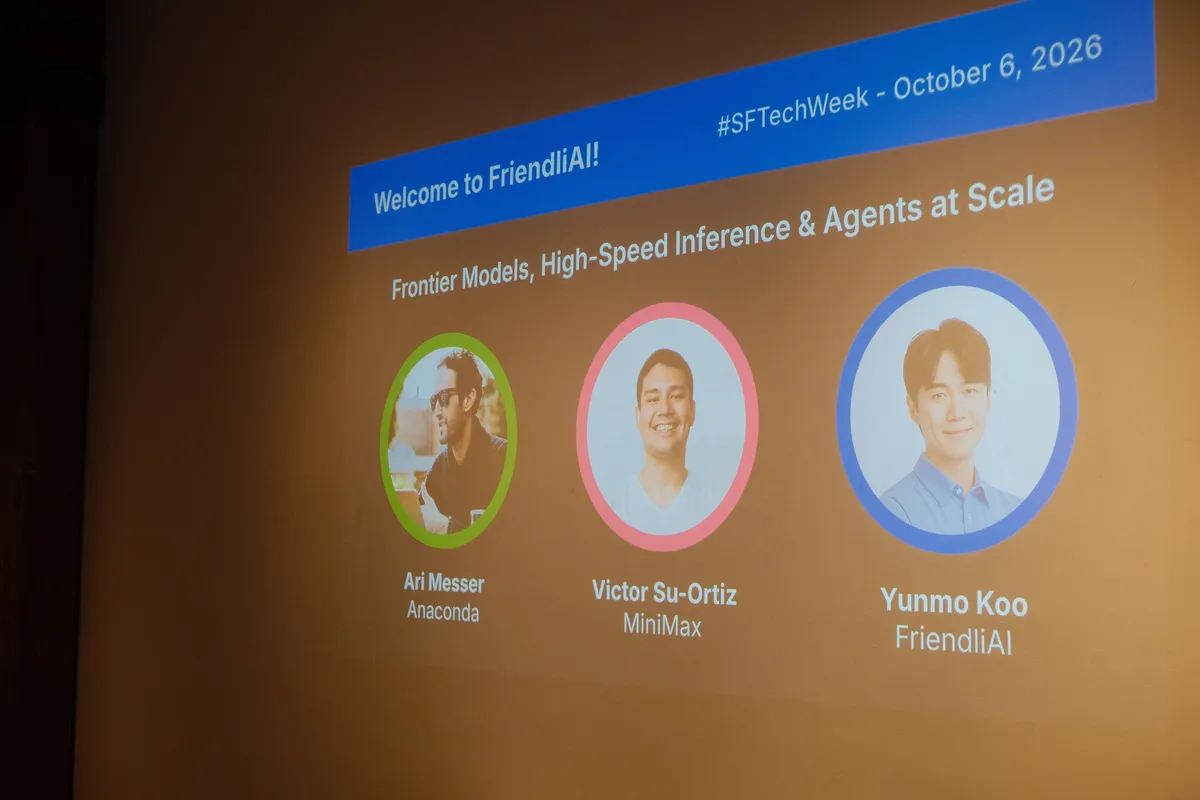
Open-Weight-Modelle wandern bei Banken, Fintechs und Biotech-Unternehmen aus der Experimentierphase in den Produktivbetrieb. Das berichteten Sprecher eines Panels, das Kilo (von Anaconda), Friendli AI und MiniMax veranstaltet haben. Der Grund habe sich von den Kosten hin zu Leistung und Kontrolle verschoben, und der Erfolg hänge am gesamten Stack, nicht allein am Modell.
- Panelisten von Kilo (Anaconda), Friendli AI und MiniMax berichten, dass Banken, Fintechs und Biotech-Unternehmen offene Modelle inzwischen produktiv betreiben.
- Laut Ari Messer von Anaconda hat sich die Motivation von den Kosten hin zu Leistung und Kontrolle verschoben.
- Yunmo Koo von Friendli AI sagte, ein Endpunkt mit 95 Prozent Zuverlässigkeit falle über eine Agentenkette mit zehn Schritten auf rund 60 Prozent Ende-zu-Ende.
- Neue Attention- und Cache-Designs brauchen passende Arbeit an der Inferenz-Engine, um in der Praxis zu wirken.
- Das Panel riet, mit den eigenen Workloads zu testen und Evals sowie Observability in jeden Schritt eines Agenten-Workflows einzubauen.
Von den Kosten zur Kontrolle
Das Panel brachte drei Ebenen des Stacks zusammen: das Agent-Harness, das Modell und die Inferenz-Engine. Ari Messer von Anaconda (Kilo) sagte, das Interesse an offenen Modellen bestehe schon länger, vor allem in regulierten Branchen, denen Transparenz und Governance wichtig sind. Neu sei der tatsächliche Einsatz in der Produktion.
"Erst in den vergangenen paar Monaten sehen wir, dass sich alle, von unseren Biotech-Kunden bis zu richtig großen Banken und Fintechs, in diese Richtung bewegen", sagte Messer. Anfangs seien die Gespräche um Kosten gegangen, jetzt gehe es "viel mehr um Leistung und Kontrolle".
Victor Su-Ortiz von MiniMax stimmte zu, mit einer Einschränkung. Kosten seien "im Sommer das große Thema" gewesen, sagte er, doch entscheidend für die Teams sei, wie gut ein Modell in einer bestimmten Domäne abschneide, etwa im Rechts- oder Gesundheitswesen. Immer mehr Teams würden offene Modelle dafür feinabstimmen und nachtrainieren. Kosten spielten weiterhin eine Rolle, merkte er an und verwies auf öffentliche Nutzungsdaten von OpenRouter und OpenCode, in denen schnelle, günstige Flash-Modelle vorne liegen.
In Systemen denken, nicht in Modellen
Yunmo Koo von Friendli AI beschrieb die größte Veränderung für Teams in der Produktion als Wechsel "vom modellzentrierten zum systemzentrierten Denken". In Experimenten prüfe ein Team die Model Card, binde das Modell in ein Coding-Tool ein und schaue, ob es eine Aufgabe bewältigt. In der Produktion laute die Frage, ob das Modell eine komplexe Agent-Pipeline zuverlässig und innerhalb der Latenz- und Kostenbudgets abschließen kann.
Er nannte ein Beispiel: Ein Endpunkt mit 95 Prozent Zuverlässigkeit sinkt über eine Agentenkette mit zehn Schritten auf rund 60 Prozent Zuverlässigkeit Ende-zu-Ende. Sein Rat: Erfolg solle für den gesamten Workflow definiert werden, nicht für einen einzelnen Aufruf.
Koo warnte zudem, dass offene Gewichte nicht automatisch bessere Wirtschaftlichkeit oder Leistung bringen. Teams übernähmen die Verantwortung für Modellauswahl und Inferenz-Konfiguration, und ein Inferenzanbieter könne einen Teil dieser Last tragen. Su-Ortiz ergänzte, die Kosten pro Token seien nützlich, am wichtigsten seien aber interne Benchmarks für die eigenen Anwendungsfälle.
Long-Horizon-Agenten und die Engine-Ebene
Su-Ortiz sagte, MiniMax habe das Design zwischen den Serien M2 und M3 verändert, um Long-Horizon-Aufgaben deutlich stärker zu gewichten. Kontextfenster mit einer Million Token seien inzwischen Standard, weil Agenten über viele Runden hinweg wiederholt Prompts senden. Er schilderte, wie sich seine eigene Gewohnheit gewandelt habe: Früher sei er unter 30 Prozent des Kontextfensters geblieben, heute gehe er bis auf 70 bis 80 Prozent. Um diese Last zu bewältigen, setzt MiniMax auf eine Sparse-Architektur und eigene KV-Cache-Optimierungen.
Koo sagte, Labore entwickelten heute Intelligenz und Effizienz gemeinsam, mit hybrider Attention, Cache-Kompression und Sparse Indexing. Doch "theoretische Verbesserungen in der Architektur schlagen sich nicht immer in realem Nutzen nieder". Lineare Attention etwa nutze keinen herkömmlichen KV-Cache, und ohne Engine-Arbeit, die auf die Zustandsverwaltung zugeschnitten ist, könne sie die Inferenz sogar verlangsamen. Modell-Labore und Inferenzanbieter müssten deshalb eng zusammenarbeiten.
Sicherheit, Hybridbetrieb und die menschliche Ebene
Messer sagte, offene Gewichte gäben Unternehmen mehr Kontrolle, aber auch mehr Verantwortung. Die Anforderungen unterschieden sich je nach Kunde, doch Sicherheitstests und Red-Teaming kämen immer wieder zur Sprache, und Teams müssten sowohl das Modell als auch das Verhalten des Agenten testen, sobald dieser Zugriff darauf hat. Anaconda tut das gemeinsam mit Enkrypt AI, das es in diesem Jahr übernommen hat.
Außerdem beschrieb er wachsendes Interesse an lokaler KI, etwa ein Modell für private Arbeit auf dem Laptop zu betreiben und die Sitzung später in eine gemeinsame Cloud-Umgebung zu verlagern. Er räumte offen ein, dass Hybrid bislang eher Vision als etabliertes Muster sei.
Auf die Frage, was Teams erfolgreich macht, verwies Messer auf die Menschen. Einzelne gingen oft davon aus, dass Fehler wie fehlgeschlagene Tool-Aufrufe ihre eigene Schuld seien, und teilten sie nicht. Die erfolgreichsten Teams, die er sehe, teilten Erfolge und Misserfolge über Gruppen hinweg.
Tipps für den ersten produktiven Agenten
Zum Abschluss gab das Panel praktische Hinweise für Teams, die ihren ersten produktiven Agenten auf offenen Modellen bauen:
- Mit einem Flash-Modell starten. Messer sagte, diese hätten sich rasch weiterentwickelt und seien effizient.
- Spezialisieren. Su-Ortiz empfahl, mit Laboren und Anbietern bei Feinabstimmung, Post-Training oder On-Prem-Anforderungen für eine bestimmte Domäne zusammenzuarbeiten.
- Evals und Observability in jeden Schritt einbauen. Koo sagte, so ließen sich Modelle und Anbieter bei Veränderungen schnell vergleichen.
- Erfolg für den gesamten Workflow definieren. Zuverlässigkeit, Latenz, Durchsatz und Kosten Ende-zu-Ende erfassen.
- Erkenntnisse teilen. Fehler bei Tool-Aufrufen und seltsame Traces sind Teamwissen, keine persönlichen Fehler.
Für Teams, die Open Weights abwägen, lautet die Botschaft des Panels: Das Modell ist nur ein Teil der Entscheidung. Ob ein Agent in der Produktion funktioniert, hängt von der Inferenz-Konfiguration, der Evaluation anhand der eigenen Workloads und dem geteilten Wissen in der Organisation ab.
Kilo Code: Open Weights Are Ready for Production. Is Your Stack?