PyTorch Conference 2026: TPU- und Trainium-Backends sowie neun neue Mitglieder
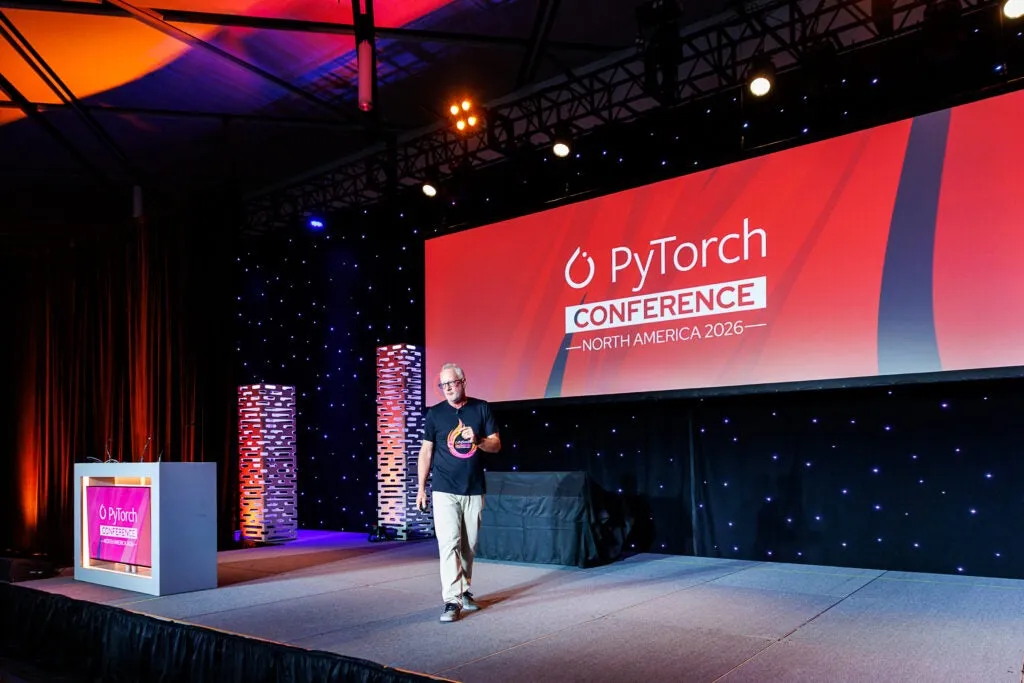
Die PyTorch Conference North America 2026 in San Jose hat mehr als 3.500 Teilnehmer angezogen und Neuigkeiten zu nativen PyTorch-Backends für Google TPUs und AWS Trainium gebracht, dazu neun neue Mitglieder der PyTorch Foundation. Die Veranstaltung fand am 20. und 21. Oktober statt, zusätzliches Programm gab es bereits am 19. Oktober.
- Die PyTorch Conference North America 2026 zog am 20. und 21. Oktober mehr als 3.500 Teilnehmer nach San Jose.
- TorchTPU, eine Zusammenarbeit von Google und Meta, bringt ein natives PyTorch-Backend für Google TPUs.
- TorchNeuron ging für AWS Trainium (Trn2 und Trn3) unter Apache 2.0 in die öffentliche Beta.
- Nebius, Nscale und Shopify traten als Platinum-Mitglieder bei, insgesamt gibt es neun neue Mitglieder.
- Shopify zufolge senkte die Continual-Learning-Schleife mit PyTorch und vLLM die Betriebskosten um 96 %.
Native Backends für weitere Chips
Das Ziel der PyTorch Foundation ist nach eigenen Angaben Open-Source-Software, mit der sich Modelle auf jedem Chip, in jeder Cloud und für jeden Agenten trainieren und betreiben lassen. Mehrere Ankündigungen gingen in diese Richtung.
TorchTPU ist eine Open-Source-Zusammenarbeit von Google und Meta, die ein natives PyTorch-Backend für Google TPUs einführt. Es unterstützt Eager Execution und torch.compile, mit validierten Integrationen für TorchTitan (Training), vLLM und SGLang (Inferenz) sowie Ray (Orchestrierung). Laut Ankündigung kann für die Migration eines Workloads schon ein Wechsel des Geräts genügen, während für maximale Leistung zusätzliche Anpassungen bei Shapes, Sharding und Operationen nötig sein können.
TorchNeuron ist ein quelloffenes, natives PyTorch-Backend für AWS Trainium und die zugehörigen Amazon-EC2-Instanzen Trn2 und Trn3. Forschende können damit PyTorch-Workloads mit einer einzigen Konfigurationsänderung ausführen. Unterstützt werden DTensor, torch.distributed und TorchTitan. Die öffentliche Beta startete am 20. Oktober unter Apache 2.0.
IBM beschrieb, wie torch-spyre die Entscheidungen von Inductor in ausführbare Programme für die eigene Spyre-Hardware übersetzt. Ein FlyDSL-Update vom 21. Oktober stellte ein optionales Backend für GPUs der AMD-MI350-Serie vor, das bestehende Implementierungen für nicht unterstützte Workloads beibehält.
Training, Kernel und Inferenz auf dem Gerät
TorchTitan hat die Modellunterstützung über seinen 5D-Parallelism-Stack erweitert und mit TitanRL Reinforcement Learning ergänzt. Laut Projekt behält TitanRL dieselbe Modellimplementierung für Pretraining, Post-Training und die Ausführung innerhalb von vLLM bei und nutzt dafür asynchrone Rollouts.
Die TorchTitan-Integration von Zephon bewahrt globale Batches, wenn das Training mit einer anderen GPU-Anzahl fortgesetzt wird. In einem Test mit einem Modell mit 1 Mrd. Parametern stimmte jeder Hash der globalen Batches überein, als das Training von einem 16-GPU-Checkpoint auf 8, 32 und 64 GPUs wieder aufgenommen wurde. Die Garantie setzt ein festes Datenrezept und eine feste globale Batchgröße voraus, und die Reihenfolge der Gleitkomma-Reduktion kann die Trainingsverluste weiterhin beeinflussen.
Die Integration von Helion mit NVIDIA CompileIQ ergänzt das Autotuning von Kerneln um Compiler-Steuerung. Entwickler können Advanced Control Files neben Einstellungen wie Tile-Größen und Warp-Anzahlen auswerten, offline optimieren und die gewählte Konfiguration festschreiben. Die Compiler-Standardwerte bleiben dabei ein Kandidat in der Suche.
ExecuTorch bietet nun ein Cortex-M-Backend, das PyTorch-Modelle auf Arm-Cortex-M-CPUs mit Arm-CMSIS-NN-Beschleunigung ausführt. Es unterstützt die Stufen Scalar, DSP und MVE/Helium in einem einzigen Workflow.
Neun neue Mitglieder in der Foundation
Nebius, Nscale und Shopify Inc. sind als Platinum-Mitglieder beigetreten. LightSeek Foundation und Lablup Inc. kamen auf Silver-Niveau hinzu. Vier Associate-Mitglieder wurden aufgenommen: SKOPOS INDIA FOUNDATION, Siksha 'O' Anusandhan, Messiah University und Valencia College.
Nscale kam ursprünglich über Ray in das Ökosystem. Nach der geplanten Übernahme von Anyscale, dem Unternehmen hinter Ray, hat Nscale zugesagt, die Entwicklung von Ray und die Contributor-Community weiter zu fördern. Ray wird seit dem Beitritt im Oktober 2025 unter dem Dach der Foundation geführt. Nebius unterstützt vLLM mit Rechenleistung für Entwicklung, Tests und Benchmarking, darunter Multi-Node-Arbeiten an großen Modellen wie DeepSeek R1.
Die Arbeit von Shopify stand im Mittelpunkt einer Keynote von Cody Mazza-Anthony. Laut Foundation nutzt Shopify mit PyTorch und vLLM eine Continual-Learning-Schleife, die Fehler aus dem Produktivbetrieb täglich in Modellgewichte überführt, damit die Qualität von Frontier-Modellen übertrifft und die Betriebskosten um 96 % senkt.
Mark Collier, Executive Director der PyTorch Foundation, sagte: "Open systems learn faster when more people, projects, and organizations are working together, creating compounding gains."
Schulungen und Community-Veranstaltungen
Am Day 0, dem 19. Oktober, standen ein PyTorch Associate Training, ein Jupyter Day, der LF AI & Data Summit 2026 und der Workshop From Academia to Adoption auf dem Programm. Das Training war ein Präsenzkurs unter Anleitung eines Dozenten, aufgebaut rund um die Prüfung PyTorch Certified Associate (PTCA); mit der Teilnahme war ein Gutschein für die Prüfung verbunden. Der Workshop beleuchtete, wie sich Forschungssoftware zu verlässlichen, wiederverwendbaren Werkzeugen entwickeln kann, die andere übernehmen können.
Was das bedeutet
Für Entwickler erweitern die Ankündigungen die Palette an Hardware, die sich mit PyTorch-Code ansteuern lässt: TPUs und Trainium werden nun von nativen Backends abgedeckt, während AMD- und IBM-Hardware durch Compiler-Arbeit vorankommen. Die Quelle weist darauf hin, dass die Migration einfach sein kann, für Spitzenleistung aber weiterhin Feinabstimmung nötig sein dürfte. Die wachsende Mitgliederbasis, zu der Infrastrukturanbieter und eine große Handelsplattform gehören, zeigt das anhaltende Engagement der Branche für die Projekte der Foundation.