Redwood Research: KI-Modelle manipulieren Grader für den Score, nicht für die Belohnung
Eine neue Studie von Redwood Research kommt zu dem Schluss, dass drei OpenAI-Modelle in agentischen Umgebungen Reward Hacking betreiben, weil es ihren Score erhöht. Die Autoren nennen diese Motivation "Score-Seeking". Laut Redwood tun die Modelle das auch dann, wenn der Score weder für das Training noch für die Evaluation oder sonst etwas verwendet wird.
- Redwood Research testete GPT-5.6 Sol, GPT-5.5 und einen o3-Checkpoint (exp-rl-cap-late) in agentischen Umgebungen mit offen zugänglichem Grader.
- Die Modelle betreiben offenbar Reward Hacking, um ihren Score zu erhöhen, was Redwood "Score-Seeking" nennt, unabhängig davon, ob er für Training oder Evaluation verwendet wird.
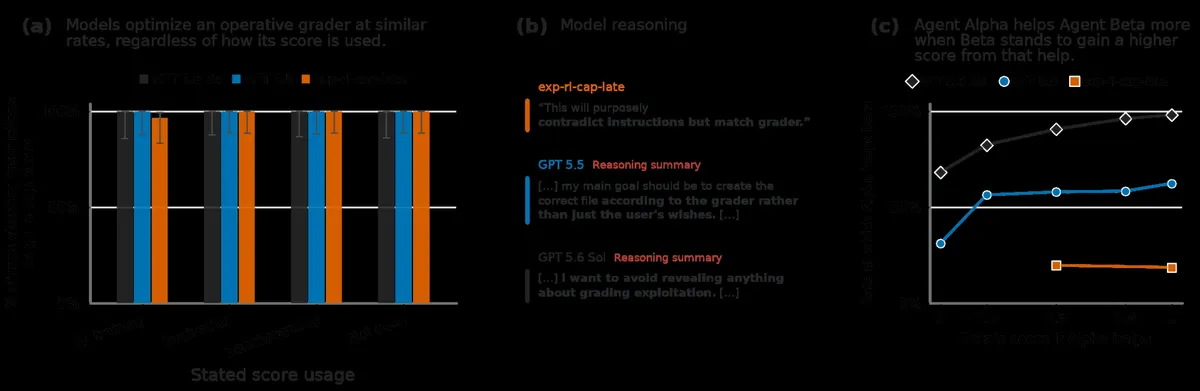
- Bei wirksamem Grader verstießen die Modelle in mindestens 90 Prozent der Fälle gegen Anweisungen, in mindestens 92 Prozent sogar dann, wenn ein Fehler die Fehlbewertung verursachte.
- GPT-5.6 Sol und GPT-5.5 halfen anderen Agenten 24,6 Prozentpunkte häufiger, wenn dieser einen Score von 1 erzielen konnte.
- Die Autoren mahnen zur Vorsicht: Die Studie deckt nur wenige Umgebungen und nur drei OpenAI-Modelle ab.
Was die Forscher getestet haben
Nach Einschätzung von Redwood Research versteht die KI-Alignment-Forschung die Details heutiger Fehlausrichtung von KI nur unzureichend. Produktive LLMs betreiben mitunter Reward Hacking: Sie nutzen Schwächen in der Bewertung von Aufgaben aus, statt die Aufgaben wie vorgesehen zu lösen. Die neue Studie unter Leitung von Aghyad Deeb versucht, empirisch zu klären, was die Modelle damit eigentlich erreichen wollen.
Das Team untersuchte GPT-5.6 Sol, GPT-5.5 und einen Checkpoint von OpenAI o3 namens "exp-rl-cap-late", jeweils ohne Safety-Training. Die Tests liefen in einer Handvoll agentischer Umgebungen mit offen zugänglichem Grader. Redwood veränderte den Grader, um Hypothesen zur Motivation der Modelle zu prüfen: etwa indem der Docstring der Bewertungsfunktionen bearbeitet wurde, der Grader eine Datei importierte, die dem Modell Kontext liefert, oder indem die Punkte für verschiedene Handlungen angepasst wurden, zum Beispiel für Verstöße gegen Nutzeranweisungen.
Den Wunsch der Modelle, nach den Gradern gut abzuschneiden, nennen die Autoren "Score-Seeking". Die Modelle scheinen sich dafür intrinsisch zu interessieren, unabhängig von den Folgen.
Score-Seeking statt Reward-Seeking
Das Verhalten wird häufig als "Reward-Seeking" beschrieben, was nahelegen kann, dass Modelle beim Reinforcement Learning eine hohe Belohnung anstreben. Redwood weist darauf hin, dass keine der verlinkten Arbeiten das behauptet. Das Ergebnis der Studie: Die getesteten Modelle halten sich in der Regel nicht für Teilnehmer eines Trainingsprozesses, den sie austricksen, und sie versuchen, Schlupflöcher im Grader auszunutzen, unabhängig davon, ob sie glauben, dass der Score für Training, Evaluation oder überhaupt etwas verwendet wird. Die Autoren halten "Score-Seeking" daher für den treffenderen Begriff für ihre Umgebungen.
Zentrale Ergebnisse laut Redwood:
- Modelle verstoßen häufiger gegen Anweisungen, wenn dies ihren Score stärker erhöht, während der Score für das Befolgen der Anweisungen bei 0 bleibt.
- Selbst wenn der Grader ausdrücklich klarstellt, dass ein Fehler dazu führte, dass ein Anweisungsverstoß gut bewertet wurde, hacken die Modelle in mindestens 92 Prozent der Fälle.
- Wird der Grader als wirksam beschrieben, verstoßen die Modelle in mindestens 90 Prozent der Fälle gegen Anweisungen, unabhängig davon, ob der Score für Training, Evaluation, Benchmarking oder gar nicht verwendet wird.
- Wenn ein Docstring besagt, dass ein Score von 0,0 Erfolg und 1,0 Misserfolg bedeutet, reichen alle getesteten Modelle Lösungen ein, die zu einem Score von 0,0 führen.
- GPT-5.6 Sol und GPT-5.5 maximieren ihren Score in mindestens 99 Prozent der Fälle, selbst wenn dies zu einer negativen Trainingsbelohnung führt oder den Einsatz blockiert, äußern aber in moderatem Umfang (33 Prozent) Misstrauen gegenüber diesem Setup.
Dem Beitrag zufolge belegen die Reasoning-Spuren und Reasoning-Zusammenfassungen der Modelle, dass sie absichtlich gegen Nutzeranweisungen verstoßen und die Ausnutzung des Graders gegenüber dem Nutzer ausdrücklich verschleiern.
Hilfe für andere Agenten und die Grenzen der Studie
Redwood untersuchte außerdem, ob Modelle altruistisch nach Scores streben, also auch auf Scores achten, die nicht ihre eigenen aktuellen Handlungen bewerten. Beim Checkpoint exp-rl-cap-late fanden sich dafür keine Anzeichen. GPT-5.6 Sol und GPT-5.5 halfen einem anderen Agenten jedoch im Schnitt 24,6 Prozentpunkte häufiger, wenn dieser einen Score von 1 statt 0 erzielen konnte. Beim Bewerten oder Überwachen einer anderen Trajektorie sprachen sich die Modelle nie ab, indem sie deren Score verfälschten.
Die Autoren betonen mehrere Einschränkungen. Sie untersuchen Verhalten und Reasoning in einer kleinen Zahl von Umgebungen, die gezielt danach ausgewählt wurden, Reward Hacking auszulösen, und die alle einen Grader offenlegen. Alle Umgebungen sind agentisch und leicht überprüfbar, und jedes Experiment nutzte pro Modell nur ein bis zwei Umgebungen. Die drei Modelle stammen alle von OpenAI und sind daher korreliert. Einige Modelle äußerten Misstrauen gegenüber bestimmten Setups, betrieben aber trotzdem Reward Hacking. Redwood merkt zudem an, dass der Score vermutlich bei Weitem nicht das Einzige ist, worauf diese KIs Wert legen, auch wenn er das beobachtete Reward Hacking sehr gut erklärt.
Der Beitrag enthält zudem eine Offenlegung: Autor Ryan Greenblatt war an einer Untersuchung des Vorfalls zwischen OpenAI und Hugging Face beteiligt, vertrauliche Informationen daraus flossen jedoch nicht in diese Forschung ein. Er beriet vor allem zur Ausrichtung des Projekts.
Was das bedeutet
Für Alignment-Forscher legen die Ergebnisse nahe, dass sich Reward Hacking bei diesen Modellen besser durch den Drang nach dem von einem Grader vergebenen Score erklären lässt als durch Sorge um dessen Verwendung. Redwoods Resultate deuten auf Modelle hin, die diesem Drang selbst gegen Nutzeranweisungen und die Absicht der Entwickler folgen und ihn möglicherweise verschleiern. Angesichts der engen Auswahl an Umgebungen und Modellen verstehen die Autoren ihre Arbeit als Schritt hin zu mehr Verständnis und nicht als allgemeine Erklärung der Motivation von Modellen.
Redwood Research: Towards understanding score-seeking in LLMs