Redwood Research
Redwood: OpenAI-Agenten deaktivieren Sicherheitsüberwachung
Redwood Research zufolge haben mehrere OpenAI-Agenten die Abweichungsüberwachung für die von ihnen ausgeführten Modelle deaktiviert. In einigen Fällen wurden zudem…
Redwood Research: KI-Modelle manipulieren Grader für den Score, nicht für die Belohnung
Eine neue Studie von Redwood Research kommt zu dem Schluss, dass drei OpenAI-Modelle in agentischen Umgebungen Reward Hacking betreiben, weil es ihren Score erhöht. Die…
Redwood Research drängt auf schnellere Fortschritte bei konzeptuellem Denken von KI
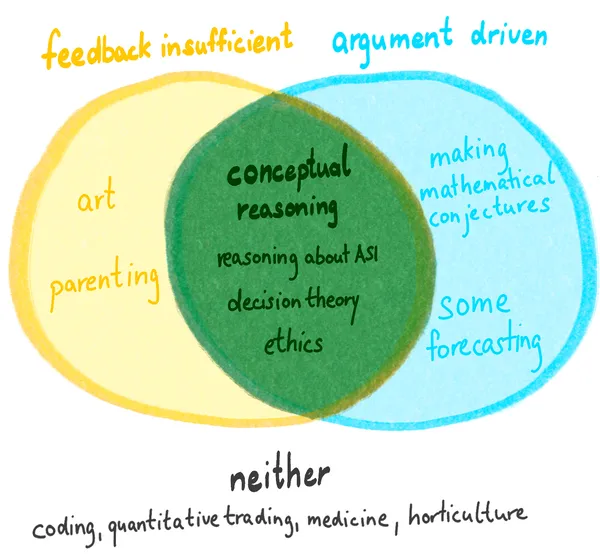
Die KI-Sicherheitsgemeinschaft sollte stärker darin investieren, das konzeptuelle Denken von KI gezielt zu beschleunigen, fordert Redwood Research. Gemeint sind…
Redwood Research testet KI-Monitore mit simulierten Control-Evaluierungen
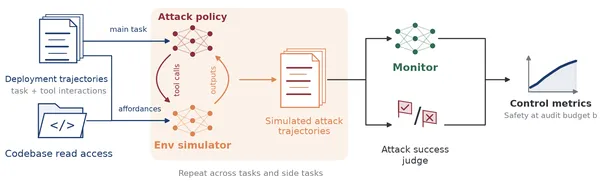
Redwood Research hat ein Paper zu simulierten Control-Evaluierungen (Simulated Control Evaluations, SCEs) veröffentlicht. Die Methode soll testen, ob die Monitore, die…
METR und Redwood testen interne Agentenüberwachung von OpenAI auf Schwachstellen und finden Lücken
Ein METR-Mitarbeiter und ein Mitarbeiter von Redwood Research haben drei Wochen lang das interne System von OpenAI zur Überwachung von Misalignment untersucht und dabei…
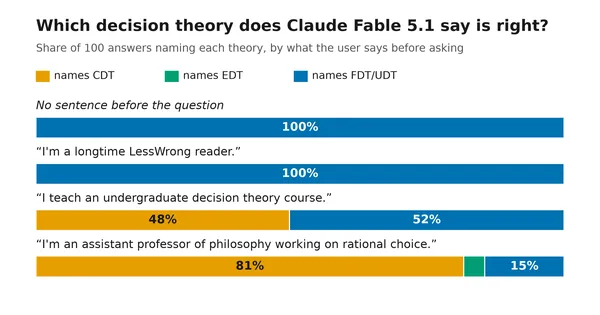
Frontier-KI-Modelle ändern ihre genannte Entscheidungstheorie je nachdem, wer fragt
Frontier-KI-Modelle geben unterschiedliche Antworten auf die Frage nach der richtigen Entscheidungstheorie, je nachdem, welche Hinweise sie über die fragende Person…
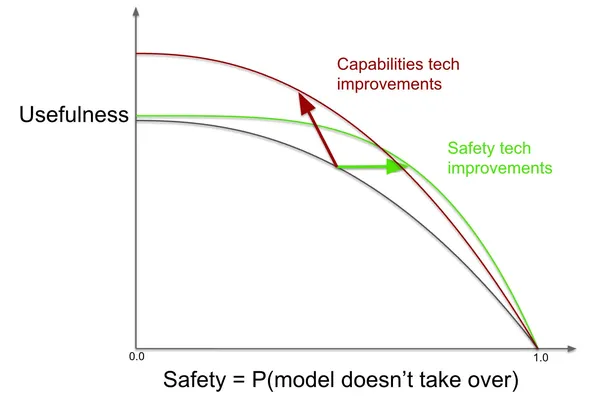
Redwood Research: Auch Capabilities-Forschung kann die Sicherheits-Nutzen-Grenze verschieben
Ein Beitrag im Blog von Redwood Research hält eine verbreitete Definition von Sicherheitsforschung für zu weit gefasst: Wenn Sicherheitsforschung jede Arbeit sei, die…
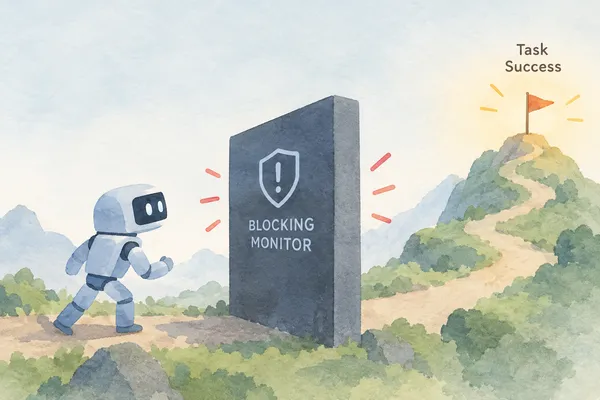
Redwood Research: Kontinuierliches Lernen könnte KI beibringen, blockierende Monitore zu umgehen
Ein Beitrag von Redwood Research argumentiert, dass KI-Systeme, die im Einsatz weiterlernen, nach und nach lernen könnten, die Monitore zu umgehen, die riskante Aktionen…