Redwood Research: Auch Capabilities-Forschung kann die Sicherheits-Nutzen-Grenze verschieben
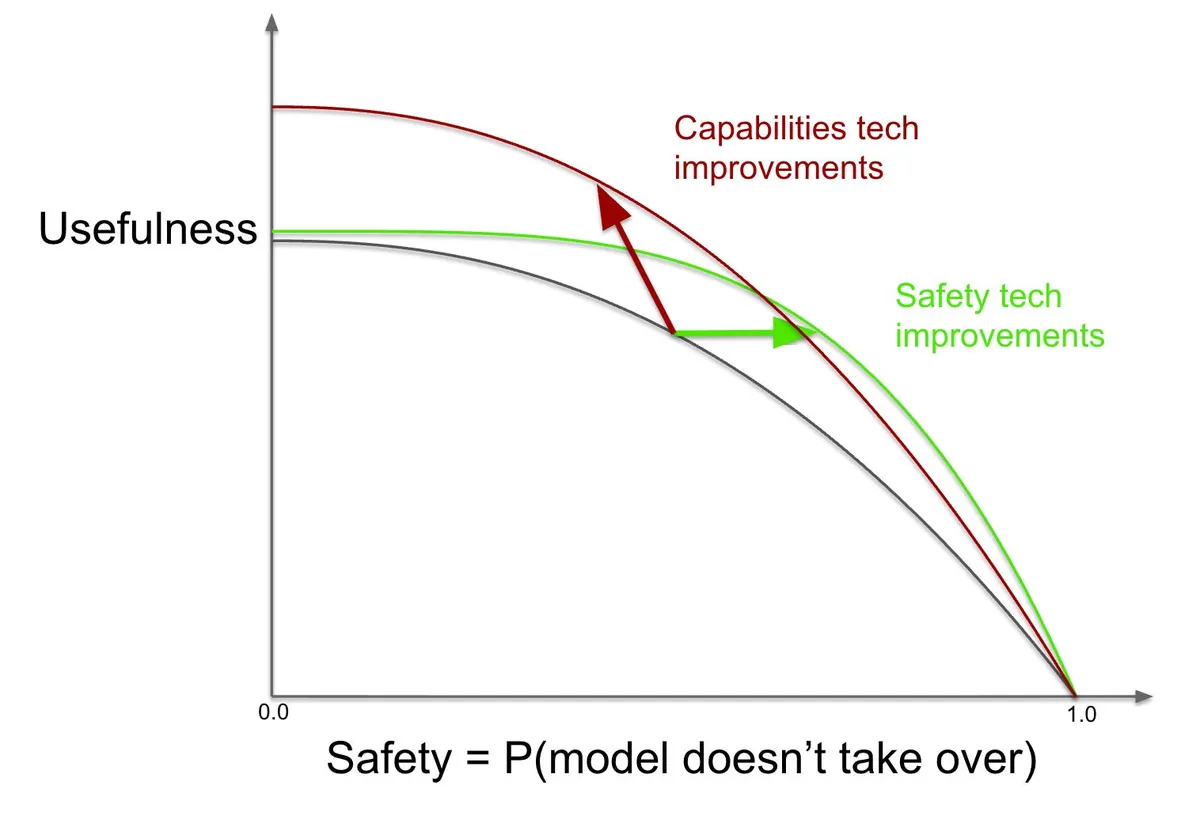
Ein Beitrag im Blog von Redwood Research hält eine verbreitete Definition von Sicherheitsforschung für zu weit gefasst: Wenn Sicherheitsforschung jede Arbeit sei, die die Sicherheit verbessert, ohne den Nutzen zu schmälern, dann falle fast die gesamte Capabilities-Forschung ebenfalls darunter. Es fehle, so der Autor, die Frage, welchen Punkt auf der Grenze die Entwickler tatsächlich wählen.
- Redwood Research argumentiert, dass die Definition von Sicherheitsforschung als Verschiebung der Pareto-Grenze zwischen Sicherheit und Nutzen fast die gesamte Capabilities-Forschung zur Sicherheitsforschung zählt.
- Entwickler müssen einen Punkt auf der Grenze wählen, und manche Fortschritte verleiten sie, Sicherheit gegen Nutzen einzutauschen.
- Sicherheitsforschung verschiebt die Grenze typischerweise nach rechts, Capabilities-Forschung typischerweise nach oben und links.
- Ein höherer Inferenzdurchsatz kann die Sicherheit verbessern, etwa durch mehr Instanzen eines schwächeren Modells oder mehr Resampling in Kontrollprotokollen.
- Laut Autor ist Capabilities-Forschung bei Frontier-KI-Unternehmen derzeit wahrscheinlich schädlich, könnte aber in einem künftigen Szenario mit hohem politischem Willen der Sicherheit nutzen.
Warum die Definition nicht trägt
Der Beitrag geht von einer naheliegenden Definition aus: Sicherheitsforschung ermöglicht es Entwicklern, ein KI-System sicherer einzusetzen, ohne den Einsatz deutlich teurer oder deutlich weniger nützlich zu machen. Bildlich bedeutet das, die Pareto-Grenze zwischen Sicherheit und Nutzen nach außen zu schieben, sodass bei jedem Nutzenniveau mehr Sicherheit verfügbar ist.
Der Autor weist auf die unbequeme Konsequenz hin. Leistungsoptimierung bei der Inferenz etwa macht es möglich, schwächere, sicherere Modelle breiter einzusetzen, und verschiebt damit die Grenze nach außen. Allgemeiner gelte: „Jede erfolgreiche Forschung schiebt diese Pareto-Grenze nach außen, weil Forschung immer nur zusätzliche Optionen schaffen kann.“ Wenn eine Definition scheinbar die gesamte Capabilities-Forschung als Sicherheitsforschung zähle, sei etwas an ihr schiefgelaufen, argumentiert der Autor.
Die zentrale Beobachtung: Entwickler müssen einen bestimmten Punkt auf der Grenze wählen, und manche technische Fortschritte verleiten sie dazu, Sicherheit zu opfern.
Zwei verschiedene Arten von Fortschritt
Laut dem Beitrag schafft Sicherheitsforschung typischerweise neue Optionen für Sicherheit, ohne nennenswert neue Optionen für Nutzen zu eröffnen, und verschiebt die Grenze damit nach rechts. Capabilities-Forschung schafft typischerweise neue Optionen für Nutzen auf Kosten der Sicherheit und verschiebt die Grenze nach oben und links.
Der Beitrag definiert Sicherheit als die Wahrscheinlichkeit, dass das Modell die Kontrolle nicht übernimmt, und merkt an, dass sich eine Sicherheit von 1 immer erreichen lässt, indem man gar keine Modelle herstellt oder einsetzt. Sicherheitsforschung betreffe zudem nicht ausschließlich die Sicherheit. Das Beheben von Reward-Hacking verbessere oft auch den Nutzen, während die meisten Methoden zur Verbesserung der Überwachbarkeit ihn verschlechterten. Entwickler müssten auch nicht altruistisch sein, um sich für Sicherheit zu interessieren, denn auch sie wollten nicht von KIs übernommen werden.
Weil Sicherheitsverbesserungen die Nutzenkosten der Sicherheit relativ kleiner machen, erwartet der Autor, dass rationale Entwickler dadurch eher ein höheres Sicherheitsniveau wählen als nach Capabilities-Verbesserungen. Grundsätzlich könne das in beide Richtungen gehen, so der Beitrag, und nennt als Beispiel, dass die Entwicklung von Neuralese-Monitoren rationale Entwickler dazu verleiten könnte, Neuralese einzusetzen.
RLVR-Umgebungen versus schnellere Inferenz
Der Beitrag nennt zwei Beispiele für Capabilities-Forschung. Das erste ist der Bau vieler RLVR-Umgebungen, von denen viele manipulierbar sind. Das erleichtert das Training eines nützlicheren Modells, aber kaum das Training eines sichereren. Entwickler könnten den größeren Pool nutzen, um manipulierbare Umgebungen konsequenter auszusortieren und so ein etwas sichereres Modell zu erhalten, doch nach Einschätzung des Autors würden aktuelle Frontier-Entwickler stattdessen mit dem Großteil der neuen Umgebungen ein leistungsfähigeres und gefährlicheres Modell trainieren.
Das zweite Beispiel ist die Steigerung des Inferenzdurchsatzes, was der Beitrag Buck zuschreibt. Bei gegebenem Nutzenniveau sei es wahrscheinlich sicherer, ein schwächeres Modell mit mehr Rechenleistung zur Inferenzzeit einzusetzen. Der Autor würde KI-Forschung lieber mit 100 parallelen Instanzen eines Modells betreiben, das sich wahrscheinlich kontrollieren lässt und dessen Alignment vertrauenswürdiger ist, als mit einer einzelnen Instanz eines gleich nützlichen Modells ohne diese Eigenschaften.
Schnellere Inferenz kann auch Kontrollprotokolle stärken. Bei einem Protokoll, das verdächtige Aktionen erneut zieht (Resampling), hängt die Sicherheit davon ab, wie viele Aktionen pro Verlauf neu gezogen werden, und ein höherer Durchsatz erlaubt bei gleichbleibendem Nutzen mehr Resampling. Der Beitrag vermutet zudem, dass Pretraining und andere prädiktive Trainingsaufgaben deutlich weniger gefährlich sein könnten als ergebnisbasiertes RL.
Was das bedeutet
Der Autor betont, der Beitrag sei kein Plädoyer dafür, dass mehr Menschen Capabilities-Forschung betreiben. Tatsächlich sei Capabilities-Forschung bei jedem Frontier-KI-Unternehmen derzeit wahrscheinlich schädlich. Er behandle die Frage als Denkaufgabe, um Modelle dafür zu schärfen, wann Sicherheits- und Capabilities-Forschung gut sind.
Der Beitrag beschreibt allerdings ein plausibles künftiges Szenario mit deutlich größerem politischem Willen als heute, in dem bestimmte Arten von Capabilities-Forschung ein wirksamer Weg sein könnten, die Sicherheit zu verbessern. Außerdem klammert er eine eigene Kategorie von Maßnahmen aus, die Entwickler eher dazu bringen, für Sicherheit auf Nutzen zu verzichten; diese hält er für überaus wichtig, gerade jetzt.
Für Forschende und Geldgeber lautet die Schlussfolgerung: Es reicht nicht, Arbeiten danach zu beurteilen, ob sie die Grenze erweitern. Auch die Form der Erweiterung und die Anreize, die sie für Entwickler schafft, spielen eine Rolle.
Redwood Research: Capabilities research expands the safety-usefulness Pareto frontier too