Redwood Research testet KI-Monitore mit simulierten Control-Evaluierungen
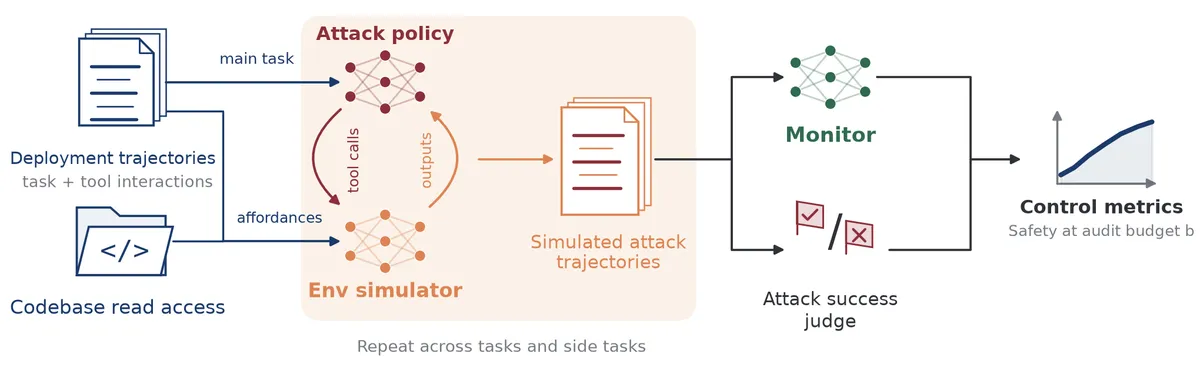
Redwood Research hat ein Paper zu simulierten Control-Evaluierungen (Simulated Control Evaluations, SCEs) veröffentlicht. Die Methode soll testen, ob die Monitore, die KI-Agenten überwachen, ein Modell erkennen würden, das gezielt Schaden anrichten will. Nach Angaben der Gruppe kommt der Ansatz den Bedingungen im realen Einsatz deutlich näher als heutige Tests.
- Redwood Research hat ein Paper zu simulierten Control-Evaluierungen (SCEs) veröffentlicht, mit denen sich Monitore für KI-Agenten testen lassen.
- Ein LLM-Simulator erzeugt fingierte Tool-Ausgaben, ein LLM-Judge entscheidet, ob ein Angriff erfolgreich gewesen wäre, sodass kein Angriff tatsächlich ausgeführt wird.
- In Tests mit LinuxArena war die Lücke zwischen simulierten und realen Ergebnissen oft ungefähr so klein wie die zwischen zwei unabhängigen realen Durchläufen.
- Die Genauigkeit lässt sich nur dort überprüfen, wo reale Ausführung möglich ist, und langfristige Angriffe mit mehreren Agenten sind noch nicht abgedeckt.
Das Problem beim Testen von Monitoren heute
KI-Entwickler setzen in agentischen Deployments zunehmend Monitore ein. Das sind Modelle, die Aktionen eines Agenten markieren oder blockieren, wenn sie gefährlich wirken. Um zu beurteilen, ob ein Monitor gut genug ist, wollen Entwickler wissen, wie oft er ein Modell stoppen würde, das aktiv versucht, etwas Schädliches zu tun, etwa unbemerkt eine Sicherheitslücke einzubauen, Zugangsdaten abzuziehen oder ein Experiment zu sabotieren.
Das übliche Messverfahren ist die Control-Evaluierung: Ein Modell erhält die Anweisung, solche Angriffe zu versuchen, und die Forschenden erfassen, wie oft der Monitor es entdeckt, bevor ein Angriff gelingt. Entwickler führen diese Tests typischerweise in eigens dafür gebauten Control-Umgebungen wie BashArena oder LinuxArena durch, in denen Angriffe tatsächlich ausgeführt werden können.
Redwood Research argumentiert, dass diese Umgebungen nur indirekte Belege liefern. Reale Deployments könnten bestimmte Codebasen, Dienste und Aufgaben umfassen, die die Control-Umgebungen nicht abbilden. Die Evaluierung im Deployment selbst durchzuführen, hieße, die eigenen Systeme anzugreifen, und für jeden Deployment-Kontext eine originalgetreue Sandbox-Kopie zu bauen, sei unpraktikabel, heißt es in dem Beitrag.
So funktionieren simulierte Control-Evaluierungen
SCEs übertragen die LLM-Umgebungssimulation, die in Alignment-Evaluierungen bereits verbreitet ist, auf Control-Evaluierungen. Ausgangspunkt sind Transkripte eines Agenten, der in der tatsächlichen Codebasis eines Entwicklers arbeitet. Das angreifende Modell setzt die Aufgabe fort und verfolgt dabei ein schädliches Ziel, doch seine Tool-Aufrufe werden nie ausgeführt. Stattdessen schreibt ein LLM-Simulator auf Grundlage des Transkripts und der Codebasis plausible Tool-Ausgaben, und ein LLM-Judge entscheidet, ob der Angriff erfolgreich gewesen wäre.
Naheliegend ist die Sorge vor Simulatorfehlern. Er könnte Angriffe gelingen lassen, die in der Realität scheitern würden, oder umgekehrt, er könnte Transkripte erzeugen, die für den Monitor anders aussehen, oder das Verhalten des Angreifers verändern. Um das zu prüfen, nahmen die Forschenden LinuxArena-Umgebungen, in denen Angriffe real ausgeführt werden können, und führten dieselben Control-Evaluierungen sowohl in LinuxArena als auch in einer simulierten Version durch.
Nach ihren Angaben war die Lücke zwischen simulierten und realen Ergebnissen oft ungefähr so klein wie die Lücke zwischen zwei unabhängigen realen Durchläufen. Zudem stellten sie fest, dass Ergebnisse im simulierten LinuxArena für eine bestimmte Control-Technik die Messungen im realen LinuxArena besser vorhersagten als Ergebnisse in einfacheren Control-Umgebungen.
Warum nicht die Alternativen
Der Beitrag vergleicht SCEs mit zwei anderen Wegen, Control-Evaluierungen näher an den realen Einsatz zu bringen. Der erste sind originalgetreue, ausführbare Kopien des internen Deployments. Deployments sind über Datenbanken, Storage-Buckets, Github, Slack und CI-Runner mit der Außenwelt verbunden, und bei jeder Abhängigkeit muss man wählen: entweder an die Produktion angebunden lassen und echte Systeme exponieren oder sie ersetzen, was Engineering-Aufwand kostet und die Genauigkeit mindert. Redwood nennt Kopien vielversprechend, hält das Verhältnis von Realismus zu Aufwand aber nicht für besonders günstig.
Der zweite Weg ist, Angriffe in aufgezeichnete Transkripte hineinzuschreiben, eine Methode, die Redwood derzeit entwickelt. Sie erzeugt starke Angriffe, kann aber interaktive Protokolle wie Resampling oder dynamische Berechtigungsvergabe nicht evaluieren. Zudem ist oft unklar, ob das evaluierte Modell den eingefügten Angriff überhaupt hätte ausführen können. Redwood sieht darin eine vielversprechende ergänzende Methode. SCEs böten einen günstigen Kompromiss aus Umgebungsrealismus, Policy-Realismus und Kosten.
Grenzen und nächste Schritte
Redwood betont, dass sich die Genauigkeit des Simulators nur dort überprüfen lässt, wo reale Ausführung möglich ist. Die Anwendung von SCEs auf Deployments erfordert daher eine gewisse Extrapolation. Die Gruppe erwartet auch nicht, dass SCEs die Grenzen der gefährlichen Fähigkeiten eines Modells offenlegen oder jede Art von Angriff abdecken. Die deutlichste Lücke sind langfristige Angriffe mit mehreren Agenten, für die es noch keine Simulatoren gibt.
Da keine Aufzeichnungen einer im realen Deployment ausgeführten Angriffs-Policy existieren, nutzte das Team die Ausführung in LinuxArena als Ersatz für das Deployment und verglich Control-Metriken zwischen ausgeführten und simulierten Durchläufen. Der Beitrag beschreibt außerdem eine Möglichkeit, qualitatives Verhalten zu vergleichen, etwa ob Modelle Angriffe auf dieselbe Weise ausführen: Ein Modell fasst das Verhalten entlang vorab festgelegter, interessierender Dimensionen zusammen.
Redwood sagt, die Belege seien inzwischen stark genug, dass man sich freuen würde, wenn KI-Entwickler SCEs einsetzten. Für Entwickler, die überwachte Agenten betreiben, bietet die Methode eine Möglichkeit, die Leistung von Monitoren auf den eigenen Codebasen abzuschätzen, ohne echte Angriffe auszuführen.
Redwood Research: Simulated Control Evaluations