Spot vom RAI Institute rollt Reifen im Freien allein mit Bordkameras
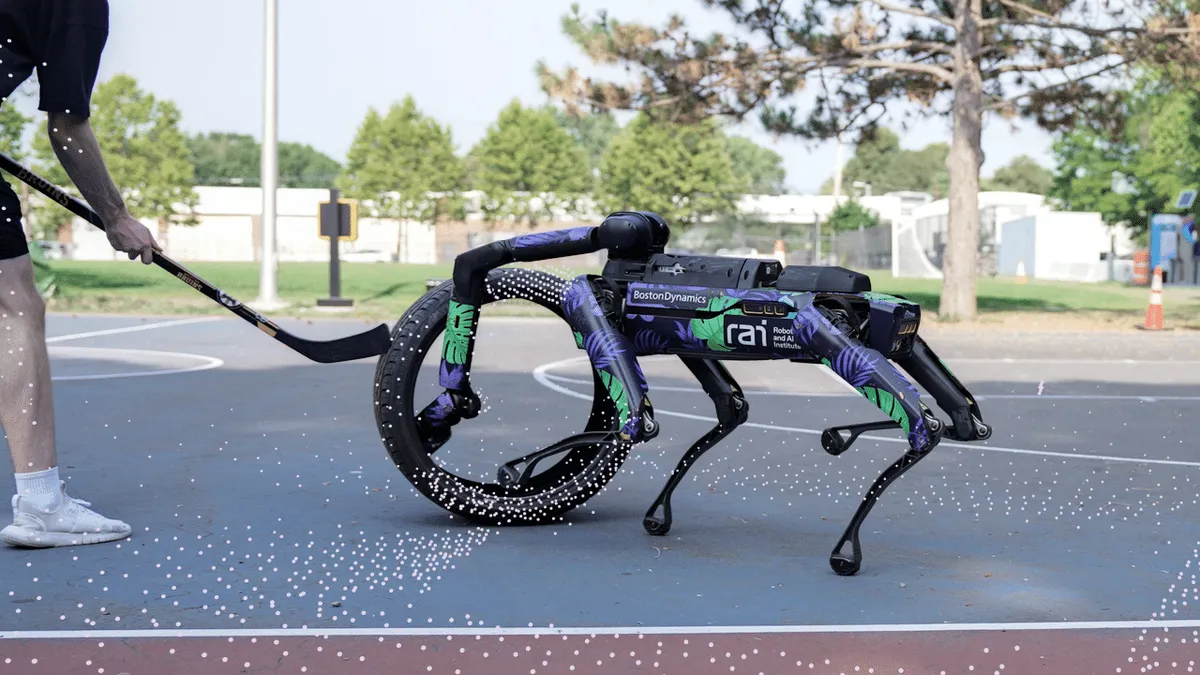
Das RAI Institute meldet, dass sein Roboter Spot einen schweren Reifen nun auch außerhalb des Labors bewegen kann. Dafür nutzt er seine eigenen Tiefenkameras und die Rechenleistung an Bord statt Motion-Capture-Kameras an der Decke und eines Desktop-Rechners. Laut dem Institut ist jede Fähigkeit inzwischen eine einzelne, in der Simulation trainierte Reinforcement-Learning-Policy.
- Spot des RAI Institute rollt, richtet auf und zieht einen 15 kg schweren Reifen nun allein mit Tiefenkameras und Rechenleistung an Bord.
- Das frühere System benötigte Motion-Capture-Kameras an der Decke, einen Desktop-Rechner und ein Skript zum Wechseln der Fähigkeiten.
- Jede Fähigkeit ist eine Reinforcement-Learning-Policy, die mit 50 Hz zehn Werte ausgibt und in wenigen Stunden auf einer Desktop-GPU trainiert wird.
- Die Trainingsmethode Crossfade RL ersetzt exakte Reifenposen schrittweise durch Tiefenbilder als Eingabe.
Vom Laboraufbau zur vollständigen Ausführung an Bord
In früheren Arbeiten hatte das RAI Institute gezeigt, wie Spot einen Autoreifen aufrichtet und rollt. Der Reifen wiegt 15 kg und damit mehr, als der Arm von Spot allein heben kann (11 kg Spitzenlast, 5 kg Dauerlast). Der Roboter musste also Beine, Rumpf und Arm koordinieren. Der damalige Regler kombinierte Reinforcement Learning mit samplingbasierter Trajektorienoptimierung.
Das frühere System funktionierte nur im Labor, weil es von drei Dingen abhing, die sich nicht am Roboter befanden: Motion-Capture-Kameras an der Decke, die den Reifen orteten, ein Desktop-Rechner, auf dem die Regler liefen, und ein Skript, das den Motion-Capture-Zustand auslas und entschied, wann zwischen Fähigkeiten gewechselt wird.
Das neue System übernimmt laut dem Institut all das selbst. Der Roboter findet den Reifen mit seinen eigenen Tiefenkameras und kann so im Freien und in zuvor unbekannten Umgebungen arbeiten. Er kann den Reifen rollen, aufrichten und ziehen und sich von unerwarteten Störungen erholen. In der Demonstration gibt ein Mensch dem Roboter lediglich einen Zielort vor, und der Roboter führt die gesamte Abfolge aus, einschließlich des erneuten Aufstellens des Reifens, falls dieser unterwegs umkippt.
Jede Fähigkeit ist ein neuronales Netz
Der Regelungsstack besteht aus zwei Ebenen. Eine per Reinforcement Learning trainierte Fortbewegungs-Policy hält den Roboter im Gleichgewicht und lässt ihn laufen. Eine Skill-Policy entscheidet, wohin sich der Körper bewegen soll und was der Arm tun muss. Geändert hat sich die Skill-Ebene.
Die Vorgängerversion testete Dutzende mögliche Aktionen und simulierte deren Folgen auf mehreren CPU-Threads, um den Reifen aufzurichten, zu ziehen und zu stapeln, während das Rollen per Reinforcement Learning gesteuert wurde. Das funktionierte zwar, so das Institut, erforderte aber einen leistungsstarken Desktop-Rechner und ein eigens entwickeltes Skript, um die Verfahren zu kombinieren. Nun ist jede Fähigkeit eine Reinforcement-Learning-Policy, die in der Simulation mit der exakten Pose des Reifens trainiert und anschließend so übertragen wird, dass sie die Kameras des Roboters nutzt. Eine Fähigkeit auszuführen, kostet auf dem Roboter nur einen einzigen Durchlauf durch das neuronale Netz.
- Eine Skill-Policy gibt mit 50 Hz zehn Werte aus: drei Anpassungen der Basisgeschwindigkeit und sieben der Gelenkziele des Arms.
- Die Anpassungen summieren sich auf: Null hält das aktuelle Ziel, ein anhaltender Impuls baut anhaltende Kraft auf den Reifen auf.
- Alle Fähigkeiten teilen sich denselben Aktionsraum und dieselbe Belohnungsvorlage. Sie belohnt Fortschritt in Richtung Ziel, das Anbringen des Greifers am Reifen und die Positionierung des Körpers und bestraft ruckartige Reifenbewegungen.
- Masse, Reibung und Größe des Reifens werden im Training zufällig variiert, damit sich die Policy nicht auf einen exakten Reifen verlässt.
Wenn 16.000 bis 64.000 simulierte Roboter parallel in einer Szene trainieren, ist eine einzelne Fähigkeit laut dem Institut in wenigen Stunden auf einer einzigen Desktop-GPU trainiert.
Crossfade RL: Der Policy das Sehen beibringen
Eine mit Zustandsinformationen trainierte Policy weiß immer, wo der Reifen ist, weil der Simulator es ihr mitteilt. Üblicherweise wechselt man zu Kameras, indem man die trainierte Policy als Lehrer einfriert und einen kamerabasierten Schüler trainiert, der sie imitiert. Laut dem Institut gelang so die Übertragung einiger Aufgaben wie Aufrichten und Ziehen, dynamischere Bewegungen wie das Neuausrichten des Reifens während des Rollens funktionierten jedoch schlecht.
Die Antwort des Instituts ist eine Pipeline, bei der das Reinforcement Learning während des gesamten Trainings weiterläuft, während privilegierte Eingaben schrittweise durch realistischere Wahrnehmungsdaten ersetzt werden. Sie besteht aus drei Stufen. In jeder wird ein Encoder trainiert, der aus weniger privilegierten Informationen denselben Merkmalsvektor ausgeben soll wie der vorherige:
- Kodierung der Objektposition aus exakten Posen: Die exakte Pose des Reifens wird in einen latenten Vektor kodiert, der in der nächsten Stufe als Referenz dient.
- Umgang mit zeitweiser Sichtbarkeit: Exakte Posen werden nur dann geliefert, wenn die Kamera den Reifen sieht, andernfalls wird die Eingabe auf null gesetzt. So lernt der Encoder robustes Verhalten, wenn der Reifen nicht im Bild ist.
- Übersetzung von Posen in Bilder: Die Eingabe besteht aus Tiefenbildern, das Netz nutzt also nur Informationen, die Bildsensoren liefern.
Sobald eine Stufe konvergiert, stützt sich die Skill-Policy weniger auf den vorherigen Encoder, bis der neue ihn vollständig ersetzt. Das Institut nennt die Methode Crossfade RL, weil die Policy per Reinforcement Learning weiterlernt, während die Destillation neu eingeführte Komponenten unterstützt.
Was das bedeutet
Das Ergebnis holt ein Ganzkörper-Manipulationssystem aus dem Motion-Capture-Labor auf einen Roboter, der alles Nötige selbst mitbringt. Der Ersatz des CPU-lastigen Planers und des Umschaltskripts durch neuronale Fähigkeiten vereinfacht das System und ermöglicht Spot laut dem Institut den Einsatz in Umgebungen, die er nicht kennt. Die Quelle beschreibt die Arbeit für ein einzelnes Objekt, einen Reifen, und nennt weder Leistungskennzahlen noch Einsatzpläne.
RAI Institute: Whole-Body Manipulation Outside the Lab