GB200
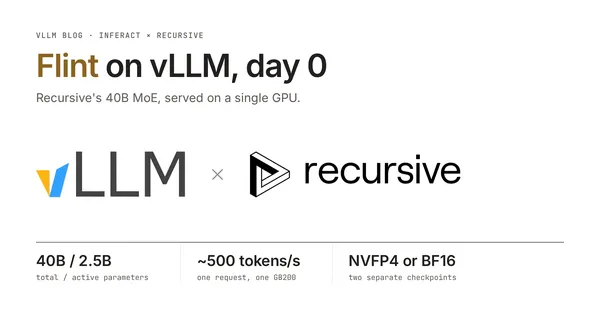
vLLM unterstützt Flint von Recursive ab Tag 0 und erreicht rund 485 Tokens/s auf einer einzigen GB200
Die Inferenz-Engine vLLM unterstützt Flint von Recursive ab dem ersten Tag, sowohl mit dem NVFP4- als auch mit dem BF16-Checkpoint auf einer einzelnen GPU. Laut dem…
vLLM verkürzt Elastic-EP-Skalierungspause von 100 Sekunden auf 0,82 Sekunden
Das Projekt vLLM hat nach eigenen Angaben die Unterbrechung des Serving-Betriebs bei der Neukonfiguration von Elastic Expert Parallelism auf unter zwei Sekunden…
CoreWeave erweitert sein KI-Trainingssystem um Self-Service und SUNK Anywhere
CoreWeave baut SUNK aus, sein Slurm-on-Kubernetes-System für das Training von KI-Modellen. Neu sind eine Self-Service-Bereitstellung und die Option SUNK Anywhere, die…