vLLM unterstützt Flint von Recursive ab Tag 0 und erreicht rund 485 Tokens/s auf einer einzigen GB200
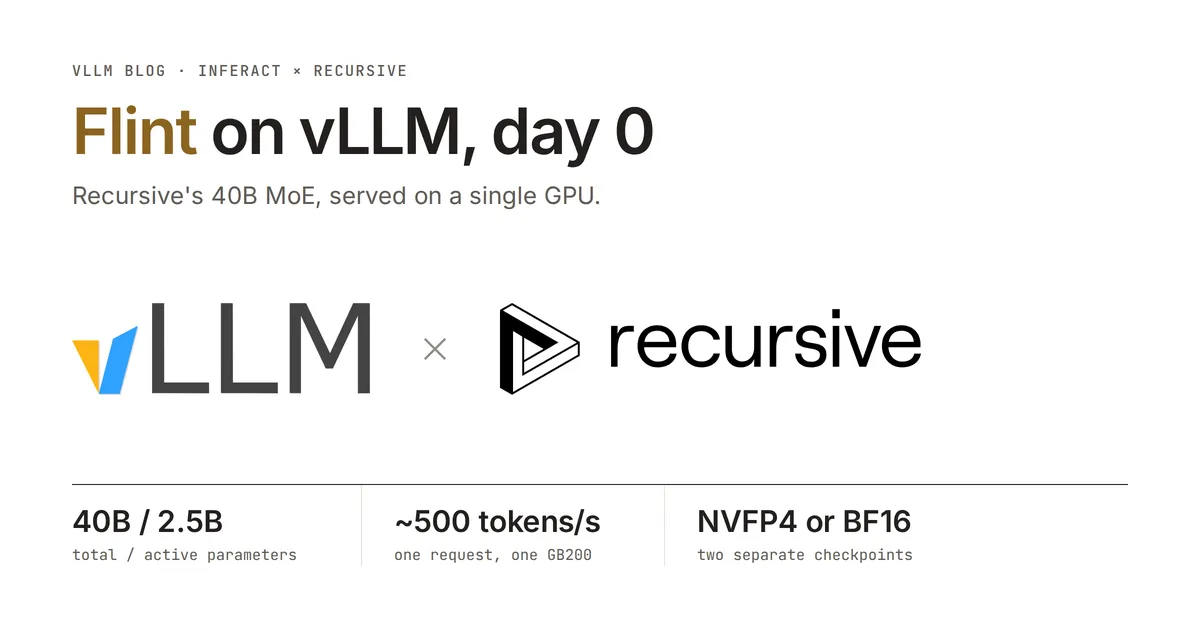
Die Inferenz-Engine vLLM unterstützt Flint von Recursive ab dem ersten Tag, sowohl mit dem NVFP4- als auch mit dem BF16-Checkpoint auf einer einzelnen GPU. Laut dem vLLM-Team decodiert eine einzelne Anfrage auf einer GB200 mit rund 500 Tokens/s, selbst bei 100.000 Tokens Kontext.
- vLLM unterstützt Flint von Recursive ab Tag 0, mit NVFP4- und BF16-Checkpoints auf einer einzelnen GPU.
- Flint ist ein MoE mit 40 Milliarden Parametern, das pro Token rund 2,5 Milliarden Parameter aktiviert und 262.000 Tokens Kontext bietet.
- Eigene Kernel senken das NVFP4-Decoding von 4,81 auf 1,78 ms und den Forward Pass von 1.096 auf 346 Kernel.
- Das End-to-End-Decoding mit Batch 1 bei 100.000 Tokens Kontext braucht 2,06 ms pro Token, etwa 485 Tokens/s auf einer GB200.
- Die optimierten Kernel zielen auf eine einzelne Blackwell-GPU (TP=1), andere Setups nutzen die Standardschichten von vLLM.
Ein 40B-MoE, das 2,5 Mrd. Parameter aktiviert
Flint ist ein Mixture-of-Experts-Modell mit 40 Milliarden Parametern, das pro Token nur etwa 2,5 Milliarden Parameter aktiviert. Es bietet einen Kontext von 262.000 Tokens und nutzt in den meisten Schichten Sliding-Window-Attention. Das Modell erscheint in zwei getrennten Checkpoints: NVFP4, quantisierungsbewusst trainiert, und BF16.
Die Architektur ist ein MoE mit 49 Schichten, Pre-Norm und einer Hidden Size von 2048. Davon betrachten 35 Schichten ein Sliding Window von 513 Tokens mit RoPE, die übrigen 14 betrachten den gesamten Kontext ohne Positionskodierung. Nur diese 14 halten den KV-Cache für die gesamte Sequenz vor, sodass der Cache 28 KiB pro Token kostet. Hinzu kommen gelernte Attention Sinks, GQA mit 32 Query- und 4 KV-Köpfen sowie RMSNorm pro Kopf für Q/K. Das Modell hat 256 Experten mit Sigmoid-Top-6-Routing plus einem geteilten Experten, die Schichten 0 und 1 verwenden stattdessen ein dichtes MLP.
Der NVFP4-Checkpoint ist eine GGUF-Datei, deren Blöcke NVIDIAs NVFP4-Format in anderer Byte-Reihenfolge nutzen. vLLM packt sie beim Laden verlustfrei um und führt sie wie die Referenzimplementierung von Recursive nur mit gewichteter Quantisierung (W4A16) aus, mit BF16-Aktivierungen und BF16-KV-Cache. Das vLLM-Team erklärt, jeder Flint-Kernel folge den Rundungspunkten der Referenz, und die Genauigkeit stimme mit ihr bei GSM8K, GPQA-Diamond, Long-Context-MRCR und einer Tool-Calling-Suite überein.
Von 1.096 Kerneln auf 346
Die erste Implementierung, die auf den Standardschichten von vLLM aufbaute, war bei kleinen Batchgrößen langsam. Ein Decode-Schritt führte 1.096 Kernel aus, viele davon für deutlich größere Batches optimiert. Das Team ersetzte sie Schritt für Schritt durch Flint-spezifische Kernel und prüfte jede Änderung gegen die Referenz. Die genannten Gewinne im Einzelnen:
- Fusionierte Q/K-Norm, RoPE und KV-Cache-Schreibzugriff: 8 % geringere Latenz, ein Kernel statt drei.
- MoE-Kernel für kleine Batches: 27 % geringer, mit Router- und Experten-GEMVs, die nur die Gewichte der ausgewählten Experten lesen. Dies brachte auch den größten Zugewinn beim Prefill.
- Dichtes GEMV für kleine Batches: 25 % geringer, auf denselben gepackten NVFP4-Gewichten wie der Kernel für große Batches.
- Norm- und SiLU-Kernel: 10 % geringer, nach den Rundungsregeln der Referenz.
- Decode-Attention mit Sinks und Sliding Windows, geschrieben in CuTe DSL: 5 % geringer.
- Decode-Pfad mit niedriger Latenz: 14 % geringer.
Bei bis zu 8 Anfragen führt der Low-Latency-Pfad jede MoE-Schicht als sieben Kernel aus. Q/K-Norm, RoPE, Routing und die Zusammenführung der Experten sind in die benachbarten GEMV-Kernel fusioniert. Jeder Kernel nutzt Programmatic Dependent Launch und lädt so seine Gewichte, während der vorherige noch läuft.
Insgesamt sank das NVFP4-Decoding von 4,81 auf 1,78 ms (2,7-fach), das BF16-Decoding von 3,53 auf 2,34 ms (1,5-fach) und ein Prefill mit 8.000 Tokens von 207 auf 145 ms (1,4-fach). Ein Forward Pass umfasst nun 346 statt 1.096 Kernel. Im End-to-End-Betrieb benötigt das Batch-1-Decoding bei 100.000 Tokens Kontext 2,06 ms pro Token, etwa 485 Tokens/s, einschließlich LM-Head und Sampling.
Flint mit vLLM betreiben
Der NVFP4-Checkpoint wird mit vllm serve RecursiveSI/flint-nvfp4-gguf bereitgestellt, wobei Konfiguration und Tokenizer aus dem BF16-Repository RecursiveSI/flint stammen. Der BF16-Checkpoint wird direkt aus RecursiveSI/flint bereitgestellt. Beide Befehle aktivieren Auto Tool Choice und nutzen die Parser glm47 für Tool-Aufrufe und Reasoning, da Flint Tool-Aufrufe und Denkblöcke im Stil von GLM-4.7 ausgibt.
Das Flag --exclude-tools-when-tool-choice-none entfernt Tool-Definitionen aus dem Prompt, wenn tool_choice auf "none" steht, wie in der Referenz. Die Standardwerte fürs Sampling sind Temperatur 1,0, Top-p 0,95 und Top-k 20. Reasoning zählt auf max_tokens an, daher empfiehlt das Team für schwierige Aufgaben mindestens 32.000.
Eine Einschränkung gilt: Die Flint-Kernel zielen auf eine einzelne Blackwell-GPU (TP=1, BF16-KV-Cache). Andere Konfigurationen greifen auf die Standardschichten von vLLM zurück, die laut Team bei der ersten Implementierung bei kleinen Batchgrößen langsam waren.
Was das für Nutzer bedeutet
Teams, die Flint ausprobieren wollen, können ab dem Veröffentlichungstag beide Checkpoints mit vLLM auf einer Blackwell-GPU bereitstellen, mit niedriger Latenz pro Token bei Einzelanfragen, selbst bei langem Kontext. Wer andere Hardware oder Parallelisierungs-Setups nutzt, erhält statt der optimierten Flint-Kernel die Standardschichten von vLLM.
vLLM: Day-0 Support for Flint on vLLM