Ultralytics ergänzt rotationsbewusste OCR für YOLO26 in Python
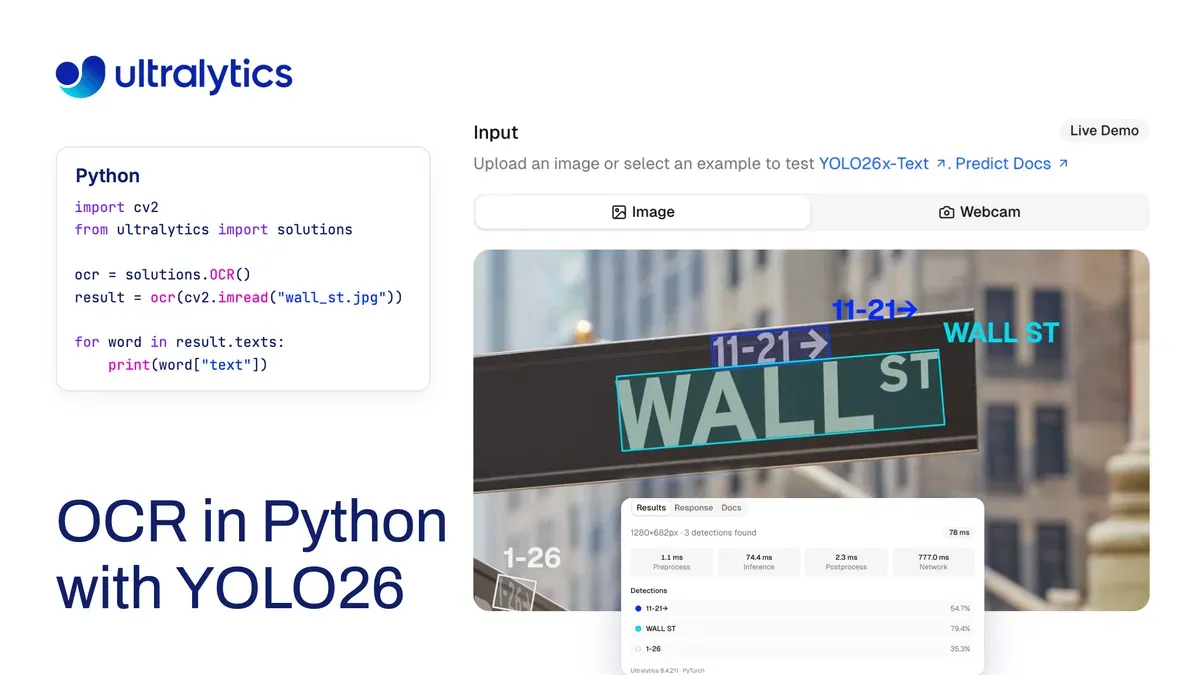
Ultralytics hat eine Python-OCR-Pipeline vorgestellt, die auf YOLO26-Text und PaddleOCRs PP-OCRv6 basiert und Dokumente, Fotos sowie PDF-Seiten in verschiedenen Drehwinkeln lesen soll. Nach Angaben des Unternehmens erkennt die Pipeline Text, identifiziert einzelne Wörter und gibt sie auf CPU oder GPU in Leserichtung aus.
- YOLO26-Text erkennt gedrehten Text, während PP-OCRv6 Wörter erkennt.
- Die Pipeline gibt Text in Leserichtung mit Konfidenzwerten und Polygonen zurück.
- Ultralytics meldet Word-F1-Werte von 0.931 auf sechs PDF-Seiten und 0.722 auf 80 HierText-Fotos.
- Die optionale FP16-TensorRT-Erkennung verkürzte einen OCR-Aufruf auf einer dicht beschriebenen Seite von 182 ms auf 94 ms.
- Die OCR-Lösung unterstützt CPU, CUDA und benutzerdefinierte Recognizer.
Zweistufige Pipeline verarbeitet gedrehten Text
Die OCR-Lösung verwendet ein YOLO26-Text-Modell, um Text mit orientierten Begrenzungsrahmen zu erkennen, und übergibt anschließend jeden Wortausschnitt zur Erkennung an PP-OCRv6. Der Standarddetektor ist das Modell yolo26x-text; außerdem sind die Größen n, s, m, l und x verfügbar.
Ultralytics zufolge wurde die Pipeline in Version 8.4.210 rund um PP-OCRv6 auf ONNX Runtime neu aufgebaut, einschließlich Drehwinkelerkennung und Leserichtung. Version 8.4.211 ergänzte einen optionalen TensorRT-Recognizer. Die Standardkonfiguration kann je nach ausgewählter Hardware und verfügbarem Execution Provider mit ONNX Runtime auf einer CPU oder unter CUDA laufen.
Zu den Ergebnissen gehören der erkannte Text, die Erkennungskonfidenz, die Detektorkonfidenz, eine Zeilennummer und ein Polygon in den Koordinaten des Originalbildes. Die getrennte Ausweisung der beiden Konfidenzwerte kann dabei helfen, Wörter zu identifizieren, die eine manuelle Prüfung erfordern.
Seiten lassen sich ohne manuelle Drehung lesen
Die Lösung schätzt die Seitendrehung anhand der Winkel der erkannten Textboxen. Sie dreht die Seite, schneidet die Wörter aufrecht aus und gruppiert sie von oben nach unten sowie von links nach rechts in Zeilen. Außerdem vergleicht sie die beiden möglichen Ausrichtungen bei 0 und 180 Grad, indem sie die acht breitesten Wörter liest und das Ergebnis mit der höheren Konfidenz auswählt.
In Tests mit acht Dokumenten und Screenshots sowie 12 Fotos, die um 90, 180 und 270 Grad gedreht waren, meldet Ultralytics einen Word-F1-Wert von 0.925 für die Dokumente und 0.654 für die Fotos. Auf einem leeren IRS-Formular 8802 las das System bei 0, 180 und 90 Grad jeweils 404, 401 und 399 Wörter, wobei die ersten Zeilen identisch waren.
In einem separaten Benchmark mit einer Bildgröße von 1280 erreichte die Standardkonfiguration einen Word-F1-Wert von 0.931 auf sechs PDF-Seiten und 0.722 auf 80 HierText-Fotos. Ultralytics zufolge spricht der Benchmark dafür, den x-Detektor mit imgsz=1280 einzusetzen und für dicht beschriebene Dokumentseiten max_det=1000 festzulegen.
Python-Einrichtung und TensorRT-Leistung
Entwickler können das Paket mit pip install -U "ultralytics>=8.4.211" installieren und anschließend die OCR-Lösung mit solutions.OCR() erstellen. Der erste OCR-Aufruf lädt YOLO26x-Text und PP-OCRv6 herunter und installiert ONNX Runtime. Laut Quelle erfordert der Standard-Recognizer Python 3.11+ und ONNX Runtime 1.26+.
Für PDFs muss jede Seite zunächst als Bild gerendert werden. Die zurückgegebenen Wörter sind bereits sortiert, sodass Entwickler durch eine Gruppierung nach Zeilen wieder reinen Text erzeugen können. Die Polygone können außerdem Prüfungen unterstützen, etwa ob ein Betrag neben dem Wort „Total“ erscheint.
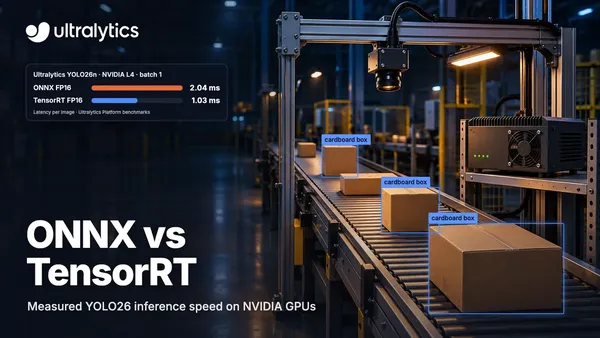
Ultralytics zufolge ist der optionale FP16-TensorRT-Recognizer für NVIDIA-GPUs vorgesehen. In einem Test auf einer RTX PRO 6000 las er 251 erkannte Wörter in einem Foto in 82 ms, verglichen mit 249 ms unter ONNX Runtime auf CUDA. Bei vier Fotos mit Szenentext war die TensorRT-Engine bei drei Bildern mit 195 bis 263 Wörtern 2,5- bis 3-mal schneller, während sie bei einem Foto mit 48 Wörtern 1,4-mal schneller war. Ein vollständiger OCR-Aufruf auf einer dicht beschriebenen Seite sank von 182 ms auf 94 ms.
Was die Veröffentlichung für Entwickler bedeutet
Die Veröffentlichung bietet Python-Entwicklern einen einheitlichen Codepfad für OCR auf Bildern, Videoframes und gerenderten PDF-Seiten, während Detektor und Recognizer unabhängig voneinander austauschbar bleiben. Ultralytics zufolge können Nutzer einen kleineren Detektor auswählen, ihr eigenes Erkennungs- oder Segmentierungsmodell bereitstellen oder eine benutzerdefinierte Recognizer-Funktion übergeben.
Diese Flexibilität kann für Anwendungen geeignet sein, die sowohl den extrahierten Text als auch seine Position auf einer Seite benötigen. Die Benchmark-Ergebnisse zeigen zudem einen Unterschied zwischen sauberen PDF-Seiten und Fotos mit Szenentext: Für den PDF-Datensatz meldet das Unternehmen höhere Word-F1-Werte. Entwickler können denselben Codepfad auf der browserbasierten Dokumentverarbeitungsseite von Ultralytics testen, bevor sie das Paket installieren.