Visual Cipher Bench zeigt Schwächen von KI-Agenten bei verborgenen Regeln
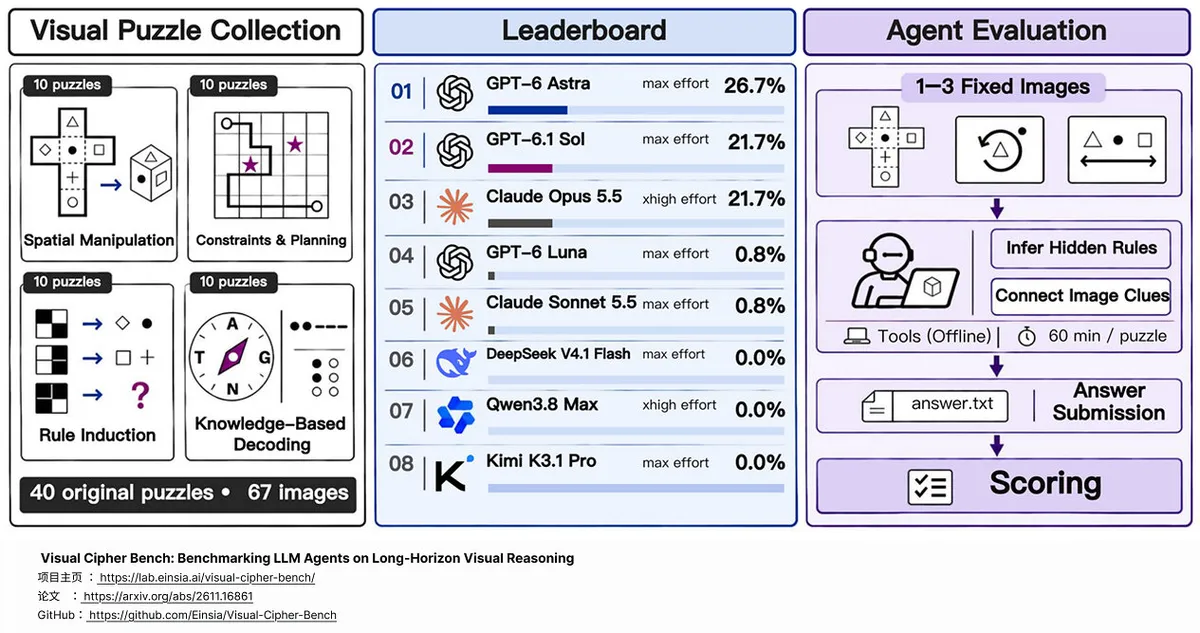
Navers Lab von Einsia AI hat Visual Cipher Bench vorgestellt. Der Benchmark prüft, ob KI-Agenten verborgene Regeln aus visuellen Hinweisen erkennen und Aufgaben mit langen Handlungsketten lösen können. In 3.480 Versuchen mit acht Frontier-Modellen und 29 Reasoning-Konfigurationen überschritt keine Konfiguration eine Genauigkeit von 30 %.
- Visual Cipher Bench umfasst 40 Rätsel aus vier Kategorien.
- GPT-6 Astra (max) führte die Auswertung mit 26,7 % Genauigkeit an.
- Die Genauigkeit bei der Regelinduktion lag über 3.480 Versuche hinweg bei 0,6 %.
- Die Vorgabe grundlegender Regeln erhöhte die Gesamtgenauigkeit von 12,2 % auf 51,1 %.
Ein Benchmark ohne ausdrückliche Anweisungen
Visual Cipher Bench soll eine Fähigkeit prüfen, die herkömmliche Benchmarks für visuelle Frage-Antwort-Systeme im Allgemeinen nicht erfassen: das Lösen von Problemen, wenn Anweisungen und Regeln in Bildern verborgen sind. Die Agenten erhalten eine Anweisung, untersuchen die Bilder und schreiben eine abschließende Antwort in eine Datei.
Der Benchmark umfasst 40 eigens entwickelte visuelle Rätsel, die durch 67 Schwarz-Weiß-Illustrationen dargestellt werden. Um sie zu lösen, muss ein Agent Beispiele erkennen, das zugrunde liegende Problem verstehen, die erforderliche Ausgabe ableiten und jede Aufgabe ohne ausdrückliche Regeln oder unmittelbares Feedback zur Korrektheit lösen.
Die Rätsel sind in vier Kategorien unterteilt: räumliche Operationen wie Falten, Drehungen, Projektionen und geometrische Transformationen, logische Planung, Regelinduktion sowie Wissensdekodierung mit Morsecode, Braille und Worträtseln.
GPT-6 Astra führt, doch die Regelinduktion bleibt schwach
GPT-6 Astra (max) erzielte mit 26,7 % Genauigkeit das beste Ergebnis und kam bei einem Durchlauf mit 40 Rätseln im Schnitt auf 10,7 richtige Antworten. GPT-6.1 Sol (max) und Claude Opus 5.5 (xhigh) erreichten jeweils 21,7 %.
GPT-6 Luna und Claude Sonnet 5.5 kamen jeweils auf 0,8 % und lösten bei 120 Versuchen ein Rätsel. DeepSeek V4.1 Flash, Qwen 3.8 Max und Kimi K3.1 Pro erzielten keine einzige richtige Antwort.
Räumliche Operationen waren mit einer Genauigkeit von 22,8 % über alle Versuche hinweg die stärkste Kategorie. Die Wissensdekodierung erreichte 3,3 %, die logische Planung 2,4 % und die Regelinduktion lediglich 0,6 %. Die Modelle lösten fünf von 870 Versuchen zur Regelinduktion. GPT-6 Astra (max) erreichte bei räumlichen Operationen 80 %, während keine Konfiguration in den anderen drei Kategorien mehr als 13,3 % erzielte.
Einsia AI zufolge schienen einige richtige Antworten eher auf thematischen Vermutungen als auf einer systematischen Regelerkennung zu beruhen. Das unterstreicht den Unterschied zwischen der Ausführung einer Antwort und eigenständigem Schlussfolgern.
Regelhinweise verbessern die Ausführung deutlich
In einem zusätzlichen Experiment wurden 10 Rätsel mit GPT-6 Astra, GPT-6.1 Sol und GPT-6 Luna getestet. Als die Forschenden die grundlegenden Regeln vorgaben, ohne Zwischenschritte oder Antworten zu liefern, stieg die Gesamtgenauigkeit von 12,2 % auf 51,1 %. Die Genauigkeit bei der Regelinduktion erhöhte sich von 0 % auf 85,2 %.
GPT-6 Astra verbesserte sich von 23,3 % auf 70,0 %, während GPT-6.1 Sol von 13,3 % auf 66,7 % zulegte. Die Zahl der Zeitüberschreitungen sank über 90 Versuche hinweg von 51 auf 29. Ein Kontrollexperiment, bei dem Informationen zur Darstellung des Aufgabenstatus, nicht aber zu den grundlegenden Regeln bereitgestellt wurden, ergab eine Genauigkeit von 16,7 %.
Die Forschenden identifizierten voreilige Schlussfolgerungen und eine ineffiziente Suche als wiederkehrende Fehlermuster. Die Agenten akzeptierten mitunter Regeln, die nur einen Teil der Belege erklärten, oder nutzten so viele Werkzeugaufrufe und Kombinationen, dass die Zeit ablief. Die Ergebnisse deuten darauf hin, dass das Erkennen, Überprüfen und Übertragen verborgener Regeln für Agenten, die weniger strukturierte Aufgaben in der realen Welt bewältigen sollen, weiterhin eine große Hürde darstellt.