AMD MI355X schlägt NVIDIA B300 pro GPU im AgentX-Benchmark mit Kimi K3
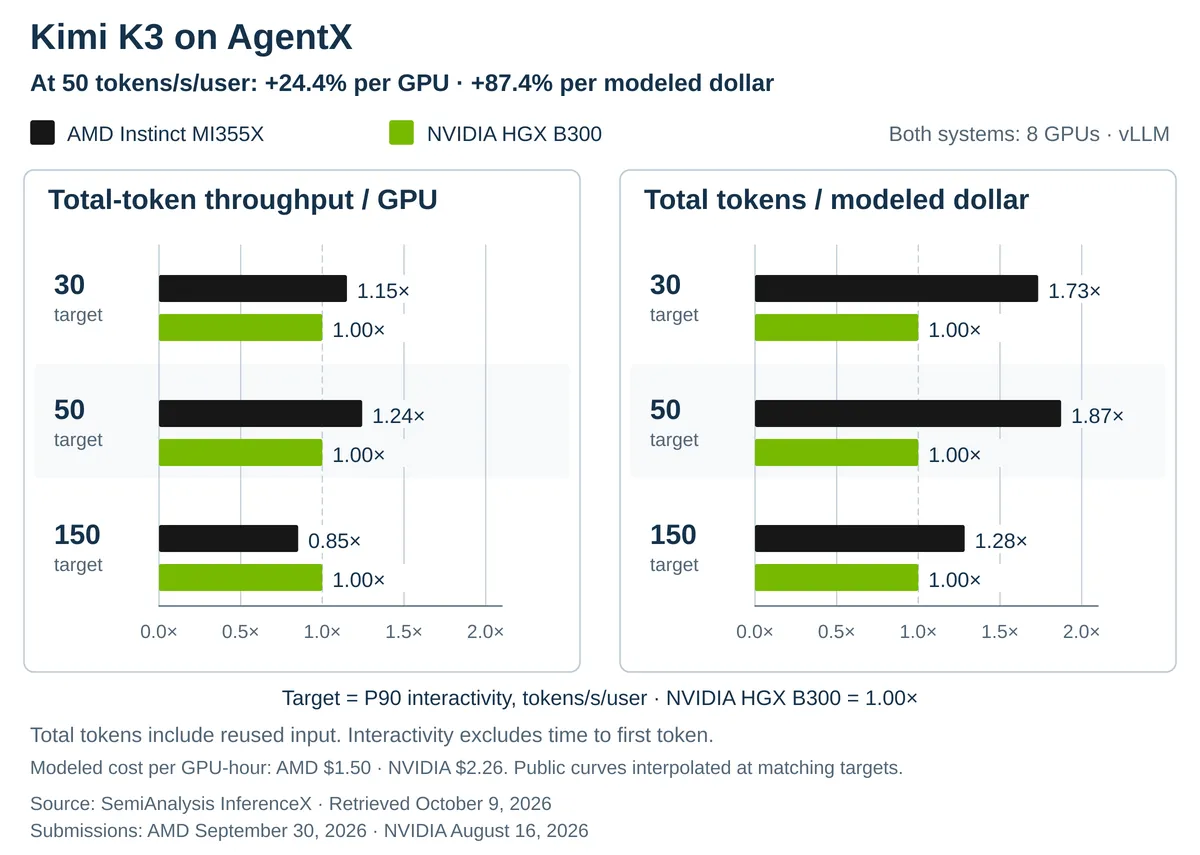
Ein System mit acht AMD Instinct MI355X, das Kimi K3 mit vLLM bereitstellt, erzielt im AgentX-Benchmark bei einer P90-Interaktivität von 50 Tokens/s/Nutzer 24,4 % mehr Tokens pro Sekunde und GPU als NVIDIA HGX B300. Das berichtet das vLLM-Projekt. Nach dem Kostenmodell des Benchmarks sind es 87,4 % mehr Tokens pro Dollar.
- Acht AMD Instinct MI355X mit Kimi K3 auf vLLM erreichen bei 50 Tokens/s/Nutzer P90-Interaktivität 24,4 % mehr Tokens/s/GPU insgesamt als NVIDIA HGX B300.
- Rund 7.567 gegenüber 6.083 Tokens/s/GPU insgesamt, laut SemiAnalysis-InferenceX-Snapshot vom 9. Oktober 2026.
- Mit den von SemiAnalysis modellierten TCO von 1,50 gegenüber 2,26 US-Dollar pro GPU-Stunde liefert AMD 87,4 % mehr Tokens pro Dollar.
- Zu den Optimierungen zählen DCP8 für den MLA-Verlauf, CPU-Offload von KV- und KDA-Zustand sowie der Wegfall doppelter MoE-Projektionsarbeit.
- Eine Speicher-Optimierung (#59591) steigerte den Durchsatz in einem separaten Test bei Concurrency 70 um 28,9 %.
Die AgentX-Ergebnisse
AgentX ist ein öffentlicher Benchmark, der reale Sitzungsverläufe von Coding-Agenten mit synthetischen Tokens wiedergibt. Er behält Anfragelängen, Timing und Muster der Präfix-Wiederverwendung bei und bietet laut dem vLLM-Beitrag bei unbegrenztem Cache eine theoretische Präfix-Wiederverwendung von über 96 %.
Bei einer P90-Interaktivität von 50 Tokens/s/Nutzer verarbeitet die AMD Instinct MI355X rund 7.567 Tokens/s/GPU insgesamt, die NVIDIA HGX B300 kommt auf 6.083. Daraus ergibt sich der Durchsatzvorsprung von 24,4 %. Legt man die von SemiAnalysis modellierten Gesamtbetriebskosten (TCO) von 1,50 gegenüber 2,26 US-Dollar pro GPU-Stunde zugrunde, entspricht das 18,16 Millionen gegenüber 9,69 Millionen Tokens pro Dollar TCO.
Die Zahlen stammen aus dem SemiAnalysis-InferenceX-Snapshot vom 9. Oktober 2026. Die Interaktivität ist der Kehrwert der P90-Latenz zwischen aufeinanderfolgenden Antwort-Tokens und schließt die Zeit bis zum ersten Token nicht ein. Die Gesamt-Tokens umfassen wiederverwendete Eingaben und erzeugte Ausgaben. Der Beitrag weist darauf hin, dass die öffentlichen Kurven komplette Serving-Stacks vergleichen und dass die Messungen neben den einzelnen Optimierungen aus separaten Tests stammen.
Auf dem Papier liegen die beiden Chips nah beieinander. Die veröffentlichten Spitzenwerte für dichte Matrixoperationen betragen 10,1 PFLOP/s MXFP4 bei der MI355X und 13,5 PFLOP/s FP4 bei der B300. Beide verfügen über 288 GB HBM3E und 8 TB/s Spitzen-Speicherbandbreite. Der Beitrag würdigt die kontinuierliche Software-Entwicklungsarbeit von AMD und Partnern in der vLLM-Community.
Warum Kimi K3 schwer zu betreiben ist
Der Beitrag beschreibt ein Modell, das zwei Arten von Attention kombiniert. Seine 24 MLA-Schichten behalten einen komprimierten KV-Verlauf, der mit der Konversation wächst. Seine 69 KDA-Schichten führen Zustandsmatrizen mit festen Dimensionen mit und aktualisieren sie, sobald neue Tokens eintreffen. In den MoE-Schichten wählt ein Router Expertennetzwerke aus, die jedes Token verarbeiten.
Ein wiederkehrender Agenten-Turn kann den Großteil seines Präfixes wiederverwenden, doch auch die Verarbeitung einer kurzen Fortsetzung greift auf alle drei Datenarten zu. Die Optimierungen sind danach gruppiert, wo Verschwendung entsteht: über mehrere Turns hinweg, innerhalb eines Modellschritts und bei der Wahl der Draft-Tiefe für spekulatives Decoding.
Änderungen bei Cache und MoE
Die erste Änderung zielt auf den Cache-Speicher. Unter TP8 bearbeitet jede GPU 12 der 96 MLA-Query-Heads von Kimi K3, speichert aber den gesamten komprimierten KV-Verlauf. Mit achtfacher Decode-Context-Parallelism (DCP8) speichert jede GPU nur ein Achtel der gecachten Positionen. Beim Decodieren tauschen die GPUs Queries aus, rechnen gegen ihren lokalen Verlauf und führen die Teilergebnisse zusammen. Für eine Konversation mit 142.000 Tokens schätzt der Beitrag die MLA-Nutzlast auf etwa 1,96 GB pro GPU, die DCP8 vor dem Allokations-Overhead auf rund 245 MB senkt.
Passt der Zustand nicht mehr in den GPU-Speicher, hält das native vLLM-CPU-Offload den MLA-Verlauf und die KDA-Checkpoints im Host-DRAM. Ein Cache-Treffer setzt übereinstimmende Wiederaufsetzpunkte voraus. Reicht der MLA-Verlauf bis Token 3.072, der letzte kompatible KDA-Checkpoint liegt aber bei 2.048, muss die Anfrage bei 2.048 fortsetzen und die restlichen 1.024 Positionen neu berechnen. Wird der Rest des Attention-Blocks zusammen mit dem KDA-Checkpoint gespeichert, stimmen die Wiederaufsetzpositionen überein (#54736).
Die zweite Änderung beseitigt doppelte Arbeit. Im ursprünglichen ROCm-Pfad lief die Ausgabeprojektion der gerouteten Experten achtmal, einmal auf jeder GPU. Nun werden die Ausgabekoordinaten auf die GPUs aufgeteilt und vor dem bestehenden All-Reduce zu den Teilergebnissen der gemeinsamen Experten addiert, ohne neue kollektive Operation (#51253). Im Test des PR auf acht MI355X-GPUs stieg der Ausgabedurchsatz bei Concurrency 8 und 128 um 3,05 bzw. 4,91 %.
Eine Folgeänderung (#59591) lädt nur die Zeilen, die jeder Rang verwendet, und spart bei TP8 über 92 MoE-Schichten etwa 3,85 GiB pro GPU. Sie kam erst nach dem Image hinzu, das für das Hauptergebnis verwendet wurde. In einem separaten AgentX-Experiment zeigte sie bei Concurrency 32 und 48 weniger als 1 % mehr Durchsatz, bei 70 dagegen 28,9 %, wobei die gemeldete Präfix-Cache-Trefferquote von 74,8 % auf 80,1 % stieg. Der Beitrag nennt den größeren Gewinn bei hoher Auslastung konsistent mit Cache-Druck und merkt an, dass keine Unsicherheit über wiederholte Läufe angegeben wurde.
Was das bedeutet
Das Ergebnis ist eine herstellernahe Aussage auf Basis eines öffentlichen Benchmarks, und der Beitrag betont, dass er komplette Serving-Stacks statt isolierter Hardware vergleicht. In diesem Rahmen zeigt er, dass Software-Arbeit an Caching, Parallelisierung und Kernels den Abstand zwischen zwei Beschleunigern mit ähnlichen Speicherspezifikationen verringern kann. Für Teams, die Coding-Agenten mit langem Kontext betreiben, lautet die zentrale Lehre des Beitrags, dass Präfix-Wiederverwendung und Cache-Kapazität den Durchsatz stark beeinflussen, besonders bei steigender Last.