Arize testet Konfidenz-Schwelle für die Tool-Auswahl von KI-Agenten in Phoenix
Arize AI hat gezeigt, wie ein Entscheidungsmodell die Tool-Wahl eines KI-Agenten sichtbar und überprüfbar machen kann. Bei dem Demo-Shopping-Agenten gingen Entscheidungen mit einer Konfidenz unter etwa 0,7 deutlich häufiger schief. Wurden diese Durchläufe an das Chatmodell zurückgegeben, sank die Zahl leerer oder unfertiger Antworten laut Arize von 21 auf 3.
- Arize schaltete ein Entscheidungsmodell, gpt-6-luna von OpenAI, vor die Tools eines Demo-Shopping-Agenten; jede Auswahl wird in Phoenix auf einem DECISION-Span protokolliert.
- Auswahlen mit einer Konfidenz unter etwa 0,7 führten in einem von drei Fällen zu einem fehlerhaften Durchlauf, über 0,8 in weniger als einem von zehn.
- Die Schwelle bei 0,7 senkte leere oder unfertige Antworten über 300 Durchläufe pro Version von 21 auf 3, bei 92 Prozent als korrekt bewerteten Tool-Aufrufen.
- Der Schwellenwert von 0,7 stammt von Arize selbst, der Beitrag erklärt, wie sich für einen anderen Agenten ein eigener finden lässt.
Wahl und Aufruf getrennt
Die meisten Agenten wählen Tools in einem einzigen Modellaufruf: Das Chatmodell liest die Unterhaltung, wählt ein Tool und schreibt dessen Argumente. Laut Arize zeigt der Trace anschließend den Aufruf, die Argumente und das Ergebnis, nicht aber die Wahl selbst. Man sieht nicht, welche anderen Tools das Modell in Betracht zog oder wie knapp die Entscheidung ausfiel.
Arize hat es mit einer anderen Aufteilung versucht. Ein Entscheidungsmodell, hier die Decisions API von OpenAI, nimmt eine Liste von Optionen entgegen und gibt für jede eine Wahrscheinlichkeit zurück, ohne Text zu schreiben. Die zweite Aufgabe bleibt beim Chatmodell: das gewählte Tool aufrufen und die Argumente ausfüllen. Phoenix unterstützt nun Decision Tracing mit einem neuen Span-Typ namens DECISION. Jede Auswahl landet auf einem eigenen Span, mit einer Wahrscheinlichkeit für jede Option, die das Modell verworfen hat.
Der Beitrag unterscheidet zwei Werte. Optionswahrscheinlichkeiten bewerten jede verfügbare Wahl und summieren sich zu eins. Die Konfidenz ist ein eigener Wert für die Entscheidung als Ganzes. In einem Beispiel hatte purchaseProduct eine Wahrscheinlichkeit von 0,84, während die Konfidenz der Entscheidung bei 0,81 lag. Alle Schwellenwerte im Beitrag beziehen sich auf die Konfidenz.
Der Test: drei Agentenversionen, 900 Durchläufe
Der Testagent ist Wonder Toys, ein Demo-Spielzeugladen mit fünf Tools: den Katalog durchsuchen, ein Produkt anzeigen, es kaufen, eine Bestellung prüfen oder eine stornieren. Arize schrieb 100 Nachrichten, wie sie ein Kunde tippen würde, und ließ jede davon dreimal durch drei Agentenversionen laufen, insgesamt 900 Durchläufe. Alle Versionen teilen sich denselben Prompt, dieselben Tools und dasselbe Chatmodell. Nur die Tool-Auswahl unterscheidet sich.
- Wie ausgeliefert: Das Chatmodell wählt sein Tool selbst.
- Immer erzwungen: Das Entscheidungsmodell, hier gpt-6-luna, wählt, und das Chatmodell muss dieses Tool aufrufen.
- Schwelle bei 0,7: Die Wahl des Entscheidungsmodells gilt nur bei einer Konfidenz von mindestens 0,7. Darunter wählt das Chatmodell selbst.
Bei den Kernzahlen stimmte das erste Tool in 78 Prozent der Durchläufe des ausgelieferten Agenten mit Arizes Label überein, bei der erzwungenen Version in 95 Prozent und bei der geschalteten in 91 Prozent. Der Judge bewertete die Tool-Aufrufe in 79, 89 und 92 Prozent der Fälle als richtig. Die mittlere Dauer pro Durchlauf betrug 6,5 s, 5,6 s und 7,1 s, die Kosten pro Durchlauf 0,0217 $, 0,0210 $ und 0,0220 $. Arize merkt an, dass ein Teil des Vorsprungs der erzwungenen Version daher rührt, wie Käufe bewertet wurden, was der Beitrag später untersucht.
Die Schwachstelle waren Entscheidungen mit niedriger Konfidenz. Über die 100 Testnachrichten hinweg führte eine Auswahl mit einer Konfidenz unter etwa 0,7 in einem von drei Fällen zu einem fehlerhaften Durchlauf. Zwischen 0,7 und 0,8 war es etwa einer von sechs, über 0,8 weniger als einer von zehn. Arize betont, dass der Schwellenwert zu seinem Aufbau passt. Mit der Schwelle sanken leere oder unfertige Antworten über 300 Durchläufe pro Version von 21 auf 3, und der Judge bewertete die Tool-Aufrufe weiterhin so oft als korrekt wie zuvor. Der ursprüngliche Agent hatte in diesem Test keine.
Zwei Beispieldurchläufe
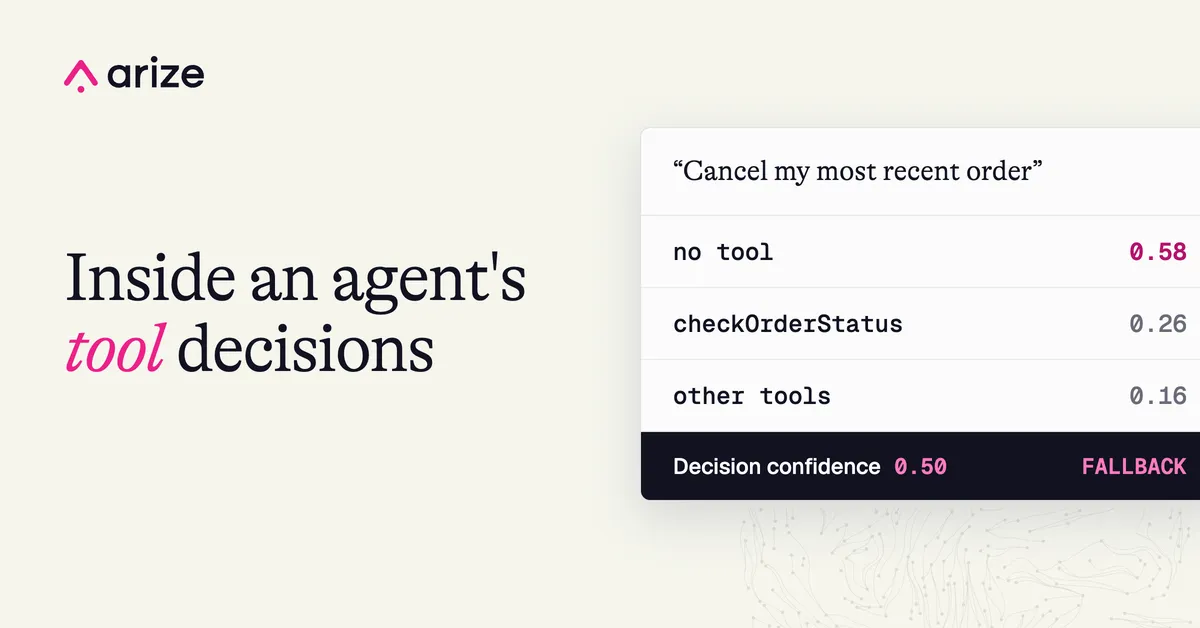
Bei der Nachricht „Cancel my most recent order“ neigte der Router dazu, gar kein Tool zu nutzen (0,58), die Bestellabfrage lag bei 0,26, die Konfidenz bei 0,50. In der immer erzwungenen Version konnte das Chatmodell kein Tool aufrufen, schrieb daher „Let me look up your orders first“ und hörte auf, dreimal von dreimal. In der geschalteten Version lag 0,50 unter 0,7, das Chatmodell wählte also selbst, rief checkOrderStatus auf und fand die Bestellung.
Eine Kaufnachricht für toy-076 mit einer Lieferadresse in Pune zeigt den anderen Fall. Der Router wählte purchaseProduct mit einer Konfidenz von 0,81, die Schwelle blieb also geschlossen. Das Chatmodell trug Produkt-ID und Adresse ein, löste die Bestellung aus, und der Judge bewertete den Durchlauf jedes Mal als richtig.
Bewertung der Auswahl mit Phoenix-Annotationen
Ein Konfidenzwert zeigt, wie sicher der Router war, nicht ob der Durchlauf gut verlief. Deshalb bewertete Arize jeden Durchlauf und schrieb die Noten als Annotationen in den Trace. Phoenix unterstützt Annotationen durch Menschen, LLM-Judges und Code-Prüfungen. Arize nutzte die beiden letzten.
- LLM-Judge: Der Tool-Selection-Evaluator von Phoenix liest die Anfrage, die verfügbaren Tools und die Aufrufe des Agenten und urteilt, ob sie richtig waren. Jeder Durchlauf wurde dreimal bewertet, und es zählte das Urteil, in dem sich mindestens zwei Läufe einig waren.
- Code-Prüfung: Vor dem Lauf hielt Arize für jede Nachricht das erwartete erste Tool fest. Die Prüfung ist bestanden, wenn das tatsächlich zuerst aufgerufene Tool übereinstimmt.
Laut Arize macht das einen fehlgeschlagenen Durchlauf selbstdiagnostizierend. Sagen beide Bewertungen nein, lag das Problem bei der Auswahl. Sagt nur der Judge nein, war die Auswahl in Ordnung, und der Fehler liegt in den Argumenten oder der Antwort. Weil die Noten Annotationen sind, lässt sich ein Projekt nach beiden filtern, um alle Durchläufe mit demselben Problem zu finden. Für Teams, die den Vergleich wiederholen wollen, verweist Arize auf Phoenix-Datasets und -Experimente: Eingaben und erwartete Tools kommen in ein Dataset, und jede Agentenversion läuft als Experiment.
Was das für Entwickler von Agenten bedeutet
Für alle, die einen Agenten mit Tool-Aufrufen betreiben, liefert der Beitrag ein konkretes Muster: Der Wahl des Routers vertrauen, wenn die Konfidenz mindestens 0,7 beträgt, andernfalls das Chatmodell wie gewohnt entscheiden lassen. Die Grenze von 0,7 stammt von Arize selbst und beruht auf den 100 Testnachrichten. Das Unternehmen rät Teams, den Schwellenwert für den eigenen Agenten zu ermitteln. Die Ergebnisse stammen zudem aus einem Demo-Shop mit fünf Tools und zeigen daher eine Methode, kein garantiertes Resultat für andere Umgebungen.
Arize AI: AI agent tool selection: The tool your agent almost called