Axelera AI portiert mit KI-Agenten ein 3B-Robotikmodell binnen einer Woche auf seine Europa-Karte
Ein Produktmanager von Axelera AI, kein ML-Ingenieur, hat mit KI-Coding-Agenten und der hauseigenen Sprache AxScript das Vision-Language-Action-Modell GR00T N1.7 mit 3 Milliarden Parametern in rund einer Woche auf eine einzelne Europa-Karte portiert. Laut Axelera optimierte anschließend ein Ingenieur das Modell binnen eines Tages auf 66 ms pro Entscheidung (15 Hz).
- GR00T N1.7, ein VLA mit 3 Mrd. Parametern, läuft laut Axelera auf einer einzelnen Europa-Karte ohne Genauigkeitsverlust gegenüber PyTorch.
- Ein Produktmanager portierte es in rund einer Woche Teilzeitarbeit mit KI-Coding-Agenten und AxScript, für etwa 500 Dollar an Tokens.
- Ein Ingenieur erreichte anschließend 66 ms pro Entscheidung (15 Hz); die Host-CPU brauchte 19,2 Sekunden.
- Europa bietet 200 GB/s Speicherbandbreite, Metis 30 GB/s.
- Die LIBERO-Erfolgsquote lag in jeder Optimierungsstufe bei 20 von 20.
Ein Produktmanager, KI-Agenten und rund 500 Dollar an Tokens
Axelera AI zufolge ist es meist ein langsamer Prozess, komplexe Modelle auf neue Beschleunigerhardware zu bringen. Viele Anbieter stellen nur einen Model Zoo und einen undurchsichtigen Compiler bereit, sodass neue Modellfunktionen Monate auf Compiler-Unterstützung warten müssen. Andere bieten Programmierbarkeit, doch die Leistung können laut Unternehmen nur die eigenen Ingenieure herausholen. Axelera hat AxeleraScript (AxScript) entwickelt, um beides zu bieten.
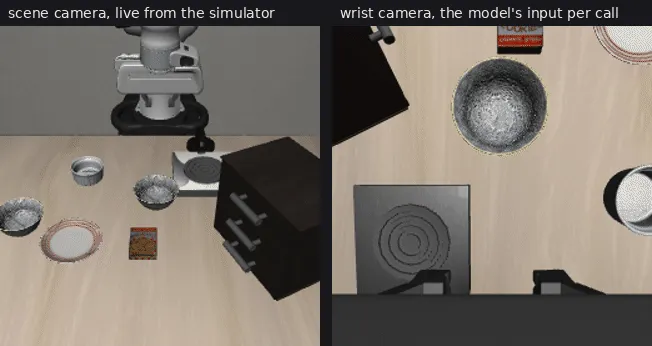
Zum Test ließ der Autor des Beitrags GR00T N1.7, ein Vision-Language-Action-Modell (VLA) mit 3 Milliarden Parametern, auf einer einzelnen Axelera-AI-Europa-Karte laufen. Das Modell steuert einen simulierten Panda-Arm durch LIBERO-Aufgaben, laut Axelera ohne Genauigkeitsverlust gegenüber der PyTorch-Referenz. Der Autor beschreibt die Arbeit als etwa eine Woche Teilzeitaufwand, bei dem er den Agenten alle 4 bis 5 Stunden ansprach, und rund 500 Dollar an Tokens. Sie fand in derselben Woche statt, in der Europa begann, an Kunden auszuliefern.
Die erste lauffähige Version erreichte rund 200 ms pro Entscheidung (5 Hz), wobei alle Transformer des Modells auf der Karte liefen. Ein Axelera-Ingenieur brachte sie dann an einem Tag auf 66 ms (15 Hz), mit dem gesamten Netz einschließlich Action Head auf der Karte.
Warum GR00T ein anspruchsvoller Test ist
GR00T N1.7 kombiniert zwei Modelle. Ein Qwen3-VL-Backbone aus einem Vision Transformer mit 24 Blöcken und 16 Decoder-Schichten liest zwei Kamerabilder und eine Anweisung. Ein Diffusion Transformer mit 32 Blöcken, der Action Head, entrauscht anschließend in vier Flow-Matching-Schritten einen Block von 16 künftigen Roboteraktionen.
Axelera verweist darauf, dass sich generative KI am Edge genau in diese Richtung entwickelt: Milliarden Gewichte, ein Transformer, der pro Entscheidung mehrfach läuft, und ein striktes Echtzeitbudget. Auf der CPU des Testhosts, einem Intel Core i5-13500E, dauerte eine Entscheidung 19,2 Sekunden.
Von Metis zu Europa
Der Autor schrieb einen Plan statt Kernels und ließ Coding-Agenten gegen das Voyager SDK arbeiten, mit einer Regel: zuerst das numerische Orakel bauen. Jede Stufe erhielt eine aufgezeichnete Referenz aus dem echten Checkpoint, und jeder Kernel musste sie reproduzieren, bevor der nächste geschrieben wurde. Die Agenten nutzten für das Backbone die SDK-eigene Qwen3-VL-Pipeline und schrieben den Diffusion Head selbst, als zwei Blockkernel, die in einem Graphen 32-mal instanziiert werden.
Auf der früheren Metis-Hardware senkte das den Policy-Aufruf von 19.200 ms auf der CPU auf 870 ms, bei einem Feature-Kosinus von 0,9995 und einem Ende-zu-Ende-Aktionskosinus von 0,9992 gegenüber PyTorch. Ein halber Tag Optimierung mit dokumentierten Schedule-Parametern und einem Graphen, der Cross-Attention-Keys und -Values nur einmal pro Aufruf projiziert, brachte ihn auf 644 ms, ohne Auswirkung auf die Erfolgsquoten der Aufgaben.
Die Portierung auf Europa dauerte einen Vormittag auf dem Early-Access-SDK, mit demselben Code, den auch Kunden erhalten. Europa hat acht In-Memory-Compute-Kerne, 200 GB/s Speicherbandbreite und 32 GiB auf einer Karte; Metis kommt auf 30 GB/s. Die erste Portierung lief mit 391 ms pro Aufruf, laut Axelera 1,6-mal schneller als das optimierte Metis ohne jedes Tuning.
Ein neuerer Compiler, der laut Unternehmen bald erscheint, dazu die Aufteilung der Gewichte auf zwei Speicherbereiche und das Bündeln beider Kameras in einem Dispatch erreichten 274 ms. Die Reduzierung des Diffusion Head von 33 Kernel-Dispatches pro Schritt auf vier, das Einfalten der Self-Attention in den Priming-Kernel und das Kürzen der Graph-Eingänge brachten 199 ms. Gegenüber dem optimierten Metis nennt Axelera knapp das Sechsfache beim Decoder-Prefill (193 auf 33 ms), fast das Vierfache beim Diffusion Head (256 auf 67 ms) und das 3,2-Fache beim gesamten Aufruf. Gegenüber der Host-CPU ist der Aufruf 96-mal schneller.
Die Erfolgsquote bei den LIBERO-Aufgaben blieb in jeder Stufe bei 20 von 20. Der Aktionskosinus sank in der letzten Spalte von 0,9996 auf 0,9965, bedingt durch den kürzeren kompilierten Kontext, ohne Auswirkung auf den geschlossenen Regelkreis, so der Beitrag.
Die verbleibende Latenz verstecken
Selbst bei 200 ms ist eine synchrone Schleife sichtbar: Der Arm führt acht Schritte aus und hält dann an, während der nächste Block berechnet wird. Axelera zufolge lag die Lösung in der Schleife und nicht in der Modellgeschwindigkeit. Der Action Head von GR00T N1.7 implementiert Real-Time Chunking, das den nächsten Block entrauscht, während der aktuelle noch ausgeführt wird. Der Quelltext bricht vor dem Rest der Erklärung ab.
Was das für Physical AI bedeutet
Der Bericht stammt von Axelera selbst, und die Ergebnisse beruhen auf einem simulierten Arm an einem einzelnen Testhost. Dennoch argumentiert er, dass ein Nicht-Spezialist, der Coding-Agenten gegen AxScript steuert, ein neues Transformer-Modell binnen Tagen auf die Hardware bringen kann und dass Europas Speicherbandbreite für Echtzeit-Robotikmodelle zählt. Für Teams, die Physical AI entwickeln, positioniert das Unternehmen AxScript und Europa als Weg zu Programmierbarkeit und Leistung, ohne auf Compiler-Releases warten zu müssen.