CoreWeave erläutert, wie seine KI-Rechenzentren Strombedarf, Skalierung und Verfügbarkeit meistern sollen
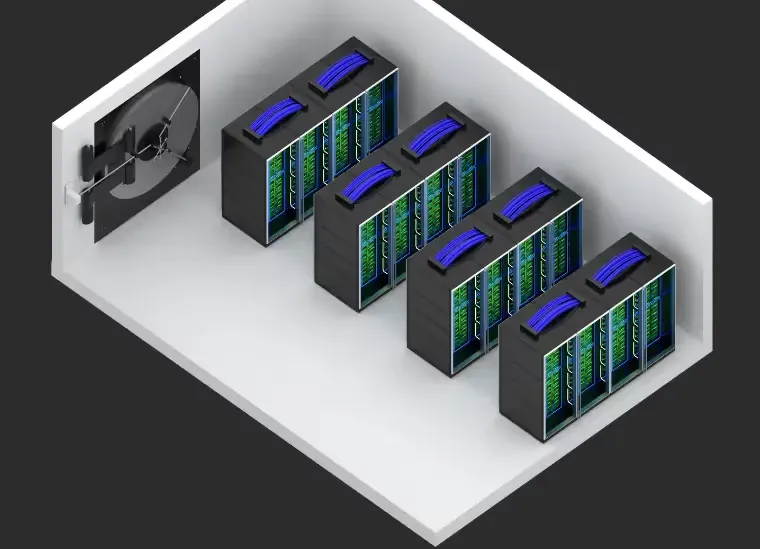
CoreWeave hat seine Kapazitätspläne für die eigenen Rechenzentren veröffentlicht. Das Unternehmen argumentiert, dass speziell gebaute, flüssigkeitsgekühlte Anlagen nötig seien, um die Anforderungen von KI-Megaclustern zu erfüllen. Es nennt vier Herausforderungen, die die KI-Landschaft 2025 und darüber hinaus prägen sollen, und beschreibt, wie es jede davon angeht.
- CoreWeave nennt vier Herausforderungen: Rack-Leistung, Grenzen klassischer Rechenzentren, maximale Performance und flexibel abrufbare Rechenleistung.
- Das Unternehmen erwartet, dass die meisten 2025 eröffnenden Rechenzentren Flüssigkeitskühlung haben, und sagt, seine Designs unterstützten Racks mit rund 130 kW.
- Typische Co-Location-Standorte unterstützen laut CoreWeave meist nur Stellplätze mit 5 bis 10 kW.
- Der Performance-Stack umfasst LOTA-Speicher, NVIDIA-Quantum-2-InfiniBand-Netzwerke und die Mission-Control-Tools für den Knoten-Lebenszyklus.
- CoreWeave gibt an, die breiteste Auswahl der leistungsstärksten NVIDIA-GPUs für flexiblen Bedarf zu bieten.
Steigende Rack-Leistung und das Argument für Flüssigkeitskühlung
Nach Angaben von CoreWeave lässt der Wechsel von verteilten Rechenumgebungen zu Megaclustern mit Hunderten oder Tausenden GPUs in einem einzigen Verbund den Strombedarf stark steigen. Die erste Herausforderung sei daher der höhere Stromverbrauch pro Rack. Das Unternehmen verweist auf NVIDIA Blackwell: Der NVIDIA GB200 NVL72 vereine 72 GPUs in einem einzigen Rack und liefere bis zu 30-mal schnellere Trillionen-Parameter-Inferenz in Echtzeit.
Mehr Leistung bedeute mehr Strombedarf und heißere Chips, so CoreWeave. Typische Co-Location-Standorte unterstützten meist nur Stellplätze mit 5 bis 10 kW, sodass herkömmliche Rack-Konzepte nicht mithalten könnten. Zudem lasse sich diese GPUs allein mit Luftkühlung nicht wirksam kühlen, und die Racks benötigten bis zu viermal mehr Strom.
CoreWeave erwartet, dass die meisten seiner 2025 eröffnenden Rechenzentren über Flüssigkeitskühlung verfügen werden. Statt kleine Teile einer Anlage später nachzurüsten, plane das Unternehmen ganze Rechenzentren um diese Technik herum. Das ermögliche Racks mit rund 130 kW. Dieses Grunddesign könne CoreWeave weiterentwickeln und an verschiedenen Standorten wiederholen, um Kunden eine schnelle Markteinführung zu bieten.
Jenseits klassischer Bauweisen: Partnerschaften, Sicherheit und Performance
Die zweite Herausforderung sei die fehlende Eignung traditioneller Rechenzentrumsdesigns. CoreWeave argumentiert, dass für CPU-Workloads gebaute Anlagen nicht auf GPU-Megacluster mit mehr als 100.000 GPUs und Hunderten Megawatt Leistung ausgelegt seien. Die Antwort des Unternehmens sind speziell für KI errichtete Anlagen und enge Verbindungen zu Hardware- und Rechenzentrumsanbietern. Es könne zentrale Infrastrukturkomponenten gemeinsam mitentwickeln, arbeite praxisnah mit Partnern an besserer Fertigung und besseren Tests, damit spätere Chargen weniger Probleme zeigen, und kooperiere mit NVIDIA. Laut CoreWeave müssen Kunden dadurch nicht auf teure Nachrüstungen warten.
Beim Thema Sicherheit sind laut Unternehmen alle Rechenzentren zugangsbeschränkte Gebäude ohne sichtbare Beschilderung, mit rund um die Uhr anwesendem Sicherheitspersonal. Hinzu kämen luftdichte Zugangsprotokolle sowie ein interner Schutz von Daten und geistigem Eigentum, der Identity-Access-Management und den Zugriff nach dem Prinzip der minimalen Rechte unterstütze.
Die dritte Herausforderung ist die maximale Performance. CoreWeave verweist auf den Llama-3-Bericht von 2024, wonach Modelle innerhalb von 54 Tagen bis zu 420 unerwartete Unterbrechungen erleben können. In der Studie heiße es laut dem von CoreWeave wiedergegebenen Zitat: „Der Ausfall einer einzelnen GPU kann einen Neustart des gesamten Jobs erfordern.“ Solche Ausfälle brächten zeitraubende Unterbrechungen und unnötige Kosten mit sich, so das Unternehmen.
Dagegen führt CoreWeave drei Bestandteile seiner Plattform an:
- Speicher: CoreWeave Local Object Transport Accelerator (LOTA), ein Proxy auf GPU-Knoten, der einen direkteren Weg zwischen GPUs und Daten schafft.
- Netzwerk: Cluster-Netzwerke auf Basis von NVIDIA Quantum-2 InfiniBand mit einem SHARP-fähigen Netzwerk für die Verbindung mehrerer Knoten.
- Mission Control: Fleet Lifecycle Controller und Node Lifecycle Controller, die Bereitstellung, Tests und Überwachung der Knoten automatisieren und selbst leicht unterdurchschnittliche Knoten austauschen.
Flexible Rechenleistung und was das für KI-Teams bedeutet
Die vierte Herausforderung ist der Zugang zu Burst-fähiger Rechenleistung. Laut CoreWeave benötigen nicht alle Workloads gleich viel Rechenleistung, GPUs seien aber extrem gefragt, weshalb das Angebot oft knapp sei. Kunden könnten beim Start eines Trainingslaufs innerhalb von Minuten von völliger Ruhe auf einen Stromverbrauch von mehreren zehn Megawatt springen.
CoreWeave gibt an, die breiteste Auswahl der leistungsstärksten NVIDIA-GPUs anzubieten. Dadurch könne es Pufferkapazität und technische Unterstützung bereitstellen, um große, komplexe Cluster stabil zu halten. Außerdem berücksichtige die Planung des Rechenzentrumsausbaus die Notstromversorgung. An dieser Stelle bricht der Ausgangstext ab, weitere Details dazu liegen daher nicht vor.
Für KI-Unternehmen, die einen Infrastrukturanbieter auswählen, benennt der Beitrag, was CoreWeave als wichtigste Kriterien ansieht: Leistungsdichte, für GPU-Skalierung konzipierte Anlagen, Ausfallsicherheit der Cluster und Zugang zu vielfältiger GPU-Kapazität. Alle Angaben zu Leistung und Kapazität in dem Beitrag stammen vom Unternehmen selbst. Preise, Standorte oder konkrete Kapazitätszahlen einzelner Rechenzentren nennt die Quelle nicht.
CoreWeave: Our Capacity Plans for CoreWeave Data Centers