CoreWeave bietet NVIDIA HGX Rubin NVL8 für Agentic AI und HPC an
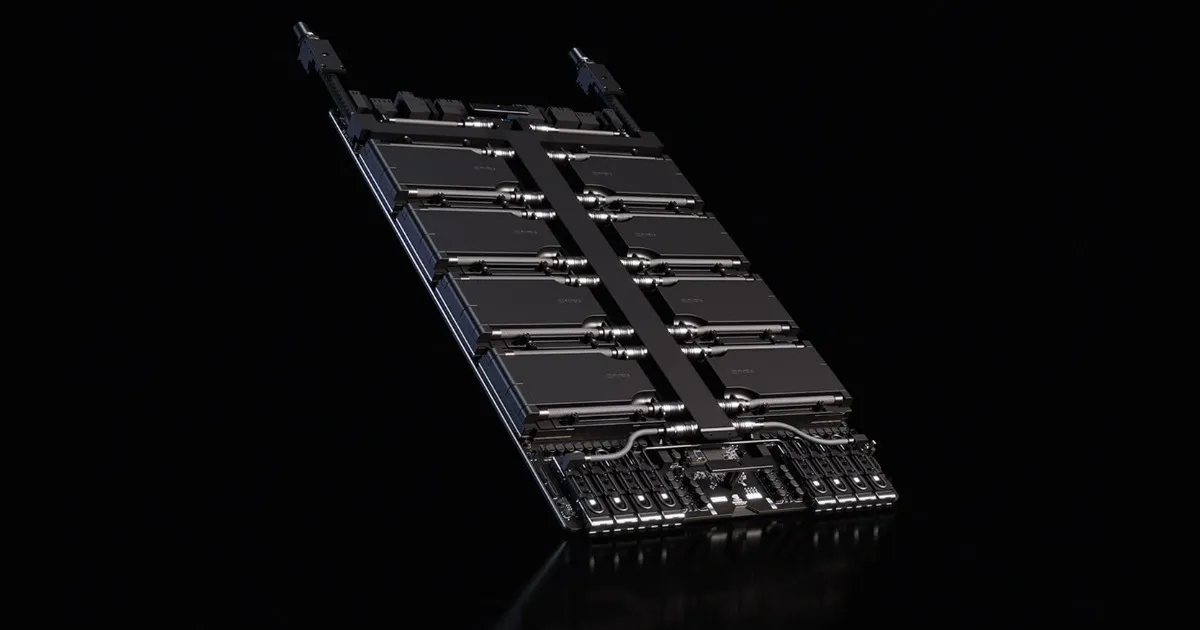
CoreWeave kündigt an, dass NVIDIA HGX Rubin NVL8, ein Acht-GPU-Knoten auf Basis von HBM4-Speicher und NVLink der sechsten Generation, noch in diesem Quartal in der CoreWeave Cloud verfügbar sein wird. Das Unternehmen positioniert das System für Agentic AI, Hochleistungsrechnen (HPC) und umfangreiche Datenanalysen.
- NVIDIA HGX Rubin NVL8 kommt laut CoreWeave noch in diesem Quartal in die CoreWeave Cloud.
- Der Knoten kombiniert acht Rubin SXM GPUs mit 2 TB HBM4 und 130 TB/s aggregierter Speicherbandbreite.
- NVIDIA gibt bis zu zehnmal höheren Token-Durchsatz und gleiche Trainingsleistung mit viermal weniger GPUs an.
- Das System ist zu 100 Prozent flüssiggekühlt und wird über CoreWeave Mission Control, CKS und SUNK verwaltet.
- Kunden können ein Briefing oder einen ARENA Pass anfordern, um Workloads zu testen.
Das bietet der HGX-Rubin-NVL8-Knoten
HGX Rubin NVL8 vereint acht NVIDIA Rubin SXM GPUs auf einer einzigen Baseboard. CoreWeave weist darauf hin, dass bei Agentic AI, umfangreichen Analysen und HPC häufig Speicherkapazität und Speicherbandbreite den Engpass bilden. Der Knoten sei genau auf dieses Problem ausgelegt.
Laut CoreWeave gibt NVIDIA an, das System liefere bis zu zehnmal höheren Token-Durchsatz als frühere Architekturen und erreiche dieselbe Trainingsleistung mit viermal weniger GPUs. NVIDIA prognostiziert zudem bis zu zehnmal mehr Tokens pro Sekunde pro Megawatt als HGX B200 beim Betrieb von Kimi K2 Thinking (4K Input/4K Output) und erklärt, der Knoten erreiche beim Training von DeepSeek-R1 den Durchsatz von HGX B200 mit viermal weniger GPUs.
Die wichtigsten genannten Spezifikationen:
- Speicher: insgesamt 2 TB HBM4 und 130 TB/s aggregierte Speicherbandbreite.
- Interconnect: NVLink der sechsten Generation mit 24 TB/s NVLink-Switch-Bandbreite innerhalb des Knotens.
- Scale-out-Netzwerk: acht NVIDIA ConnectX-9 SuperNICs, die bis zu 800 Gb/s Backend-Konnektivität pro GPU bereitstellen.
- Offload: NVIDIA BlueField-4 für die Frontend-Anbindung, mit Offloads für Netzwerk, Storage und Sicherheit, die Ressourcen der Host-CPU schonen.
Wo CoreWeave den Einsatz sieht
Für Agentic AI argumentiert CoreWeave, dass die 2 TB HBM4 große Key-Value-Caches für Kontextfenster mit einer Million Token aufnehmen können, sodass mehrere Agentensitzungen gleichzeitig aktiv bleiben. Außerdem könnten Einzelknoten-Deployments sowohl Modelle als auch Caches ausführen, und die NVLink-Bandbreite von 24 TB/s beseitige die Latenz der Fabric beim Tensor-parallelen Serving.
Bei der Datenanalyse verweist das Unternehmen auf GPU-beschleunigtes ETL, Dataframe-Abfragen, Vektorindizierung und die Erzeugung von Embeddings, die über das Backend-Netzwerk knotenübergreifend skalieren. Die 130 TB/s Speicherbandbreite sorge bei großen Pipelines für überlegene Kosten pro verarbeiteter Zeile.
Für HPC nennt CoreWeave 265 TFLOPS FP64-Leistung mit doppelter Genauigkeit pro Acht-GPU-Knoten, gedacht für wissenschaftliche Simulationen, Molekulardynamik und Computational Finance. Zudem beschreibt das Unternehmen hybride Pipelines, die klassische Simulationen mit KI-Surrogatmodellen auf derselben Hardware kombinieren.
Als Beispiele für die praktische Wirkung nennt CoreWeave ein Team in der Wirkstoffforschung, das pro Tag mehr Kandidatenstoffe durchmustern könnte, und ein Finanzdienstleister, der die Risikoanalysen der Tagestransaktionen vor Marktöffnung erneut laufen lassen könnte.
Die CoreWeave-Plattform rund um die Hardware
CoreWeave erklärt, als Erstes der Branche Bring-up, Validierung und Benchmarking von NVIDIA Vera Rubin NVL72 abgeschlossen zu haben. Laut dem Unternehmen erzielte der Kunde Cognition auf diesem System einen 4,8-fach höheren SWE-2-Inferenzdurchsatz und eine 3,8-fach schnellere Ausgabe-Token-Geschwindigkeit für RL.
HGX Rubin NVL8 ist zu 100 Prozent flüssiggekühlt. CoreWeave Mission Control überwacht die Infrastruktur als ein System, von der Stromversorgung und Kühlung der Racks bis zum GPU-Verhalten. Für die Kühlung hat CoreWeave zwei Komponenten selbst entwickelt: Racky, den Kontrollpunkt auf Rack-Ebene, und Valvey, der Kühl- und Isolationsaktionen ausführt. Ein Rack Life Cycle Controller orchestriert Bring-up-, Health- und Recovery-Workflows.
Weitere Bausteine der Plattform sind der CoreWeave Kubernetes Service (CKS), eine verwaltete Cluster-Grundlage, sowie SUNK, das Slurm-Scheduling mit Kubernetes-Containerisierung verbindet, sodass Teams HPC- und Datenverarbeitungsjobs auf gemeinsam genutzter Infrastruktur ausführen können. Kunden erhalten zudem Direct-to-Expert Support von den Ingenieuren, die Systeme der Rubin-Generation in Betrieb genommen haben.
Was das für Kunden bedeutet
Teams, die Agentic-AI-, Analyse- oder HPC-Workloads in der CoreWeave Cloud betreiben, können in diesem Quartal mit Hardware der Rubin-Generation planen. CoreWeave lädt Kunden ein, ein Briefing zu Kapazitätsplanung, Onboarding-Zeitplan und Eignung des jeweiligen Workloads anzufordern oder einen ARENA Pass zu beantragen, um die eigene Workload auf HGX Rubin NVL8 zu testen. Die Leistungsangaben stammen von NVIDIA und CoreWeave, Preise oder detaillierte Verfügbarkeitsbedingungen nennt die Quelle nicht.