CoreWeave bringt NVIDIA Vera Rubin NVL72 in die Cloud, Cognition ist erster Kunde
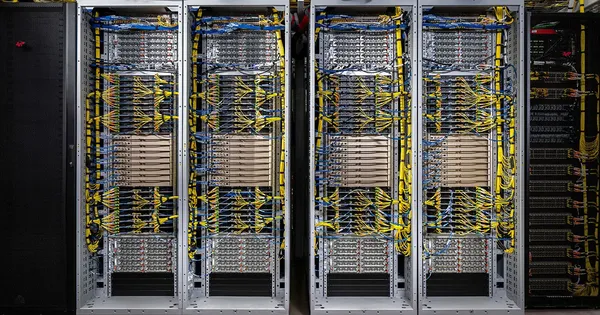
CoreWeave hat die Verfügbarkeit von NVIDIA Vera Rubin NVL72 Systemen mit Spectrum-X 102.4T Ethernet in seiner Cloud angekündigt. Erster Kunde mit produktiven Workloads auf der Plattform ist Cognition, das Labor hinter dem KI-Softwareentwickler Devin. Außerdem hat das Unternehmen CoreWeave Forge vorgestellt, eine vernetzte Umgebung zum Trainieren, Evaluieren und Verbessern von Modellen und Agenten.
- CoreWeave hat die Verfügbarkeit von NVIDIA Vera Rubin NVL72 mit Spectrum-X 102.4T Ethernet angekündigt, Cognition ist erster Produktivkunde.
- Cognition maß in frühen Tests bis zu 4,8-mal höheren Gesamt-Token-Durchsatz bei SWE-2-Inferenz gegenüber GB200 NVL72.
- Die NVIDIA-Vera-CPU kommt in die CoreWeave Cloud, im Test starten Agenten-Sandboxes mehr als dreimal so schnell.
- CoreWeave Forge vereint Weights & Biases, OpenPipe und marimo, ARIA und Sandboxes sind jetzt allgemein verfügbar.
- Canva, Capital One und MasterClass gehören zu den ersten Unternehmen, die auf Forge aufbauen.
Cognition misst bis zu 4,8-fachen Token-Durchsatz
Die Ankündigung erfolgte auf der CoreWeave Fully Connected in San Francisco. Laut NVIDIA erhielt CoreWeave seine ersten Vera Rubin NVL72 Produktions-Racks Anfang des Monats und richtete binnen weniger Tage einen Produktionscluster für Cognition ein.
Cognition betreibt bei CoreWeave Training, Reinforcement Learning und produktive Inferenz für Devin. Das Unternehmen verglich Vera Rubin mit einer GB200-NVL72-Basis anhand einer realen Software-Engineering-Last: Aus FrontierCode wurde eine Teilmenge von Aufgaben gezogen, die KI-Agenten lösen sollten. In frühen Tests erzielte Vera Rubin NVL72 nach Angaben von Cognition bei SWE-2-Inferenz-Workloads bis zu 4,8-mal so hohen Gesamt-Token-Durchsatz wie GB200 NVL72. Für Devin bedeutet das laut NVIDIA schnellere Codegenerierung in Echtzeit und reaktionsschnelleres mehrstufiges Schlussfolgern.
"Agentisches Programmieren ist eine komplexe Last: lange Kontexte, hohe Parallelität und Token-Mengen, bei denen die Kosten pro Token darüber entscheiden, was wir ausliefern können", sagte Silas Alberti, Mitglied des Gründerteams von Cognition.
Die Kapazitäten lassen sich über CoreWeave Kubernetes Service, SUNK, CoreWeave Mission Control, CoreWeave Sandboxes und CoreWeave Inference betreiben. Early-Access-Kunden können die Plattform in der CoreWeave Cloud nutzen.
Vera-CPU zielt auf Agenten-Sandboxes
CoreWeave will außerdem NVIDIA Vera anbieten, die laut Beschreibung erste CPU, die speziell für KI-Agenten gebaut wurde. NVIDIA sieht agentische KI als Belastung für die Infrastruktur aus zwei Richtungen: Der Betrieb von Agenten erfordert latenzarme Rechenleistung in großem Maßstab, während das Post-Training Tausende isolierte Umgebungen gleichzeitig verlangt.
CoreWeaves Vera-Implementierung bringt 128 CPUs und 11.264 Kerne in einem einzigen Rack unter, genug für mehr als 11.000 parallele Umgebungen mit je einem Kern. Spectrum-X-Ethernet-Switches und BlueField-4-DPUs übernehmen die sichere, latenzarme Kommunikation der Agenten.
In Tests meldete CoreWeave mehr als dreimal so schnelle Startzeiten für Agenten-Sandboxes auf Vera-CPUs. Im Terminal-Bench verzeichnete das Unternehmen bei allen bestandenen Aufgaben einen Leistungsgewinn von 1,7x auf der Vera-CPU.
CoreWeave Forge verbindet Produktion und Training
Forge soll den Kreislauf schließen, in dem das Verhalten in der Produktion den nächsten Trainingslauf prägt und jede Evaluation die nächste Version verbessert. NVIDIA zufolge war dieser Kreislauf bislang auf Tools verschiedener Anbieter verteilt, wobei an jeder Übergabe Signale verloren gingen. Forge kombiniert Weights & Biases, das Post-Training-Know-how von OpenPipe und das Open-Source-Notebook-Projekt marimo und bleibt offen für verschiedene Modelle, Frameworks und Clouds.
- CoreWeave ARIA, jetzt allgemein verfügbar, analysiert Läufe, schlägt Experimente vor und empfiehlt Codeänderungen, die in GitHub gespeichert werden.
- CoreWeave Agent Lens, ein neuer Dienst, macht aus der Observability von Produktionsagenten konkrete Verbesserungen. Laut der Quelle verbessert er die Fehlererkennung um 20 % und behebt Probleme zu halb so hohen Kosten.
- CoreWeave Sandboxes, jetzt allgemein verfügbar, führen Agenten, Tool-Aufrufe, RL und Evaluationen in isolierten CPU- oder GPU-Umgebungen aus.
- Serverloses Supervised Fine-Tuning und serverloses RL ermöglichen es, eigene Trainingsrezepte zu testen. Serverloses RL trainiert 1,4-mal schneller und 40 % günstiger als ein selbst verwaltetes Setup.
- RL Rollouts, in der privaten Preview, lädt neue Checkpoints in ein laufendes Deployment, sodass Reinforcement Learning ohne erneutes Deployment weiterläuft. Es basiert auf NVIDIA Dynamo, ebenso wie CoreWeaves verwalteter Inferenzdienst.
Canva, Capital One und MasterClass gehören zu den ersten Unternehmen, die auf Forge aufbauen. Die offenen NVIDIA-Nemotron-Modelle bieten Forge-Teams einen Weg, Reasoning- und multimodale Modelle anzupassen und bereitzustellen.
Kunden und Einordnung
Ennoble Care, ein Anbieter häuslicher Pflege, der rund 50.000 Medicare-Patienten mit hohem Versorgungsbedarf in 15 Bundesstaaten betreut, hat sich für CoreWeave bei klinischer KI-Inferenz entschieden. Das Unternehmen will reservierte NVIDIA-RTX-PRO-6000-GPU-Kapazitäten auf dem CoreWeave Kubernetes Service nutzen, um KI-Agenten für klinische Dokumentation, Entscheidungsunterstützung und Back-Office-Automatisierung zu skalieren.
CoreWeave gibt an, in SemiAnalysis ClusterMAX 1.0, 2.0 und 3.0 den Platinum-Rang zu halten und neun der zehn führenden KI-Labore zu bedienen. NVIDIAs Ian Buck merkte an, dass CoreWeaves V100-GPUs fast ein Jahrzehnt nach dem Start von Volta noch immer Kunden-Workloads ausführen, während Vera Rubin NVL72 in Produktion geht.
Für Teams, die Coding- und andere Agenten entwickeln, bündelt die Ankündigung neue Hardware, CPU-Kapazität für Sandboxes und Werkzeuge für den Trainingskreislauf in einer Cloud. Die Leistungsangaben stammen aus frühen Tests von Cognition und CoreWeave und wurden laut Quelle nicht unabhängig überprüft.