ITU-Runde verknüpft Zugang zu KI-Infrastruktur mit Standards und digitalem Vertrauen
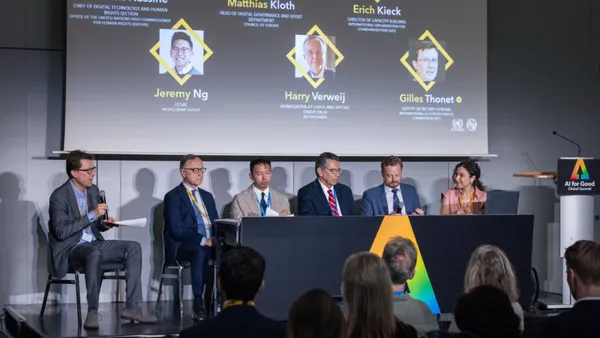
Bei einer hochrangigen Gesprächsrunde auf dem AI for Good Global Summit 2026 ging es darum, wie der ungleiche Zugang zu KI-Infrastruktur mit dem Bedarf an gemeinsamen Standards und Vertrauensmechanismen zusammenhängt. Seizo Onoe von der ITU kündigte zudem eine Standardisierungsinitiative zu Identität und Vertrauenszeichen für KI an.
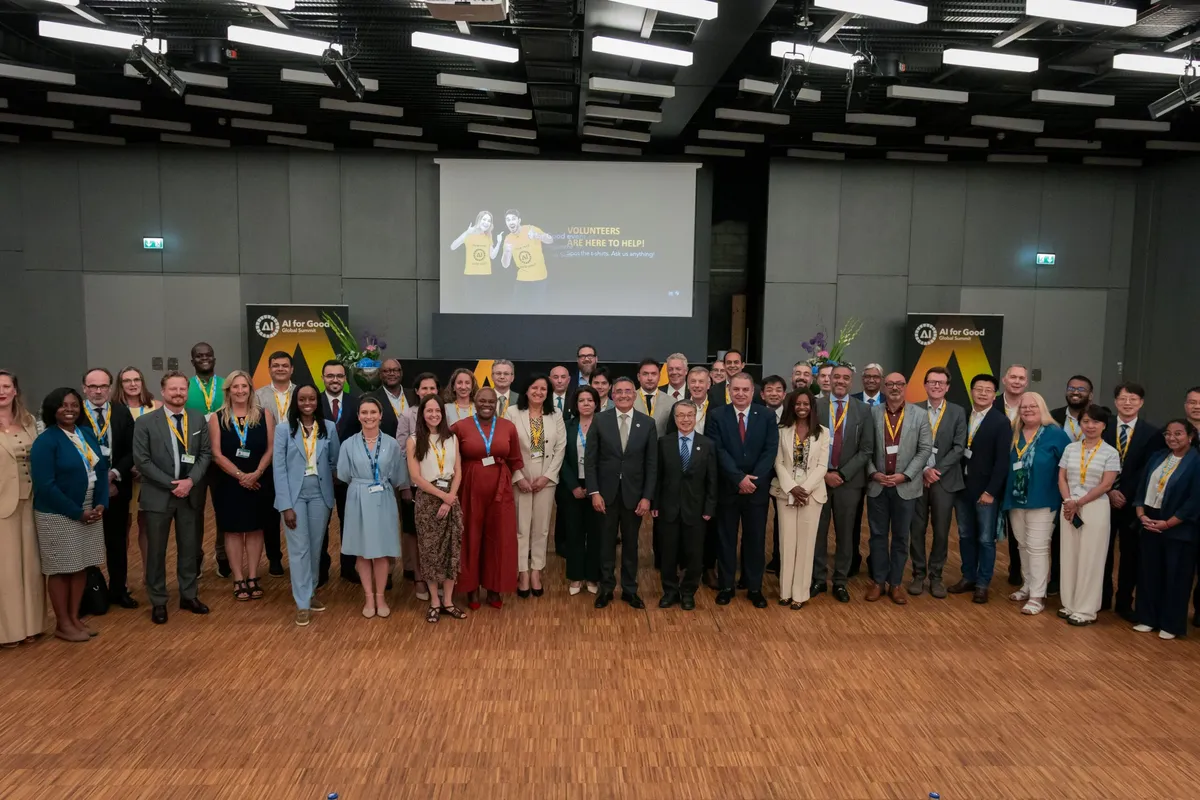
- An der Gesprächsrunde beim AI for Good Global Summit 2026 nahmen mehr als fünfzig hochrangige Vertreterinnen und Vertreter teil, darunter achtzehn Minister und hochrangige Regierungsvertreter.
- ITU-TSB-Direktor Seizo Onoe kündigte eine Standardisierungsinitiative zu Identität und Vertrauenszeichen für KI an.
- Laut den Teilnehmenden verfügen nur sechzehn Länder über Recheninfrastruktur im großen Maßstab, und Länder mit hohem Einkommen halten 97 % der Kapazität der 500 größten Hochleistungsrechner.
- Die Teilnehmenden forderten überprüfbare Agentenidentitäten, widerrufbare Berechtigungen und Prüfpfade, wobei die Verantwortung bei einem Menschen oder einer Institution bleiben soll.
- Unterschiede bei Souveränität, Lokalisierung und Regulierung blieben bestehen.
Wer teilnahm und was angekündigt wurde
Die Gesprächsrunde mit dem Titel "AI foundation: Digital trust and AI infrastructure for all" fand am ersten Tag des Gipfels statt. Nach Angaben der ITU kamen dabei mehr als fünfzig hochrangige Vertreterinnen und Vertreter aus Regierungen, Industrie, Normungsorganisationen und Wissenschaft zusammen. Darunter waren achtzehn Minister und hochrangige Regierungsvertreter, mehr als vierundzwanzig Unternehmen aus der Privatwirtschaft sowie zwölf internationale Organisationen und akademische Einrichtungen.
Die Sitzung fand unter der Chatham House Rule statt, sodass Ideen wiedergegeben werden durften, ohne Rednerinnen und Redner zu nennen. In öffentlichen Eröffnungsworten sagte Seizo Onoe, Direktor des ITU-Büros für Telekommunikationsstandardisierung (TSB), Innovation solle dem Gemeinwohl dienen, und jedes Land solle von KI profitieren, eigene Innovationen entwickeln und Lösungen für lokale Bedürfnisse aufbauen können. Außerdem kündigte er eine ITU-Standardisierungsinitiative an, die sich auf Identität und Vertrauenszeichen für KI konzentriert. Bilel Jamoussi, stellvertretender Direktor des ITU TSB, moderierte die Gespräche zu drei Themen: KI-Infrastruktur und Inklusion, KI-Standards für die Industrie sowie agentische KI und digitales Vertrauen.
Konzentrierte Rechenleistung und die Souveränitätsdebatte
Die erste Diskussion drehte sich um die Frage, wer KI-Infrastruktur aufbaut, besitzt und von ihr profitiert. Die Teilnehmenden nannten Zahlen, die zeigen, wie stark Rechenkapazität konzentriert ist: Nur sechzehn Länder verfügen über Recheninfrastruktur im großen Maßstab, während fast zwei Milliarden Menschen weiterhin offline sind. Auf Länder mit hohem Einkommen entfallen 86 % der 500 weltweit leistungsstärksten Hochleistungsrechner und 97 % ihrer Kapazität. Entwicklungsländer außerhalb Chinas stellen die Hälfte der weltweiten Internetnutzer, aber weniger als 10 % der globalen Rechenzentrumskapazität.
Energie wurde als zentrale Beschränkung genannt. Die Teilnehmenden verwiesen auf Schätzungen der Internationalen Energieagentur, wonach der Stromverbrauch von Rechenzentren bis 2030 auf rund 945 Terawattstunden steigen könnte, etwa das Doppelte des heutigen Niveaus. In Afrika, wo etwa 90 % der Daten außerhalb des Kontinents gespeichert werden, kann Strom bei der Standortwahl für Infrastruktur ein größeres Hindernis sein als Konnektivität.
Bei der KI-Souveränität gingen die Ansichten auseinander. Mehrere Teilnehmende warnten davor, sie als nationalen Besitz jeder Ebene des KI-Stacks zu definieren, da dies die Fragmentierung und die Investitionskosten erhöhen könne. Andere argumentierten, Länder bräuchten Kontrolle über ausgewählte Ebenen der Infrastruktur, der Daten oder der Rechenkapazität. Als mögliche Ansätze wurden regionale Rechenverbünde, Cloud-first-Strategien, gemeinsam genutzte Infrastruktur und Rahmenwerke für Datenbotschaften genannt. Der Moderator fasste zusammen, Länder wünschten sich mehr KI-Souveränität, aber nicht auf Kosten der internationalen Zusammenarbeit.
Als Hürden für die Teilhabe wurden begrenzter Zugang zu Geräten, Rechenkapazität, moderner Hardware und lokal repräsentativen Sprachmodellen genannt. Als Beispiele wurden Investitionen in KI-Fabriken, Gigafactories, Supercomputing-Zentren und Cloud-Infrastruktur sowie nationale KI-Gesetze und subventionierter Zugang zu Rechenressourcen angeführt.
Horizontale und sektorspezifische Standards aufeinander abstimmen
Das zweite Thema betraf die Fragmentierung zwischen horizontalen KI-Standards, die branchenübergreifende Anforderungen festlegen, und sektorspezifischen Standards für Bereiche wie Gesundheitswesen, Telekommunikation, Medizinprodukte und Verkehr. Die Teilnehmenden waren sich einig, dass beide nötig sind. Die Sorge war, dass ihre getrennte Entwicklung zu sich überschneidenden Anforderungen, uneinheitlichen regulatorischen Erwartungen, doppelten Prüfungen und Handelshemmnissen führen kann.
Zu den vorgeschlagenen Arbeiten gehörten, horizontale Standards mit besonders folgenreichen sektorspezifischen Anwendungsfällen abzugleichen, die Koordination zwischen KI-Fachleuten und Branchenexperten zu verbessern sowie gemeinsame Leitlinien und Wege der Konformitätsbewertung zu entwickeln. Diese Schritte könnten Aufsichtsbehörden, Herstellern und Nutzern helfen zu erkennen, welche Anforderungen gelten und wie sich die Einhaltung nachweisen lässt. Die Arbeit baut auf der World Standards Cooperation von ISO, IEC und ITU auf, die seit neun Jahren mit dem übrigen UN-System an sektorspezifischen KI-Standards arbeitet, unter anderem in Gesundheitswesen, Bildung und Landwirtschaft.
Vertrauensanforderungen für KI-Agenten
Das letzte Thema befasste sich mit KI-Agenten, die über Plattformen, Organisationen und Rechtsordnungen hinweg handeln. Die Teilnehmenden stellten fest, dass viele bestehende Regulierungsrahmen von einem System ausgehen, dessen Zweck und vernünftigerweise vorhersehbares Verhalten sich im Voraus festlegen lassen. Agenten könnten dagegen verhandeln, Transaktionen ausführen, sich mit anderen Agenten abstimmen und Ziele über mehrere Systeme hinweg verfolgen, was Fragen zu Aufsicht und Verantwortlichkeit aufwirft.
- Agenten brauchen überprüfbare Identitäten und Möglichkeiten nachzuweisen, dass sie für eine bestimmte Person oder Institution handeln.
- Ihre Befugnisse und Berechtigungen sollten klar definiert und maschinenlesbar sein und sich einschränken, aussetzen oder widerrufen lassen.
- Übertragbare Einwilligungen, Prüfpfade, Herkunftsnachweise und Verifizierung sollen es ermöglichen, die Handlungen eines Agenten und deren Folgen nachzuvollziehen.
- Die Verantwortung sollte bei einem Menschen oder einer Institution als Auftraggeber bleiben und nicht auf das KI-System übergehen.
Die Teilnehmenden erklärten, Modellentwickler allein könnten diese Mechanismen nicht etablieren, wenn Agenten über Anbieter, Branchen und nationale Systeme hinweg arbeiten, und betonten die Bedeutung interoperabler Standards. Zudem verwiesen sie darauf, dass zwischen Agenten innerhalb einer Organisation und solchen im offenen Internet unterschieden werden müsse.
Was das bedeutet
Laut ITU zeigte die Gesprächsrunde Übereinstimmung bei Interoperabilität, gemeinsam genutzter Infrastruktur, klarer Verantwortlichkeit und internationaler Zusammenarbeit. Zugleich hielt sie fortbestehende Differenzen bei Souveränität, Lokalisierung und Regulierung fest. Die angekündigte Initiative zu Identität und Vertrauenszeichen deutet darauf hin, dass die ITU die Diskussion über Vertrauen in KI-Agenten in die formale Standardisierungsarbeit überführen will.
ITU AI for Good: Building the foundations for AI infrastructure and trust