LangChain katapultiert Coding-Agent von außerhalb der Top 30 in die Top 5, nur durch Änderungen am Harness
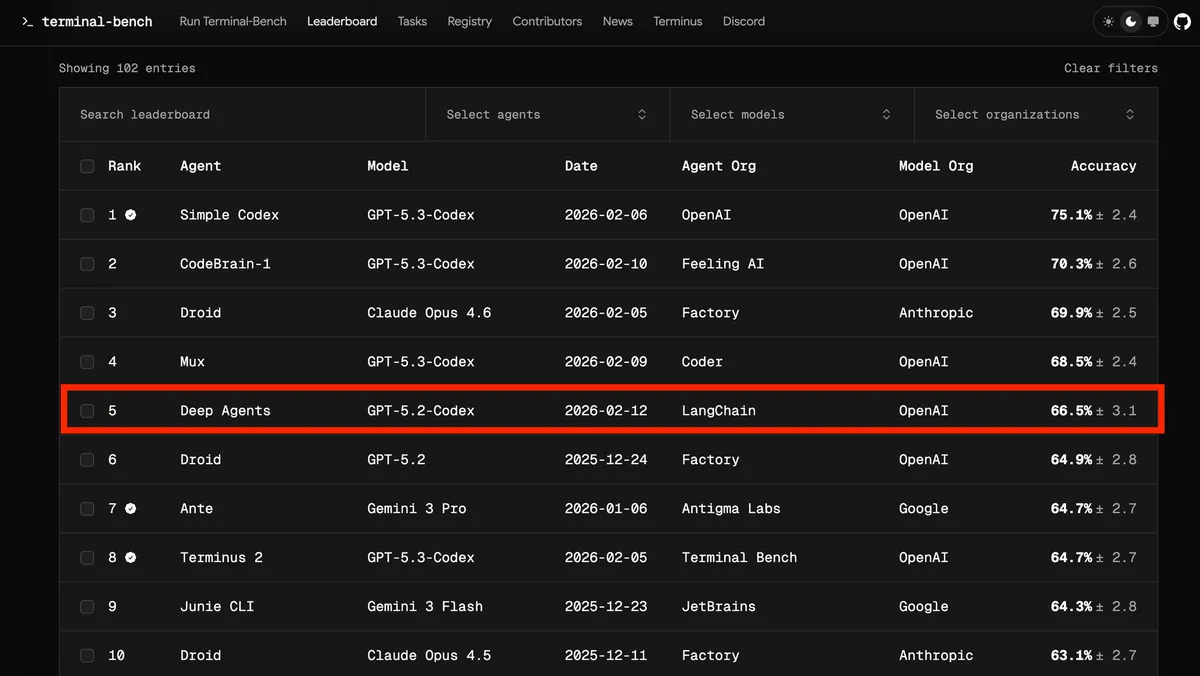
Der Coding-Agent deepagents-cli von LangChain ist nach Unternehmensangaben im Terminal Bench 2.0 von außerhalb der Top 30 in die Top 5 aufgestiegen, allein durch Änderungen am Harness rund um das Modell. Der Wert stieg um 13,7 Punkte von 52,8 auf 66,5, das Modell blieb dabei mit gpt-5.2-codex unverändert.
- Der deepagents-cli von LangChain stieg im Terminal Bench 2.0 von 52,8 auf 66,5 und rückte laut Unternehmen von außerhalb der Top 30 in die Top 5 vor.
- Nur das Harness wurde geändert; das Modell blieb mit gpt-5.2-codex konstant.
- Die Änderungen betrafen System-Prompt, Tools und Middleware, darunter Verifikation vor Abschluss und Schleifenerkennung.
- Ein Reasoning-Setup aus xhigh, high und xhigh erreichte 66,5 %, gegenüber 53,9 % nur mit xhigh und 63,6 % mit high.
- LangChain plant, seinen Trace Analyzer Skill zu veröffentlichen.
Was LangChain geändert hat und wie gemessen wurde
In einem Beitrag von Vivek Trivedy beschreibt LangChain Harness Engineering als den Bau von Werkzeugen rund um ein Modell, um dessen "inherently spiky intelligence" (also seine von Natur aus ungleichmäßige Intelligenz) für bestimmte Aufgaben zu formen. Zu den Designentscheidungen zählen der System-Prompt, die Auswahl der Tools und der Ausführungsablauf, mit Zielen wie Aufgabenleistung, Token-Effizienz und Latenz.
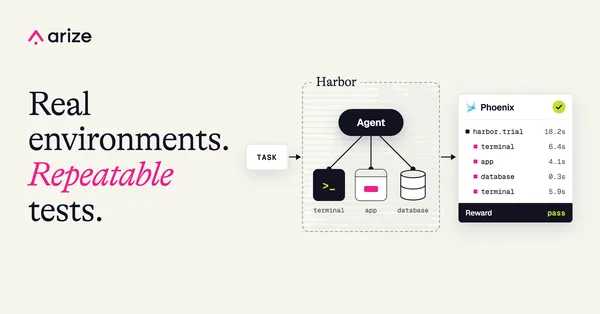
Das Team nutzte den Terminal Bench 2.0 mit 89 Aufgaben aus Bereichen wie Machine Learning, Debugging und Biologie. Die Läufe wurden mit Harbor orchestriert, das Sandboxes über Daytona startet, mit der Agentenschleife interagiert und Verifikation sowie Bewertung übernimmt. Jede Aktion des Agenten wurde in LangSmith gespeichert, zusammen mit Latenz, Token-Zahlen und Kosten.
Von den vielen möglichen Stellschrauben beschränkte sich LangChain auf drei: den System-Prompt, die Tools und die Middleware, so nennt das Unternehmen Hooks rund um Modell- und Tool-Aufrufe. Die Baseline mit Standard-Prompt sowie Standard-Tools und -Middleware erreichte laut LangChain mit GPT-5.2-Codex 52,8 %.
Um die Schwachstellen zu finden, baute das Team einen Trace Analyzer Skill. Er holt Experiment-Traces aus LangSmith, startet parallele Agenten zur Fehleranalyse, deren Ergebnisse ein Hauptagent zusammenführt, und bündelt das Feedback anschließend zu gezielten Änderungen am Harness. LangChain vergleicht das mit Boosting, da der Ansatz sich auf Fehler aus früheren Läufen konzentriert. Ein Mensch kann die vorgeschlagenen Änderungen prüfen, zwingend ist das aber nicht. Das Unternehmen warnt, dass auf eine Aufgabe überangepasste Änderungen anderswo zu Rückschritten führen können, und kündigt an, den Skill zu veröffentlichen.
Selbstverifikation, Umgebungskontext und Schleifenerkennung
Der häufigste Fehler, den LangChain fand: Der Agent schrieb eine Lösung, las seinen eigenen Code erneut, hielt ihn für in Ordnung und hörte auf. Dagegen ergänzte das Team im System-Prompt eine Anleitung in vier Schritten: Planung und Erkundung, Umsetzung, Verifikation und Korrektur. Der Prompt weist den Agenten an, Tests zu schreiben, falls keine existieren, sowohl den Normalfall als auch Randfälle abzudecken und die Testausgabe mit der gestellten Aufgabe abzugleichen statt mit dem eigenen Code.
Eine PreCompletionChecklistMiddleware fängt den Agenten vor dem Beenden ab und erinnert ihn daran, eine Verifikation gegen die Aufgabenspezifikation durchzuführen. LangChain vergleicht das mit einem Ralph Wiggum Loop, bei dem ein Hook den Agenten beim Beenden zum Weiterarbeiten zwingt.
Weitere Änderungen zielten darauf, dem Agenten Wissen über seine Umgebung zu geben:
- Verzeichniskontext und Tooling: Eine LocalContextMiddleware erfasst zu Beginn das Arbeitsverzeichnis und verwandte Verzeichnisse und führt Bash-Befehle aus, um Werkzeuge wie Python-Installationen zu finden.
- Testbarer Code: Die Prompts sagen dem Agenten, dass seine Arbeit durch programmatische Tests bewertet wird und dass Dateipfade aus den Aufgabenspezifikationen exakt einzuhalten sind.
- Zeitbudget: Eingeblendete Warnungen drängen den Agenten, fertig zu werden und zur Verifikation überzugehen, da Agenten laut LangChain "famously bad at time estimation" sind (bekanntermaßen schlecht in der Zeitschätzung).
Eine LoopDetectionMiddleware zählt über Tool-Call-Hooks die Bearbeitungen pro Datei. Nach N Änderungen an derselben Datei fügt sie Kontext hinzu, der dem Agenten nahelegt, seinen Ansatz zu überdenken. In manchen Traces fand LangChain mehr als zehn kleine Variationen desselben fehlerhaften Ansatzes. Das Modell könne trotzdem weiter denselben Weg gehen, heißt es, und die Schutzvorrichtung sei eine Heuristik, die mit besseren Modellen wohl überflüssig werde.
Das Reasoning-Sandwich
LangChain justierte außerdem, wie viel Rechenaufwand das Modell für das Reasoning einsetzt. gpt-5.2-codex bietet vier Modi: low, medium, high und xhigh. Mehr Reasoning hilft, jeden Schritt zu bewerten, kann laut dem Beitrag aber über doppelt so viele Token und Zeit verbrauchen, was angesichts der Zeitlimits im Terminal Bench ins Gewicht fällt.
Das Team wählte als Ausgangspunkt ein "Reasoning-Sandwich" aus xhigh, high und xhigh, bei dem Planung und abschließende Verifikation mehr Aufwand erhalten. Ein Lauf ausschließlich auf xhigh erreichte wegen Timeouts des Agenten nur 53,9 %, gegenüber 63,6 % auf high. Laut LangChain zeigten Testläufe keine großen Unterschiede zwischen verschiedenen Aufteilungen des Reasoning-Budgets, weshalb man beim Sandwich blieb, das den Wert auf 66,5 % hob.
Der Beitrag fügt hinzu, adaptives Reasoning, bei dem das Modell selbst über seinen Rechenaufwand entscheidet, sei der naheliegende Ansatz und finde sich in Claude- und Gemini-Modellen. In einem Multimodell-Harness könnte ein großes Modell planen und die Umsetzung an ein kleineres übergeben, so der Vorschlag.
Was das für Entwickler von Agenten bedeutet
Die Ergebnisse deuten darauf hin, dass beim agentischen Coding Verbesserungen nicht nur vom Modell selbst, sondern auch vom System drumherum kommen können. LangChains erklärte Sicht: Die Aufgabe des Harness Engineers sei es, Kontext vorzubereiten und bereitzustellen, damit Agenten Arbeit eigenständig erledigen können. Die Erkenntnisse legen nahe, Traces als praktische Quelle für Verbesserungen zu nutzen, wobei Selbstverifikation und Tracing als besonders hilfreich hervorgehoben werden. Der Quelltext bricht vor der vollständigen Liste der praktischen Erkenntnisse des Beitrags ab.
LangChain: Improving Deep Agents with harness engineering