MLCommons erweitert MLPerf Training um zwei KI-Workload-Benchmarks
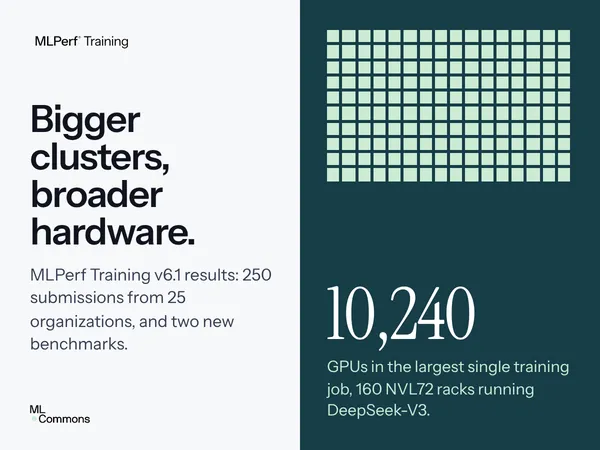
MLCommons hat die Ergebnisse von MLPerf Training v6.1 veröffentlicht. Neu sind Benchmarks für Empfehlungssysteme und groß angelegtes Post-Training. Zudem beteiligen sich mehr Anbieter von KI-Hardware. Die aktuelle Runde umfasst 153 Systeme, 250 Testergebnisse und Systeme von Einzelknoten-Installationen bis zu einem System mit 10.240 Beschleunigern.
- MLPerf Training v6.1 ergänzt DLRMv4-HSTU und Qwen3.5-397B.
- Die Runde umfasst 153 Systeme und 250 Testergebnisse.
- 57 Systeme waren cloud-basiert, was 37 % der Gesamtzahl entspricht.
- Das größte System nutzte 10.240 Beschleuniger.
- Die Ergebnisse umfassen erstmals NVIDIA-Rubin-GPUs und Google TPUv7.
Zwei Benchmarks bilden veränderte KI-Workloads ab
MLPerf Training v6.1 ergänzt DLRMv4-HSTU als Benchmark für Empfehlungssysteme und Qwen3.5-397B als Workload für das Post-Training großer Sprachmodelle. MLCommons beschreibt die Suite als Sammlung von Tests kompletter Systeme, die Modelle, Software und Hardware mit Workloads aus einer Reihe von Anwendungen des maschinellen Lernens konfrontieren.
DLRMv4-HSTU aktualisiert und ersetzt den in früheren MLPerf-Versionen verwendeten Benchmark DLRM-dcnv2. Er nutzt die aufmerksamkeitsbasierte HSTU-Architektur und trainiert mit dem Yambda-Datensatz, den MLCommons als einen der größten verfügbaren Open-Source-Datensätze für Empfehlungssysteme beschreibt.
Qwen3.5-397B führt einen Post-Training-Workload auf Basis der Group Relative Policy Optimization (GRPO) ein. Laut MLCommons soll der Benchmark die wachsende Bedeutung des Post-Trainings in KI-Systemen abbilden, auch in Systemen mit agentischen Funktionen. Dabei wird ein Modell darauf trainiert, bei Softwareentwicklungsaufgaben, einschließlich Tool-Aufrufen, eigenständig zu schlussfolgern.
„Post-Training hat eine neue Komplexitätsebene in die Architektur des KI-Trainings gebracht“, sagte Shriya Rishab, Co-Vorsitzende der MLPerf-Training-Arbeitsgruppe. Die Community habe zwei Jahre an dem Benchmark-Test gearbeitet. Die Ergebnisse von v6.1 zeigten, dass er schnell angenommen werde.
Mehr Systeme und breitere Hardware-Abdeckung
Die Einreichungen für v6.1 umfassen 153 Systeme und 250 Testergebnisse. Cloud-basierte Systeme machten 57 Einreichungen beziehungsweise 37 % der Gesamtzahl aus, verglichen mit 29 % in v6.0. Zwölf Systeme nutzten 1.000 oder mehr Beschleuniger. Das größte System verwendete 10.240 Beschleuniger.
Die Ergebnisse umfassen Beschleuniger-Hardware von NVIDIA, AMD und Google. Erstmals sind in dieser Runde auch GPUs der NVIDIA-Rubin-Generation und Google TPUv7, auch Ironwood genannt, vertreten. Laut MLCommons zeigen die Einreichungen eine größere Vielfalt bei Hardware, Systemarchitekturen und dem Umfang der Installationen.
„Dass in den veröffentlichten Ergebnissen deutlich mehr Bereiche der möglichen Systemmatrix vertreten sind, verschafft uns einen klareren Überblick darüber, wie sie sich in den wichtigsten realen Szenarien für KI-Training im Vergleich schlagen“, sagte Pavan Yalamanchili, Co-Vorsitzender der MLPerf-Training-Arbeitsgruppe.
Yalamanchili ergänzte, dass Organisationen die Ergebnisse nutzen können, um eine geeignete Systemkonfiguration für ihre Anforderungen zu bestimmen, von einem Einzelknotensystem bis zu einem Cluster mit mehreren Knoten und Tausenden von Beschleunigern.
Unabhängiges Benchmarking umfasst 24 Organisationen
Die Leistungsergebnisse der Runde v6.1 stammen von 24 einreichenden Organisationen: AMD, ASUSTeK, Azure, Cisco, CoreWeave, Crusoe, Dell, Firmus, Fujitsu, Giga Computing, Google, HPE, Inventec, KRAI, Lambda, MiTAC, Nebius, NVIDIA, Oracle, Quanta Cloud Technology, Supermicro, tiny corp, TTA und der University of Florida.
Crusoe reichte in dieser Runde erstmals Ergebnisse für MLPerf Training ein. David Kanter, Head of MLPerf bei MLCommons, sagte, die anhaltende Beteiligung bestehender Organisationen zusammen mit neuen Einreichern zeige den Wert von Benchmark-Daten für neue Workloads und Systeme.
MLCommons beschreibt MLPerf Training als offene und begutachtete Benchmark-Suite, die branchenweite Vergleiche von Leistung und Energieeffizienz ermöglichen soll. Die Benchmark-Sammlung wird von Experten aus der KI-Community zusammengestellt.
Die Ergebnisse sind auf der MLPerf-Training-Benchmark-Seite verfügbar. Die Veröffentlichung umfasst außerdem Visualisierungstools zum Vergleich der Leistung verschiedener Systeme und zur Einordnung von Ergebnissen zwischen Systemen ähnlicher Größe. Für Nutzer, die eine Infrastruktur für KI-Training bewerten, liefern die erweiterte Workload-Abdeckung und die größere Auswahl an Konfigurationen mehr Daten für Systemvergleiche. MLCommons versteht die Benchmark-Ergebnisse jedoch als Orientierung für unterschiedliche Einsatzentscheidungen und nicht als einheitliches Ranking für jeden Anwendungsfall.