MLPerf Training v6.1 zeigt größere Cluster und breitere Hardware-Auswahl
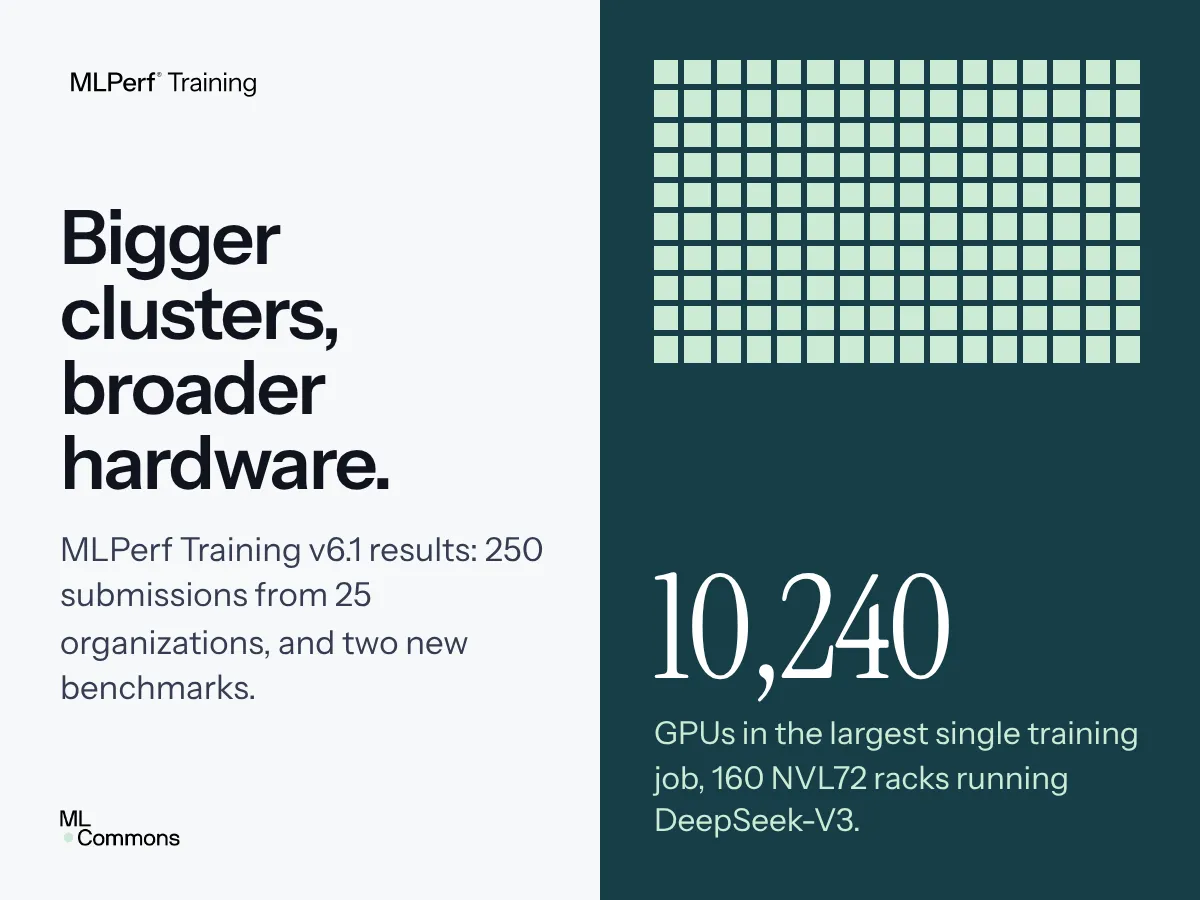
Die MLPerf-Training-v6.1-Benchmark-Runde von MLCommons erweitert ihre Workload-Suite und zeigt zugleich einen deutlichen Anstieg der Systemgröße. Die Runde umfasst 250 Einreichungen von 25 Teilnehmern. Die größten Jobs nutzten 10.240 GPUs, um DeepSeek-V3 zu trainieren.
- MLPerf Training v6.1 umfasst 250 Einreichungen von 25 Teilnehmern.
- Qwen3.5-397B GRPO und DLRMv4 (HSTU) wurden in die Benchmark-Suite aufgenommen.
- Die größten Jobs nutzten 10.240 GPUs, um DeepSeek-V3 zu trainieren.
- Multi-Node-Systeme machten 76 % der Systeme in dieser Runde aus.
- In den Ergebnissen waren zwölf Beschleunigerprodukte von NVIDIA, AMD und Google vertreten.
Zwei Benchmarks hinzugefügt, zwei eingestellt
MLPerf Training v6.1 ergänzt Qwen3.5-397B GRPO, einen agentischen Post-Training-Workload, bei dem Reinforcement Learning eingesetzt wird, um einem Sprachmodell mit 397 Milliarden Parametern die Reparatur echter Softwareprojekte beizubringen. Sieben Teilnehmer führten den Benchmark aus und erzeugten 29 Einreichungen.
Die zweite Ergänzung ist DLRMv4 (HSTU), ein generatives Empfehlungsmodell, das DLRM-DCNv2 ersetzt. Acht Teilnehmer legten 20 Einreichungen für den neuen Benchmark vor.
MLCommons stellte Llama 3.1 405B nach drei Runden ein. Zur Begründung hieß es, große dichte Modelle seien für das Training in großem Maßstab nicht mehr repräsentativ, da sich dieses zu Mixture-of-Experts-Modellen verlagert habe. DLRM-DCNv2 wurde nach sieben Runden eingestellt und durch DLRMv4 (HSTU) ersetzt.
Trainingssysteme werden größer
Multi-Node-Systeme machten in dieser Runde 76 % der Systeme aus, also 117 von 153. In v6.0 waren es 61 %, beziehungsweise 72 von 118. Neunzehn der 25 Teilnehmer reichten mindestens ein Multi-Node-System ein, verglichen mit 16 von 24 in der vorherigen Runde.
Die mediane Zahl der Beschleuniger pro Closed-Ergebnis stieg in v6.1 auf 32, nachdem sie in jeder Runde von v4.0 bis v6.0 bei 8 gelegen hatte. Die Zahl der Ergebnisse mit 64 oder mehr Beschleunigern erhöhte sich von 73 in v6.0 auf 111.
Die größten Closed-Systeme wuchsen von 8.192 GPUs in v6.0 auf 10.240 GPUs in v6.1. Die Systeme NVIDIA GB300 NVL72 und Azure GB200 NVL72 trainierten DeepSeek-V3 in dieser Größenordnung. Google trainierte DeepSeek-V3 auf 8.192 TPU7x-Chips in einem einzigen ICI-Slice.
Breitere Beteiligung bei Hardware und Software
Die Runde umfasst 12 Beschleunigerprodukte von drei Anbietern. NVIDIA-Produkte kamen in 122 Systemen von 21 Teilnehmern zum Einsatz. AMDs MI300X, MI350X und MI355X waren in 27 Systemen von neun Teilnehmern vertreten. Googles TPU7x lief in vier Systemen mit bis zu 8.192 Chips.
Googles Ironwood und NVIDIAs Rubin feierten ihr Debüt als verfügbare Systeme. AMD reichte außerdem eine breitere Workload-Abdeckung für den Instinct MI355X und MI350X ein. Server-OEMs und ODMs reichten 38 Systeme ein, die 33 % aller Einreichungen ausmachten. Dabei ging es um unterschiedliche Kombinationen aus Beschleunigern, Host-CPUs, Kühlsystemen, Netzwerk-Fabrics und Rack-Größen.
Cloud-Anbieter stellten Infrastruktur bereit, die häufig virtualisiert war. 28 % aller Einreichungen liefen auf Systemen, die als in der Cloud verfügbar gelistet waren. Die University of Florida führte Benchmarks auf der Hälfte des B200-SuperPODs in ihrem HiPerGator-Cluster aus, während die andere Hälfte weiterhin Forschern zur Verfügung stand. Dies zeigt eine Nutzung gemeinsam verwendeter akademischer Infrastruktur.
MLCommons hob außerdem Softwareverbesserungen von Firmus und KRAI hervor, darunter KI-gestützte Optimierungen. Koreas TTA reichte die einzige Energiemessung der Runde ein. TTA erklärte: „Wir haben Leistungsdaten eingereicht, weil Energie zu einer ebenso aussagekräftigen Dimension der KI-Infrastruktur wie Zeit wird.“
Warum die Ergebnisse wichtig sind
Die Zahlen von MLCommons deuten auf einen Trainingsmarkt hin, der sich zunehmend um Multi-Node- und Rack-Scale-Systeme statt um einzelne Server organisiert. Die Hälfte der Ergebnisse aus v6.1 nutzte Nodes mit vier Beschleunigern, darunter 115 Compute-Trays in GB200-, GB300- und Vera-Rubin-NVL72-Racks. Die andere Hälfte setzte auf Server mit acht Beschleunigern, entweder als einzelne Nodes oder als Komponenten größerer Systeme.
Die Runde erweitert zudem, was Benchmark-Ergebnisse zeigen können. Sie decken neue Chips, Cloud-Infrastruktur, gemeinsam genutzte akademische Systeme, mehrere Kühlungs- und CPU-Konfigurationen, Softwareoptimierung und Energiemessungen ab. Die Analyse von MLCommons besagt, dass sich die Leistung beim KI-Training schneller verbessert hat als nach einer hypothetischen Moore’s-Law-Baseline zu erwarten wäre. Zugleich warnt sie davor, dass die Fortschritte je nach Workload variieren können. Für Nutzer und Käufer von Infrastruktur bieten die Ergebnisse Vergleiche zwischen Beschleunigerfamilien, Systemgrößen und Einsatzumgebungen. Die Organisation bezeichnet ihren Leistungsindex jedoch als aus MLPerf-Ergebnissen abgeleitet und nicht als offizielles Ergebnis.