MLCommons
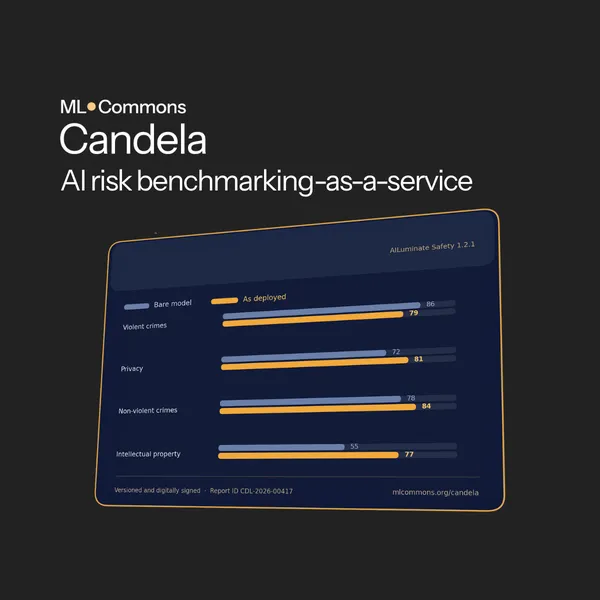
MLCommons startet Candela: KI-Risiko-Benchmarks auf Abruf für Entwickler und Betreiber
MLCommons hat Candela gestartet, einen Benchmarking-as-a-Service für KI-Risiken und Zuverlässigkeit, der die AILuminate-Benchmarks auf Abruf bereitstellt. Laut der…
MLCommons startet Candela zum Testen von KI-Sicherheit und Jailbreak-Risiken
MLCommons hat mit Candela ein Benchmarking-as-a-Service-Produkt gestartet, mit dem Entwickler und Betreiber AILuminate Safety 1.2.1 und AILuminate Jailbreak 1.1 auf…
MLCommons: Sicherheitswerte von Basismodellen lassen sich nicht auf produktive KI-Systeme übertragen
MLCommons fordert, bei der Sicherheitsbewertung von KI nicht länger davon auszugehen, dass der Sicherheitswert eines Basismodells weiter gilt, sobald Teams…
MLCommons entwickelt MLPerf Agents: Benchmark mit 3,5 Millionen US-Dollar aus NSF-gestütztem Programm
MLCommons ist als Benchmarking-Team für die STRIDE Ventures AI Efficiency Challenge ausgewählt worden, ein Programm, das von der US-amerikanischen National Science…
MLCommons schärft seine Mission: KI-Messung standardisieren
MLCommons hat sein Leitbild auf "Standardize AI measurement and enable informed decisions" aktualisiert. Nach Angaben der Organisation spiegelt das wider, worauf sie…
MLPerf wird Bewertungsmaßstab bei der EU-Ausschreibung für KI-Gigafactories, Endpoints v1.0 startet
MLPerf ist laut MLCommons als Leistungsstandard für Gebote in der Ausschreibung der Europäischen Union für KI-Gigafactories festgelegt worden. Die Organisation teilte…
MLCommons veröffentlicht Taxonomie mit fünf Datenschutzrisiken speziell für KI-Agenten
MLCommons hat Version 0.1 der Agent Privacy Risk Taxonomy veröffentlicht. Das Framework ordnet die Datenschutzrisiken, die speziell bei KI-Agenten auftreten, fünf…