MLCommons schärft seine Mission: KI-Messung standardisieren
MLCommons hat sein Leitbild auf "Standardize AI measurement and enable informed decisions" aktualisiert. Nach Angaben der Organisation spiegelt das wider, worauf sie sich schon immer konzentriert hat. Zudem kündigte sie organisatorische Änderungen an, die diese Mission unterstützen sollen, darunter eine neue Beitragsstruktur und den Versuch, auch Anwender von KI-Systemen als Mitglieder zu gewinnen.
- MLCommons hat seine Mission auf "Standardize AI measurement and enable informed decisions" aktualisiert.
- Die Organisation beschreibt ihre Arbeit als Definieren, Bauen, Betreiben, Zertifizieren, Erklären, Weiterentwickeln und Vernetzen von Benchmarks.
- Nach eigenen Angaben betreibt sie kein bezahltes "Benchmarketing" (Pay-for-Play).
- Zu den geplanten Änderungen zählen eine neu gestaltete Beitragsstruktur und die Einladung an KI-Anwender, Mitglied zu werden.
- MLCommons prüft Benchmarking für Effizienz, Gesundheitswesen und Finanzdienstleistungen.
Warum Messung wichtig ist, laut MLCommons
In einem Beitrag mit dem Titel "Our mission, updated" argumentiert MLCommons, Messung sei grundlegend, um das Potenzial von KI verantwortungsvoll zu erschließen. Moderne KI-Systeme beschreibt die Organisation als "the ultimate black boxes", also als die ultimativen Black Boxes: Sie nutzten komplexe Muster über Milliarden von Zahlen hinweg, um ausgefeiltes Verhalten zu erzeugen. Erklärungen, wie sie funktionieren, blieben vage und würden täglich komplexer.
Auch die Kosten spielen eine Rolle. Training und Betrieb von KI-Systemen sind teuer und energiehungrig. Bessere Messungen, so MLCommons, machten es möglich, sowohl das Verhalten als auch die Betriebskosten empirisch zu erfassen. Die erklärte Regel: Wenn eine Eigenschaft von KI-Hardware, -Software oder -Daten für den gelieferten Nutzen wichtig ist, sei es Geschwindigkeit, Stromverbrauch, Zuverlässigkeit oder Qualität, will die Organisation sie messen.
Laut MLCommons unterstützt dies fundierte Entscheidungen über heute verfügbare KI-Systeme, ermöglicht Kosten-Nutzen-Abwägungen, liefert einen "north star for innovation" (einen Orientierungspunkt für Innovation) und hilft beim Risikomanagement, etwa bei Absicherung und Versicherung. Die Arbeit komme akademischen Forschern, Hardware- und Softwareanbietern, Anwendern, Endnutzern und politischen Entscheidungsträgern zugute. Man mache das, weil es den KI-Markt risikoärmer mache und wachsen lasse.
Benchmarks in Industriequalität und sieben Tätigkeitsfelder
MLCommons will standardisierte Messungen als Benchmarks in Industriequalität entwickeln und betreiben. Diese kombinieren detaillierte Protokolle mit Artefakten wie Test-Harnesses, zurückgehaltenen Testdatensätzen und Evaluationsmodellen. Angesichts der Komplexität und oft subjektiven Natur von KI-Tests, so die Organisation, ließen sich vergleichbare Ergebnisse nicht aus mehreren Implementierungen gewinnen, die nach einem Standard auf dem Papier gebaut wurden. Viele Artefakte müssten zudem technisch und rechtlich geschützt werden, um Overfitting zu vermeiden, und die Messungen müssten sich mit der Technologie weiterentwickeln. Dafür brauche es eine vertrauenswürdige, nachhaltig arbeitende Organisation. Ihre Arbeit versteht MLCommons als Unterstützung für Normungsgremien wie ISO, Appia, CoSAI und ADA.
Der Beitrag nennt sieben Tätigkeiten: definieren, bauen, betreiben, zertifizieren, erklären, weiterentwickeln und vernetzen.
- Definieren: in einem transparenten Community-Prozess festlegen, was gemessen wird. MLCommons betont, kein bezahltes "Benchmarketing" (Pay-for-Play) zu betreiben.
- Bauen: unübersichtliche Praxisfälle in rigorose Testszenarien übersetzen, einschließlich wartbarer KI-gestützter Auswertungen für subjektive Benchmarks.
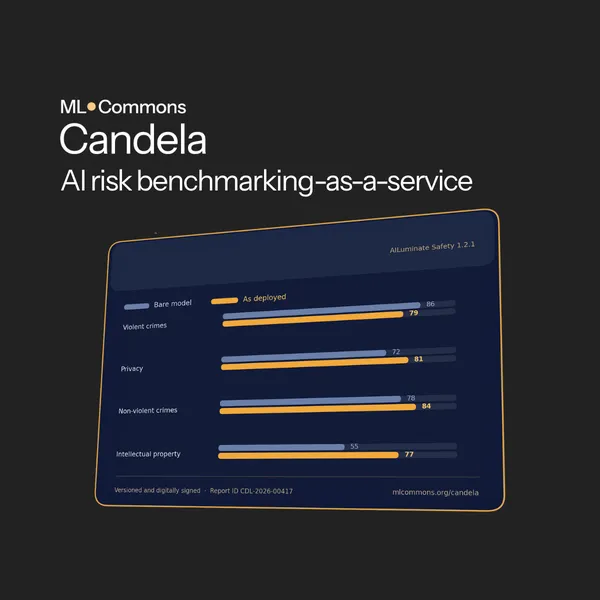
- Betreiben: aus einem GitHub-Repository und einem Datensatz ein lebendiges Messinstrument machen, mit Infrastruktur wie Candela und föderierter Evaluation.
- Zertifizieren: Ergebnisse validieren, um Leistungsversprechen durch Dritte zu bestätigen. Das unterstützt Beschaffung, Absicherung, Versicherung und die Einhaltung von Vorschriften.
- Erklären: fachliche Einordnung liefern, Experten briefen, die die Ergebnisse nutzen, und mit Normungs- und Prüforganisationen zusammenarbeiten.
- Weiterentwickeln: verbesserte Technik und zunehmende Bedrohungen im Blick behalten, damit Benchmarks Unterschiede zwischen getesteten Systemen weiter sichtbar machen, während diese Systeme besser werden.
- Vernetzen: Benchmarks mit anderen Normungsorganisationen und entstehenden politischen Regelwerken weltweit verknüpfen.
Geplante organisatorische Änderungen und ihre Bedeutung
MLCommons kündigt an, in den kommenden Tagen und Monaten organisatorische Änderungen vorzunehmen. Die Liste aus dem Beitrag:
- Die Website verbessern und mehr begleitende Ressourcen bereitstellen, damit Nutzer der Ergebnisse diese leichter finden und verwenden können, wie es bereits bei MLPerf Endpoints geschieht.
- Die eigenen Benchmarks auf neue Weise bekannt machen, indem Produkt- und Marketingdenken in Vorstand und Team einzieht und der Dienst Candela ausgebaut wird.
- Die Arbeit zu Leistung und Zuverlässigkeit auf organisatorischer und technischer Infrastrukturebene aufeinander abstimmen, damit KI-Anbieter und Anwender höhere Qualität bei geringeren Kosten und niedrigerem Stromverbrauch liefern können.
- KI-Anwender, die heute Kunden der Mitglieder sind, zum Beitritt ermuntern und die Beitragsstruktur so umbauen, dass die Kosten proportionaler zum Nutzen steigen.
- Benchmarking für kritische Märkte wie Effizienz, Gesundheitswesen und Finanzdienstleistungen prüfen.
Die Ankündigung signalisiert eine Verschiebung des Schwerpunkts hin zu denjenigen, die KI-Systeme kaufen und betreiben, und nicht nur zu den Anbietern, die sie entwickeln. Die Einladung an Anwender und die geplanten Änderungen bei den Beiträgen deuten auf eine breitere Mitgliederbasis hin. Die Prüfung von Gesundheitswesen und Finanzdienstleistungen lässt mögliche neue Benchmark-Bereiche erkennen, wobei der Beitrag weder Zeitpläne noch Preise oder konkrete Benchmarks dafür nennt. MLCommons erklärt, Ideen und Rückmeldungen aus der Community bei der Umsetzung der Änderungen willkommen zu heißen.