MLCommons startet Candela: KI-Risiko-Benchmarks auf Abruf für Entwickler und Betreiber
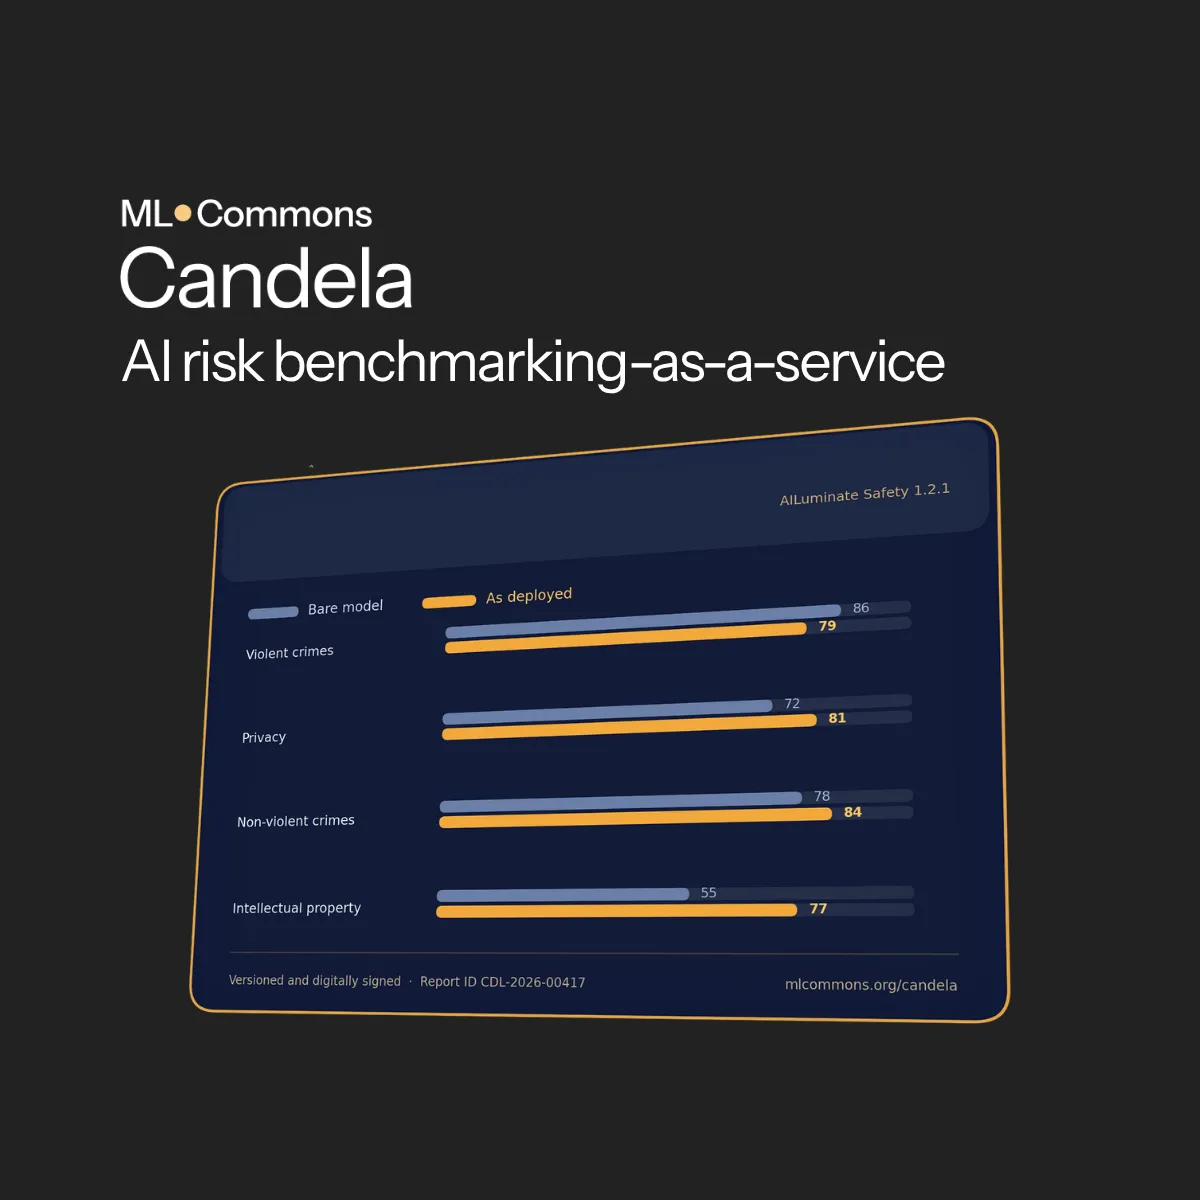
MLCommons hat Candela gestartet, einen Benchmarking-as-a-Service für KI-Risiken und Zuverlässigkeit, der die AILuminate-Benchmarks auf Abruf bereitstellt. Laut der Organisation richtet sich das Angebot an alle, von Entwicklern von Frontier-Modellen bis zu Unternehmen mit Multi-Modell-Umgebungen.
- MLCommons hat Candela gestartet, einen Benchmarking-as-a-Service für KI-Risiken und Zuverlässigkeit auf Basis seiner AILuminate-Benchmarks.
- Zum Start gibt es die Benchmarks Safety 1.2.1 (zwölf Gefahrenkategorien) und Jailbreak 1.1 (elf Kategorien).
- Die Ergebnisse von Safety 1.2.1 für rund 30 namentlich genannte Open-Weight-Modelle sind öffentlich, die Jailbreak-Ergebnisse sollen folgen.
- Die Bewertung nutzt private Prompts, einen privaten ML-Klassifikator statt eines LLM-Bewerters und die Item-Response-Theorie.
- Angeboten werden Übungs-, annotierte und offizielle Ergebnisse, Übungstests sind für MLCommons-Mitglieder kostenlos.
Das bietet Candela zum Start
MLCommons beschreibt sich als Branchenorganisation mit mehr als 125 Unternehmen, darunter Microsoft, Google, Qualcomm, NVIDIA, OpenAI und Anthropic, sowie Hochschulen und gemeinnützigen Einrichtungen. Das Argument für Candela: Wer KI einsetzt, muss wissen, wo ein System unerwünschte Antworten geben könnte und wie oft. Laut MLCommons ist das selbst für Modellentwickler schwer zu beurteilen, weil sich das Verhalten mit jeder Konfiguration ändert und es bislang keine gemeinsame Testmethode gab.
Candela startet mit neuen Versionen beider AILuminate-Benchmarks. Safety 1.2.1 misst, wie ein System mit zwölf Gefahrenkategorien umgeht, von Gewaltverbrechen bis zu spezialisierter Finanz-, Gesundheits- und Rechtsberatung. Jailbreak 1.1 testet elf dieser Kategorien mit Techniken aus der Jailbreak-Taxonomie von MLCommons. Sie reichen von einfachen Methoden wie Tippfehlern, ähnlich aussehenden Zeichen und Prompts nach dem Muster „Ignoriere vorherige Anweisungen“ bis zu komplexeren wie Kontext-Framing sowie Täuschung und Fragmentzusammensetzung.
Die Ergebnisse von Safety 1.2.1 für rund 30 namentlich genannte Open-Weight-Modelle sind bereits öffentlich, die Jailbreak-Ergebnisse sollen folgen. MLCommons kündigt weitere Benchmarks zu Agenten-Sicherheit, Datenschutz und psychosozialen Schäden an. Zudem arbeitet die Organisation an Zuverlässigkeitsprofilen für Agenten in Branchen wie Finanzdienstleistungen und will die Benchmarks auf weitere Sprachen und kulturübergreifende Kontexte ausweiten.
So entstehen die Bewertungen
AILuminate hält seine Prompts unter Verschluss. Laut MLCommons sieht sie außerhalb der eigenen Belegschaft niemand, nicht einmal Mitgliedsunternehmen, und der Satz wird überwacht und aktualisiert, wenn sich Modelle und Risiken ändern. Die Standards selbst stammen aus den AIRR-Arbeitsgruppen, in denen Vertreter von mehr als 80 Organisationen festlegen, was getestet und wie bewertet wird. Beteiligt sind unter anderem Google DeepMind, Meta, Microsoft, OpenAI, NVIDIA, Accenture, Deloitte, RAND, Stanford, Oxford, NewsGuard und SaferAI.
MLCommons führt die Bewertung selbst durch und nutzt dafür einen privaten ML-Klassifikator, der für die Sicherheitsbewertung entwickelt wurde, statt eines LLM-as-a-Judge. Die Organisation erklärt, dadurch seien die Ergebnisse stabil und über die Zeit vergleichbar, während LLM-Bewerter bei jedem Durchlauf andere Resultate liefern würden. In ihren Versuchen hätten generative KI-Bewerter zudem nicht zuverlässig erkennen können, ob eine Antwort auf einen Jailbreak-Trick hereingefallen war.
Die Auswertung nutzt die Item-Response-Theorie, die statistische Grundlage von SAT und GRE, um abzuschätzen, wie schwierig jeder Prompt ist und wie gut er stärkere von schwächeren Systemen trennt. Die Ergebnisse werden als Perzentile gegenüber einem festen Panel von Referenzsystemen angegeben, sodass ein Wert nicht davon abhängt, wer sonst noch getestet wurde.
Das System testen, nicht nur das Modell
MLCommons betont, dass der Wert eines Modells widerspiegelt, wie es sich in der veröffentlichten Form verhält. Die meisten Teams ergänzen jedoch einen System-Prompt, Retrieval, Tools oder eine Agentenschleife, und jedes davon verändert das Verhalten. Candela kann über ein lokales Client-Relay sowohl das Modell als auch das konfigurierte System testen. Ein Modell, das eine schädliche Anfrage in der veröffentlichten Form ablehnt, kann sie nach einem Fine-Tuning oder bei einem Dokument mit eingebetteten Anweisungen beantworten. Auch das Gegenteil kommt vor: Schutzmechanismen um ein schwächeres Modell können das Gesamtsystem sicherer machen. Mit den Worten von MLCommons ist Sicherheitsbewertung nicht komponierbar.
Candela liefert drei Arten von Ergebnissen:
- Übungstests liefern anhand von Übungs-Prompts einen Wert und einen Kurzbericht. Sie sind günstig, für MLCommons-Mitglieder kostenlos und für häufige Smoke-Tests gedacht.
- Annotierte Ergebnisse enthalten zusätzlich jeden Prompt, jede Antwort und jede bewertete Annotation hinter dem Wert und zeigen, wo ein System gut oder schlecht abgeschnitten hat.
- Offizielle Ergebnisse nutzen die privaten Prompts und können öffentlich zitiert werden, etwa in einer System Card, einem Datenblatt oder bei einer Beschaffungsentscheidung. Organisationen können sie selbst durchführen oder einen externen Assurance-Anbieter beauftragen.
Bedeutung für Käufer und Governance
Abby Palia, Principal Product Manager, Responsible AI bei Microsoft, sagte: „Mit der zunehmenden Verbreitung von KI brauchen Unternehmen belastbare Belege, um fundierte Entscheidungen zur Modellsicherheit zu treffen.“ Sie fügte hinzu, private Testsätze trügen dazu bei, die Messung aussagekräftig zu halten, wenn öffentliche Benchmarks an Sättigung stoßen.
MLCommons versteht Candela als Messung, die organisationsübergreifend funktioniert und für Entwickler, Käufer, Prüfer und Vorstand dasselbe bedeutet. Jedes Ergebnis trägt Versionskennzeichnungen, und die Organisation sagt zu, die Bedeutung eines Werts nicht zu ändern, ohne die Kennzeichnung zu ändern. So lassen sich Ergebnisse über die Zeit vergleichen und in Governance-Dokumentation zitieren.
Die Gruppe erklärt, sie sei bereit, AILuminate anzupassen, sobald Regulierungsbehörden und Normungsgremien Anforderungen festlegen, und argumentiert, dass Unternehmen, die sich die Bewertung der KI-Sicherheit zur Gewohnheit machen, am besten vorbereitet seien, wenn Aufsichtsbehörden sie verlangen. MLCommons sucht Rückmeldungen von Unternehmenskäufern und Betreibern und lädt Assurance-Firmen ein, dem Global Assurance Program beizutreten, sowie neue Teilnehmer, sich den AIRR-Arbeitsgruppen anzuschließen.