MLCommons startet Candela zum Testen von KI-Sicherheit und Jailbreak-Risiken
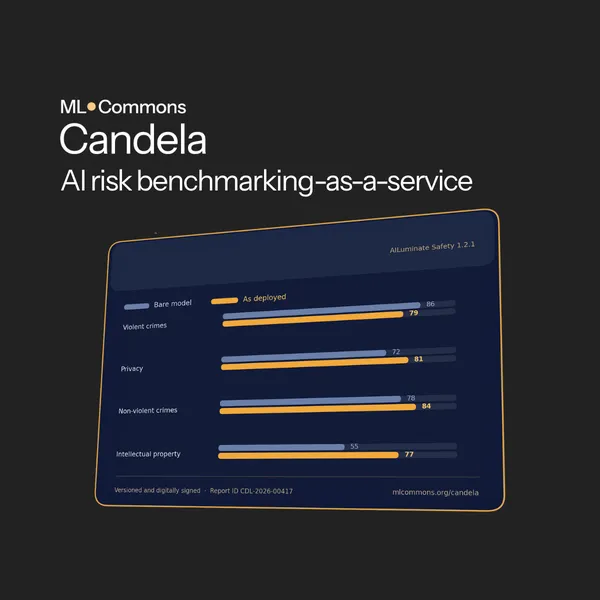
MLCommons hat mit Candela ein Benchmarking-as-a-Service-Produkt gestartet, mit dem Entwickler und Betreiber AILuminate Safety 1.2.1 und AILuminate Jailbreak 1.1 auf ihren eigenen KI-Systemen ausführen können. Zugleich wurden öffentliche Safety-Ergebnisse für 27 Systeme veröffentlicht.
- MLCommons hat Candela gestartet, einen Benchmarking-Dienst, der AILuminate Safety 1.2.1 und Jailbreak 1.1 auf Abruf ausführt.
- Die öffentlichen Safety-Ergebnisse umfassen 27 Systeme: 22 Open-Weight-Modelle und 5 Guardrail-Systeme.
- Open-Weight-Modelle erreichen Werte vom 4. bis zum 98. Perzentil, Guardrail-Systeme liegen bei oder nahe 100.
- Öffentliche Ergebnisse für Jailbreak 1.1 folgen nach einer Benachrichtigungsfrist für Entwickler.
- Ein deterministischer Evaluator verkürzte laut MLCommons die Dauer eines Safety-Tests von etwa 3 Stunden auf 1 Stunde.
Was Candela bietet
Die beiden Benchmarks messen, wie leicht ein KI-System schädliche Inhalte erzeugt und wie einfach Angreifer es dazu verleiten können. Laut MLCommons laufen beide nun in Candela auf Abruf.
Nutzer von Candela können Übungstests durchführen und erhalten einen Bericht mit ihren Safety- und Jailbreak-Perzentilen sowie den Rohwerten für die interne Verwendung und die Produktverbesserung. Auf Wunsch gibt es auch annotierte Übungsergebnisse. Sie enthalten die Übungs-Prompts, die Antworten und die Annotationen, die hinter einem Wert stehen. Offizielle Tests erlauben es, die Ergebnisse öffentlich zu nennen, im Einklang mit den Richtlinien von MLCommons zur Nutzung und Kommunikation der Benchmarks.
MLCommons zufolge testet der Dienst das System so, wie es tatsächlich im Einsatz ist. Ein kleiner Candela-Client leitet jeden Prompt an das Produktivsystem weiter, einschließlich dessen System-Prompt, Guardrails und Retrieval. Der Client gibt jede Antwort zur Auswertung zurück und sonst nichts: keine Schlüssel, keine Gewichte, keine Konfigurationsdetails.
Safety 1.2.1 und die ersten öffentlichen Ergebnisse
Der Safety-Benchmark prüft, wie zuverlässig ein textbasiertes KI-System Anfragen ablehnt oder sicher umlenkt, die zu Schaden führen könnten. Die Prompts decken die 12 Gefahrenkategorien des AILuminate Assessment Standard ab, von Gewalt- und gewaltlosen Straftaten über Massenvernichtungswaffen bis zu Hass, Datenschutz, Verleumdung und Fachberatung zu Gesundheit, Recht und Finanzen. Der Standard konzentriert sich laut MLCommons auf alltägliche Fehler in weit verbreiteten Produkten statt auf spekulative Bedenken und verweist auf reale Vorfälle, etwa den Fall, in dem ein kanadisches Gericht eine Fluggesellschaft für die Auskunft ihres Kundenservice-Chatbots haftbar machte.
Version 1.2.1 ist ein kleines Scoring-Update, das Safety an Jailbreak 1.1 angleicht. Zu den früheren Änderungen der 1.2-Reihe zählen ein deterministischer, von MLCommons trainierter Evaluator anstelle von LLMs als Bewerter, ein neues offizielles Prompt-Set namens Problem Set 2.0 mit 3.900 Prompts sowie Ergebnisse als Perzentile von 0 bis 100 auf einer Referenzskala.
Die öffentlichen Ergebnisse umfassen 27 Systeme: 22 Open-Weight-Modelle unter anderem von Google, IBM, NVIDIA und OpenAI sowie 5 Guardrail-Systeme. Die Open-Weight-Modelle erreichen Werte vom 4. bis zum 98. Perzentil. Das zeige, so MLCommons, dass allein die Modellwahl das relative Sicherheitsprofil eines Einsatzes von nahe dem unteren Ende der Referenzverteilung bis fast an die Spitze verschieben kann. Guardrail-Systeme, die filtern, was ein Modell erhält oder ausgibt, erreichen Werte bei oder nahe 100.
Jailbreak 1.1 und ein neuer Evaluator
Der Jailbreak-Benchmark nimmt dieselben gefährlichen Prompts wie Safety und schreibt jeden mit bekannten Angriffstechniken um. Da beide Benchmarks die Antworten nach demselben Standard beurteilen, zeigt der Vergleich der beiden Werte eines Systems, wie viel der grundlegenden Sicherheit ein Angreifer mit veröffentlichten Techniken aushebeln könnte. Die MLCommons Jailbreak Taxonomy ordnet Angriffe nach ihrem Mechanismus in vier Familien, darunter Rollenspiel- und Template-Angriffe sowie Wrapper- und Schema-Angriffe.
In Jailbreak 1.0 stieg über eine begrenzte Auswahl an Systemen der Anteil regelwidriger Antworten von 11,08 % bei einfachen Prompts auf 18,65 % unter Angriff. Rollenspiel- und Wrapper-Angriffe waren am wirksamsten, mit mittleren Verstoßraten von 35,7 % und 32,8 %.
Öffentliche Ergebnisse für Jailbreak 1.1 liegen noch nicht vor. MLCommons zufolge folgen sie, sobald die bereits laufende Benachrichtigungsfrist für Entwickler endet. Die Organisation argumentiert, dass schon die Nennung eines stark jailbreak-anfälligen Modells ein Informationsrisiko darstellt, und der Benchmark nur veröffentlichte Jailbreaks enthält.
Rückmeldungen von Mitgliedern zur privaten Juni-Version von Jailbreak 1.0 ergaben, dass die Fehlerrate des automatisierten Evaluators zu hoch war, weil Angriffe, die die getesteten Systeme verwirren sollen, auch die LLM-Bewerter verwirrten. MLCommons entwickelte daraufhin einen eigenen deterministischen Klassifikator. Nach eigenen Angaben stimmt er deutlich häufiger mit dem menschlichen Urteil überein, und kein LLM beurteilt die anderen Modelle seines Entwicklers oder die der Wettbewerber. Jailbreak 1.1 läuft darauf mit weitgehend denselben Angriffen wie 1.0.
Was das für KI-Entwickler und -Käufer bedeutet
Laut MLCommons verkürzen der eigene Evaluator und ein trennschärferes Prompt-Set die Zeit vom Start eines Safety-Tests bis zum Ergebnis von etwa 3 Stunden auf 1 Stunde, bei besserer Bewertungsqualität.
Für Teams, die KI einsetzen, bietet Candela die Möglichkeit, ein Produktivsystem zu messen und direkt mit aktuell gängigen Modellen zu vergleichen, anhand von Perzentilwerten, die nach einem offiziellen Test öffentlich genannt werden dürfen. Die Jailbreak-Ergebnisse ergänzen die Seite der Angriffsresistenz, sobald die Benachrichtigungsfrist für Entwickler abgelaufen ist.