MLCommons: Sicherheitswerte von Basismodellen lassen sich nicht auf produktive KI-Systeme übertragen
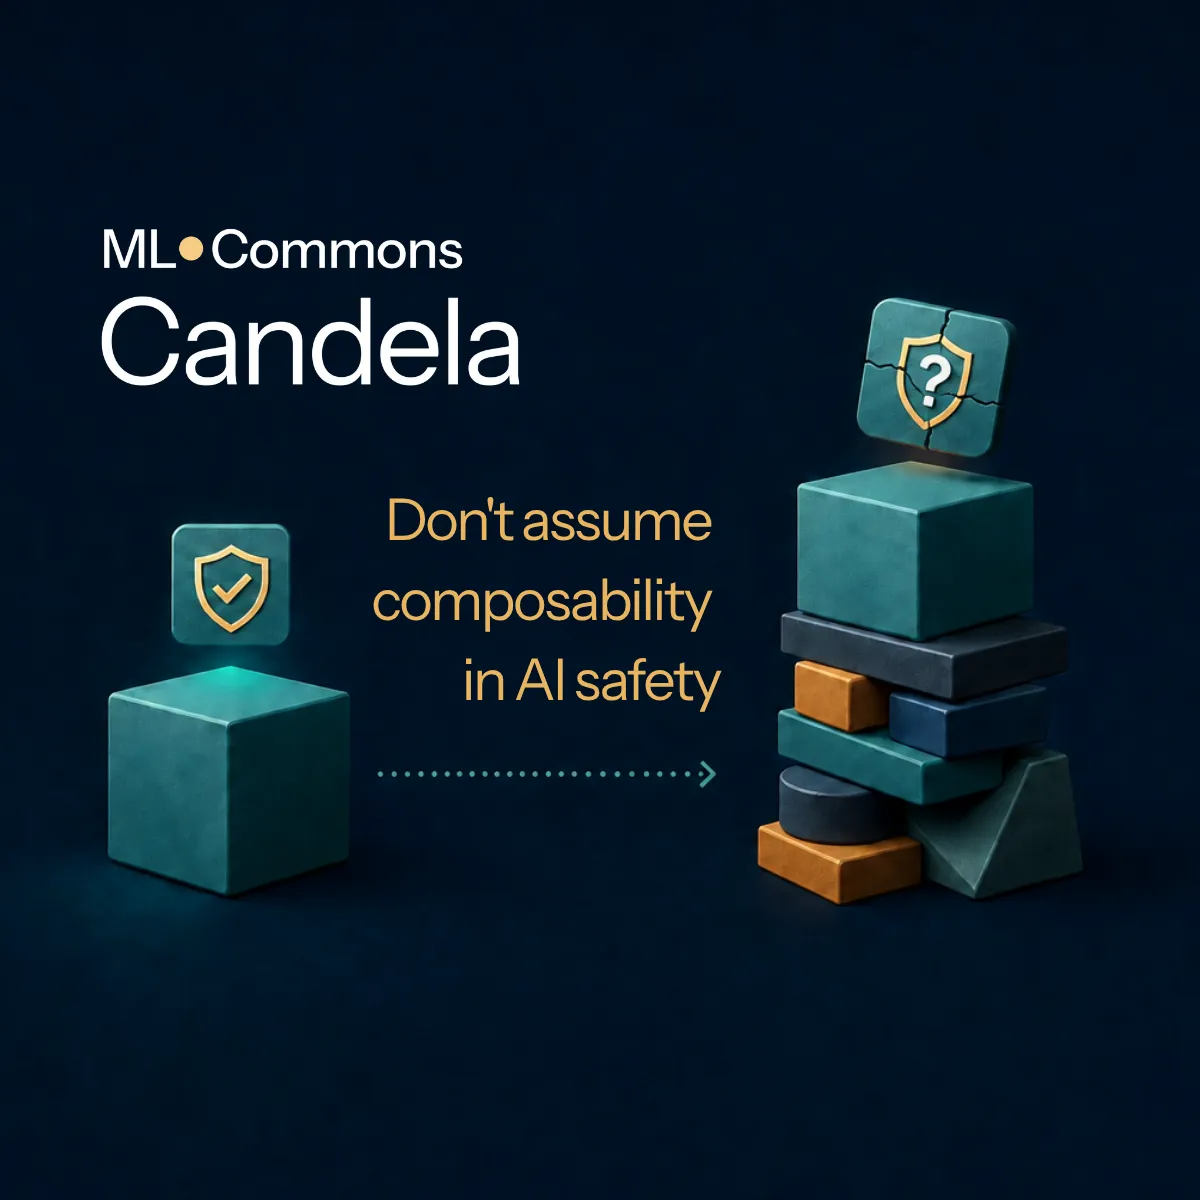
MLCommons fordert, bei der Sicherheitsbewertung von KI nicht länger davon auszugehen, dass der Sicherheitswert eines Basismodells weiter gilt, sobald Teams Systemprompts, Retrieval-Schichten oder Fine-Tuning hinzufügen. In einem Beitrag vom 29. Oktober 2026 argumentiert die Organisation, dass produktive Systeme eigene Tests benötigen, und verweist auf ihren neuen Benchmarking-Dienst Candela.
- MLCommons argumentiert, KI-Sicherheitsergebnisse seien nicht komponierbar: Vom Wert eines Basismodells lasse sich nicht auf ein produktives System schließen.
- Forschung von CDT und MIT zeigt, dass feinjustierte medizinische und juristische Modelle sowohl sicherer als auch weniger sicher abschnitten als ihre Basismodelle, ohne vorhersagbares Muster.
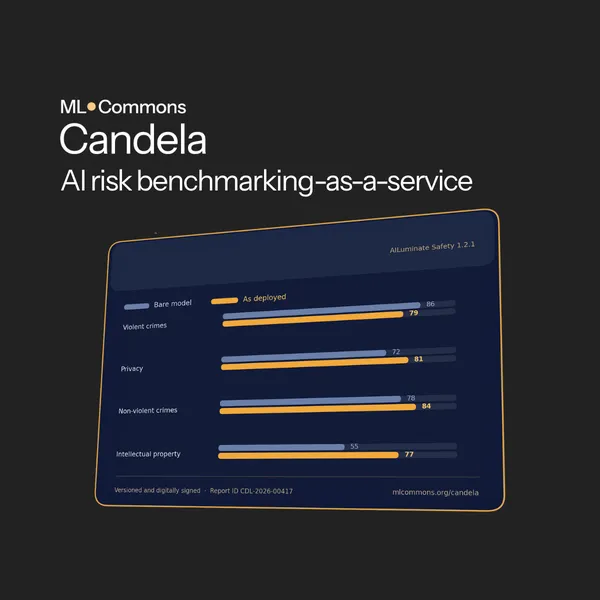
- Candela, ein neuer Benchmarking-as-a-Service, testet die gesamte produktive Umgebung im eigenen Tenant des Kunden.
- Die AILuminate-Versionen Safety und Jailbreak im November enthalten laut MLCommons Fehlermargen.
Das Komponierbarkeitsproblem
Der Beitrag von Bennett Hillenbrand geht von einem Widerspruch in der Praxis aus. Fachleute wissen, dass sich ein produktives System anders verhält als sein Basismodell und dass sich sein Verhalten weiter verändert, sobald sie Systemprompt, Retrieval-Schichten oder Fine-Tuning anpassen. Dennoch geht die Sicherheitsbewertung oft vom Gegenteil aus: Teams verweisen für alles, was sie auf dem Basismodell aufgebaut haben, auf dessen Sicherheitswert aus der System Card.
MLCommons verwendet den Begriff Komponierbarkeit (Composability) dafür, wie gut sich Bewertungsergebnisse eines vorgelagerten Systems auf die darauf aufbauenden Systeme übertragen lassen. Laut dem Beitrag galt diese Annahme in der klassischen Software im Allgemeinen. Bei der KI-Sicherheit trifft sie dagegen oft nicht zu, wie ordentliche Tests zeigen.
Werte verschieben sich in beide Richtungen
Der Beitrag zitiert Forschung des AI Governance Lab des CDT und der Algorithmic Alignment Group des MIT, die öffentlich verfügbare medizinische und juristische Fine-Tunes mit ihren Basismodellen verglichen haben. Einige feinjustierte Modelle schnitten sicherer ab als ihre Basismodelle, andere weniger sicher. Keine einzelne Fine-Tuning-Entscheidung sagte voraus, in welche Richtung sich ein Modell bewegen würde, und auch das Ausmaß der Anpassung ließ keinen Rückschluss auf das Ausmaß der Veränderung bei der Sicherheit zu.
Änderungen können die Ergebnisse auch verbessern. Der Beitrag weist darauf hin, dass zusätzliche Laufzeit-Guardrails bei einem Open-Weight-Modell die Sicherheitswerte in der Regel verbessern, wobei das Ausmaß ohne ordentliche Tests oft unklar bleibt. Als Beispiel für Änderungen, die die Sicherheit verschlechtern, verweist er außerdem auf das Paper „Fine-tuning Aligned Language Models Compromises Safety, Even When Users Do Not Intend To!“.
Verrauschte Benchmarks und die Antwort Candela
Ein zweites Hindernis ist die Messung. Unter Verweis auf ein aktuelles Paper von Solomon Messing heißt es im Beitrag, viele weit verbreitete Benchmarks seien zu verrauscht, um Systeme vor und nach dem Einsatz verlässlich zu vergleichen, Veränderungen im Zeitverlauf zu verfolgen oder ein System mit einem anderen zu vergleichen. Rauschen kann davon abhängen, welche Testprompts ausgewählt wurden, wie sie formuliert waren und welcher Evaluator die Antworten bewertet hat. Ohne Normalisierung könne eine Veränderung des Werts auf Messrauschen statt auf eine echte Veränderung der Sicherheit zurückgehen. Der Beitrag legt offen, dass Messing bei der Abfassung des Papers bei MLCommons beschäftigt war und der Autor darin genannt wird.
Laut MLCommons bringt das neue Produkt Candela, ein Benchmarking-as-a-Service, die AILuminate-Messung auf die gesamte Produktivumgebung: das Basismodell samt Systemprompt, Schutzmechanismen, Retrieval, Tools und Filtern. Beschrieben wird es als privater Testlauf im eigenen Tenant des Kunden.
Die Organisation verweist zudem auf jüngste Änderungen an ihrem Evaluator, darunter Klassifikatoren statt LLMs als Richter und die Methodik der Item-Response-Theorie (IRT) für die Entwicklung von Benchmark-Inhalten. Damit lassen sich laut MLCommons belastbare Fehlermargen berechnen. Die nächsten Versionen von AILuminate Safety und Jailbreak im November werden Fehlermargen enthalten, die die Varianz über die gesamte Evaluierungspipeline berücksichtigen, und zwar mit Transparenz darüber, welche Varianzquellen abgedeckt sind. MLCommons zufolge weist nach seinem Kenntnisstand kein anderer weit verbreiteter KI-Sicherheits-Benchmark Fehlermargen auf diese Weise aus.
Was das für Betreiber und Regulierer bedeuten könnte
Mit bekannter Messunsicherheit könnten Forschende laut dem Beitrag testen, welche Änderungen ein Sicherheitsergebnis erhalten, welche es zerstören und ob sich beides vorab vorhersagen lässt. Heute beruhe die vertretbare Position darauf, dass sich Ergebnisse bei bestimmten Änderungen nachweislich nicht übertragen.
Wenn bekannt ist, dass manche Änderungen einen Wert erhalten, könnten Teams entscheiden, welche sie ungetestet ausrollen, welche sie einem günstigeren Smoke-Test unterziehen und welche sie mit einem kommentierten Bericht vollständig prüfen. Sagt der Wert eines Basismodells die nachgelagerten Werte voraus, könnten vorgelagerte Ergebnisse die Modellwahl leiten und zeigen, wie stark sich ein Einsatz verändern darf, bevor diese Werte nicht mehr gelten. MLCommons ergänzt, eine solche Bewertung könne Regulierern helfen, die Pflichten von Entwicklern und Betreibern voneinander abzugrenzen, und den Mess- und Compliance-Aufwand senken.
Teams, die KI einsetzen, können ihre Systeme ab sofort mit Candela testen. Forschende, die sich für Komponierbarkeit oder Messfehler interessieren, können der AIRR Analytics Working Group beitreten. Deren übergeordnete AIRR-Arbeitsgruppen versammeln laut MLCommons Teilnehmer aus mehr als 80 Organisationen.