Rebellions will mit seiner ReQAT-Methode Fehler beim 4-Bit-Reasoning reduzieren
Rebellions und die Hanyang University haben ReQAT vorgestellt, ein quantisierungsbewusstes Trainingsverfahren, das Reasoning-Modelle auch dann genau halten soll, wenn Gewichte, Aktivierungen und der KV-Cache 4-Bit-Formate verwenden. Die Arbeit basiert auf einem Paper, das bei der ICML 2026 als mündlicher Vortrag präsentiert wurde.
- ReQAT stammt von Rebellions und der Hanyang University.
- Das Verfahren zielt auf die 4-Bit-Quantisierung von Gewichten, Aktivierungen und KV-Cache.
- Rebellions identifiziert Tokens mit niedriger Entropie als besonders anfällig für FP4-Fehler.
- Das an Verläufen ausgerichtete Training steigerte die AIME-Genauigkeit von R1-Qwen-14B in einem berichteten Setup auf 67.29%.
- Code und Trainingsrezept sind auf GitHub verfügbar.
Warum die 4-Bit-Quantisierung schwierig bleibt
Bei der Quantisierung werden Modellgewichte und Zwischenwerte mit weniger Bits dargestellt. Das reduziert den Speicherbedarf und die benötigte Bandbreite und kann auf geeigneter Hardware den Rechendurchsatz erhöhen. Die Quantisierung ausschließlich der Gewichte ist bereits weit verbreitet. Eine Erweiterung der 4-Bit-Präzision auf Aktivierungen und den KV-Cache stellt die Genauigkeit jedoch vor größere Herausforderungen.
Nach Angaben von Rebellions ist das relevant, weil Hardware mit niedriger Präzision die Kosten pro Token nur dann senkt, wenn ein Modell bei dieser Präzision weiterhin akzeptable Antworten liefert. Das Unternehmen entwickelt Infrastrukturen für KI-Inferenz und erklärt, dass der Nutzen für Kunden sowohl von der Hardware als auch von einem dafür trainierten und quantisierten Modell abhängt.
Besonders ausgeprägt ist die Herausforderung bei Large Reasoning Models, die lange Gedankengänge erzeugen. Laut Rebellions kann ein einzelnes Mathematikproblem bei Modellen, die aus der DeepSeek-R1-Familie destilliert wurden, eine Abfolge von mehr als 16K Tokens erzeugen. Eine standardmäßige Quantisierung nach dem Training kann die Genauigkeit beim mathematischen Reasoning deutlich verringern, wenn ein solches Modell NVFP4 für Gewichte, Aktivierungen und den KV-Cache verwendet.
Die Ursache des Genauigkeitsverlusts
Rebellions analysierte mehr als 1.5 Millionen erzeugte Tokens, indem die Entropie der Verteilung des jeweils nächsten Tokens gemessen wurde. Dabei zeigte sich, dass etwa 80% eines Reasoning-Verlaufs aus Tokens mit niedriger Entropie bestehen, darunter Ziffern, Variablennamen und Operatoren. Zu den Tokens mit höherer Entropie zählen Diskursmarker wie Then, Let und Hmm, an denen der Gedankengang abzweigen kann.
Das Unternehmen berichtet, dass FP4 an Positionen mit niedriger Entropie die Wahrscheinlichkeitsmasse außerhalb der wahrscheinlichsten Vorhersage erhöht. Beim Greedy-Decoding hat diese Änderung nur begrenzte Auswirkungen. Beim Sampling mit Temperatur kann sie jedoch über Tausende Positionen hinweg die Wahrscheinlichkeit eines falschen Tokens erhöhen. Laut Rebellions macht eine einzige falsche Ziffer oder ein falscher Operator typischerweise die restliche Herleitung ungültig.
In kontrollierten Experimenten stellte die Weiterleitung ausschließlich von Vorhersagen mit niedriger Entropie an BF16 einen großen Teil der verlorenen Genauigkeit wieder her, während die Weiterleitung ausschließlich von Vorhersagen mit hoher Entropie an BF16 nur wenig bewirkte. Das Hinzufügen von Gaußschem Rauschen zu den Logits führte zu einem ähnlichen Ergebnis. Das Muster zeigte sich bei R1-Llama-8B, R1-Qwen-7B, R1-Qwen-14B, Qwen3-4B und Qwen3-8B.
ReQAT konzentriert das Training auf fragile Vorhersagen
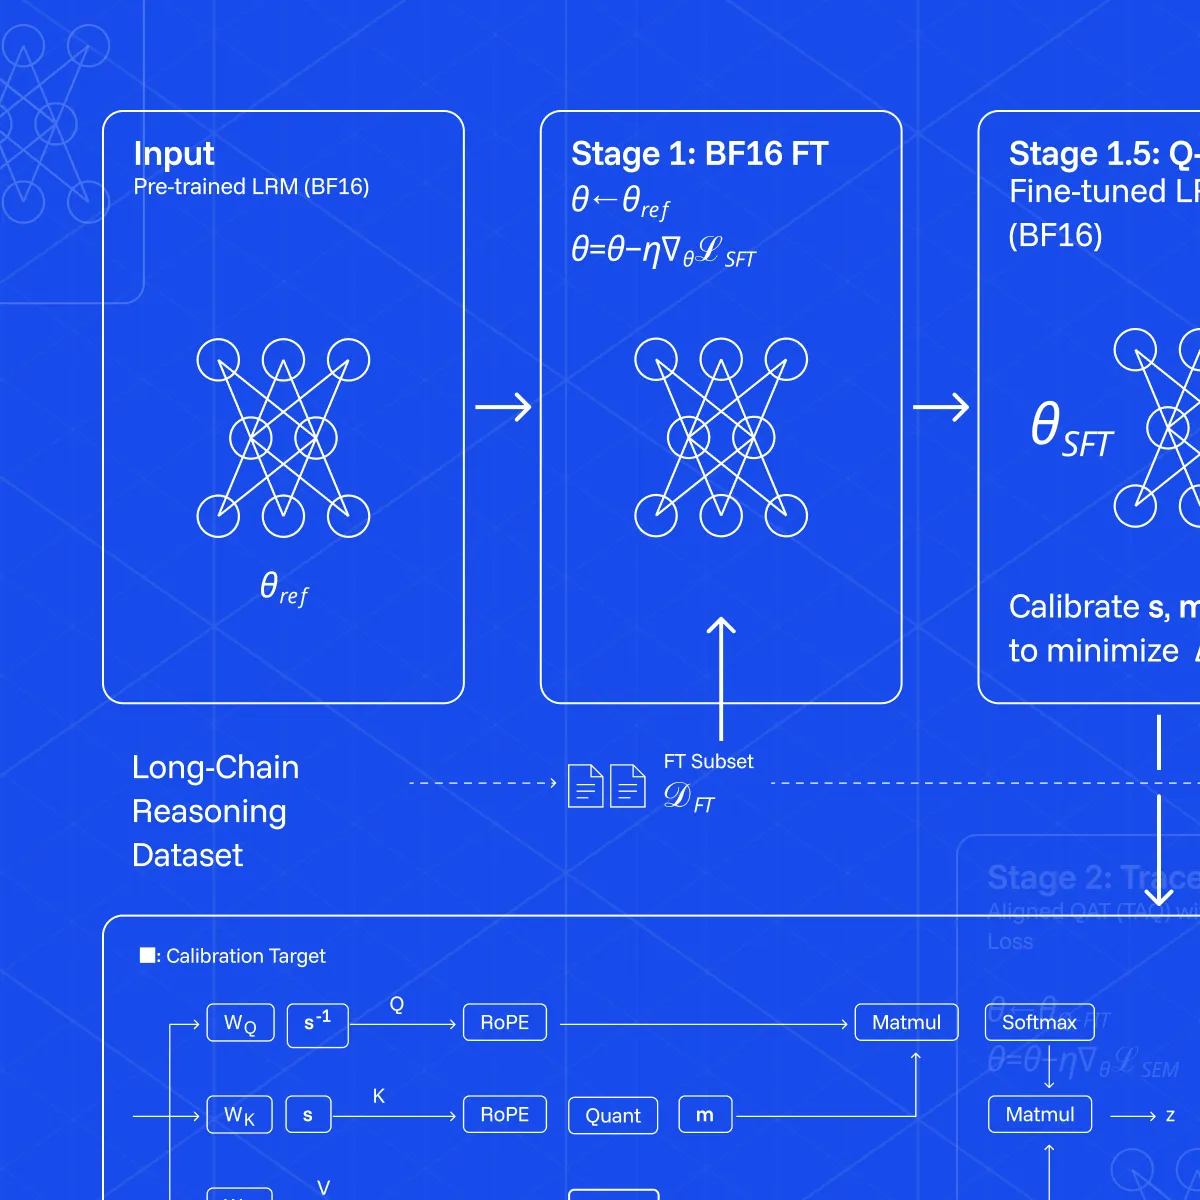
ReQAT, kurz für Reasoning-centric QAT, kombiniert BF16-Feintuning mit quantisierungsbewusstem Training, das an Reasoning-Verläufen ausgerichtet ist. Das Verfahren Trace-Aligned QAT trainiert ein Modell zunächst mit einem Reasoning-Datensatz weiter und wendet anschließend QAT mit Quantisierungsrauschen auf eine Teilmenge derselben Verläufe an.
Rebellions zufolge sorgt diese Ausrichtung dafür, dass Trainingsanpassungen die durch Quantisierung fragil gewordenen Vorhersagen mit niedriger Entropie erreichen. Bei R1-Qwen-14B unter MXFP4 W4A16 und einem Budget von 350M Tokens steigerte ein zweistufiges Training ohne Trace-Ausrichtung die AIME-Genauigkeit von 62.29% auf 62.60%. Mit Trace-Ausrichtung stieg sie weiter auf 67.29%.
Das Paper führt außerdem Selective Entropy Minimization ein. Dabei wird der Verlustfunktion des überwachten Feintunings ein Term zur Minimierung der Entropie hinzugefügt. Die vorliegende Beschreibung endet bei der Erläuterung dieser Komponente und enthält daher weder deren vollständige Spezifikation noch ein endgültiges W4A4KV4-Ergebnis.
Der Code und das Trainingsrezept sind unter github.com/aiha-lab/ReQAT verfügbar. Die Arbeit soll die Einschränkung auf Modellseite beheben, die verhindern kann, dass Inferenzhardware mit niedriger Präzision bei Reasoning-Workloads ihre potenzielle Effizienz erreicht.