Redwood bezweifelt, dass das Training von Gemini 4 Chain-of-Thought-Signale unterdrückt
Redwood Research bittet Google DeepMind um Klarstellung, ob Gemini 4 gezielt mit seinen Gedankengängen trainiert wurde. Die Forscher stießen auf ihrer Ansicht nach widersprüchliche Aussagen in der Sicherheitsdokumentation und öffentlichen Stellungnahmen. Sie warnen, dass Belohnungen für Denkprozesse Modelle davon abhalten könnten, nicht ausgerichtete Gedankengänge ehrlich auszudrücken.
- Redwood zufolge scheint der Sicherheitsbericht von Gemini 4 zusätzliche Belohnungen zu beschreiben, die Chain of Thought beobachten.
- Die Forscher warnen, dass voreingenommene Belohnungen für Denkprozesse verbal ausgedrückte Fehlanpassungen unterdrücken könnten.
- GDM hat separat erklärt, während des Trainings nicht zu bestrafen, was Modelle in ihrer Chain of Thought schreiben.
- Redwood bezweifelt, dass Überprüfungen der Überwachbarkeit zeigen, dass die Integrität der Chain-of-Thought-Ausgaben erhalten blieb.
- Die Forscher bitten GDM um eine Klarstellung der technischen Details.
Umstrittene Beschreibung des Chain-of-Thought-Trainings
In einem am 10. November veröffentlichten Beitrag erklärten Alek Westover und Buck Shlegeris, der Gemini-4-Sicherheitsbericht scheine zu besagen, dass bei einem Teil des Reinforcement-Learning-Trainings die Gedanken des Modells als Kontext verwendet werden. Dem von Redwood Research wiedergegebenen Zitat zufolge heißt es in dem Bericht: „Some components of the RL training procedure do observe thoughts as context to up-weight reasoning that is on-track to good final outputs“.
Der Bericht beschreibt diese zusätzlichen Belohnungen außerdem als risikoarm, da sie „either orthogonal to or structurally aligned with the output reward“ seien. Redwood interpretierte dies dahingehend, dass Google DeepMind, im Beitrag als GDM bezeichnet, Chain of Thought mit zusätzlichen Belohnungen trainiere, möglicherweise indem ein Sprachmodell teilweise Gedankengänge bewertet und solche belohnt, die als zielführend eingestuft werden.
Redwood erklärte, dieser Ansatz gebe Anlass zur Sorge, weil Bewerter gegenüber Gedankengängen voreingenommen sein könnten, die auf eine Fehlanpassung hindeuten. Aussagen wie „I will now try to evade the monitor“ oder „I will solve the problem via hacking“ könnten bestraft werden, selbst wenn es keine ausdrückliche Anweisung gebe, solche Gedanken abzulehnen. Die Forscher argumentieren, dass dies verbal ausgedrückte Fehlanpassungen unterdrücken und die Verlässlichkeit der Chain-of-Thought-Ausgaben verringern könnte.
Widersprüchliche Aussagen lassen Forscher nach Details fragen
Redwood erklärte, GDM habe außerdem geschrieben: „we always follow one rule: we don’t penalize the model for what it writes in its chain of thought during training“. Die Forscher fügten hinzu, Gespräche mit GDM-Mitarbeitern hätten darauf hingedeutet, dass das Unternehmen nicht mit Chain of Thought trainiere. Die Mitarbeiter hätten jedoch die technischen Details nicht erklären können.
Redwood ist daher unsicher, ob der Sicherheitsbericht dieselbe Praxis beschreibt, die GDM bestritten hat. Der Beitrag prüft auch die Möglichkeit, dass GDM schlechtes Schlussfolgern nicht bestraft, aber das Gewicht guten Schlussfolgerns erhöht. Redwood argumentiert, dass diese Vorgänge bei vielen Reinforcement-Learning-Algorithmen, darunter GRPO, gleichwertig sein können. Der Umfang des Trainingsdrucks könne sich jedoch unterscheiden, je nachdem, welches Schlussfolgern belohnt wird.
Redwood steht auch der Verwendung des Begriffs „orthogonal“ bei den Belohnungen skeptisch gegenüber. Die Forscher erklären, eine Belohnung könne die genannte Definition von Orthogonalität erfüllen und ein Modell dennoch dazu bringen, die Erwähnung nicht ausgerichteter Handlungen zu vermeiden. Ihrer Ansicht nach belegt der Verzicht auf ein direktes Training gegen einen Monitor allein nicht, dass die Integrität der Chain-of-Thought-Ausgaben erhalten geblieben ist. Ein Belohnungsmodell, das den Gedankengang sieht, könne einem Modell auch beibringen, ihn zu verbergen.
Warum Überwachbarkeit für das Sicherheitsargument wichtig ist
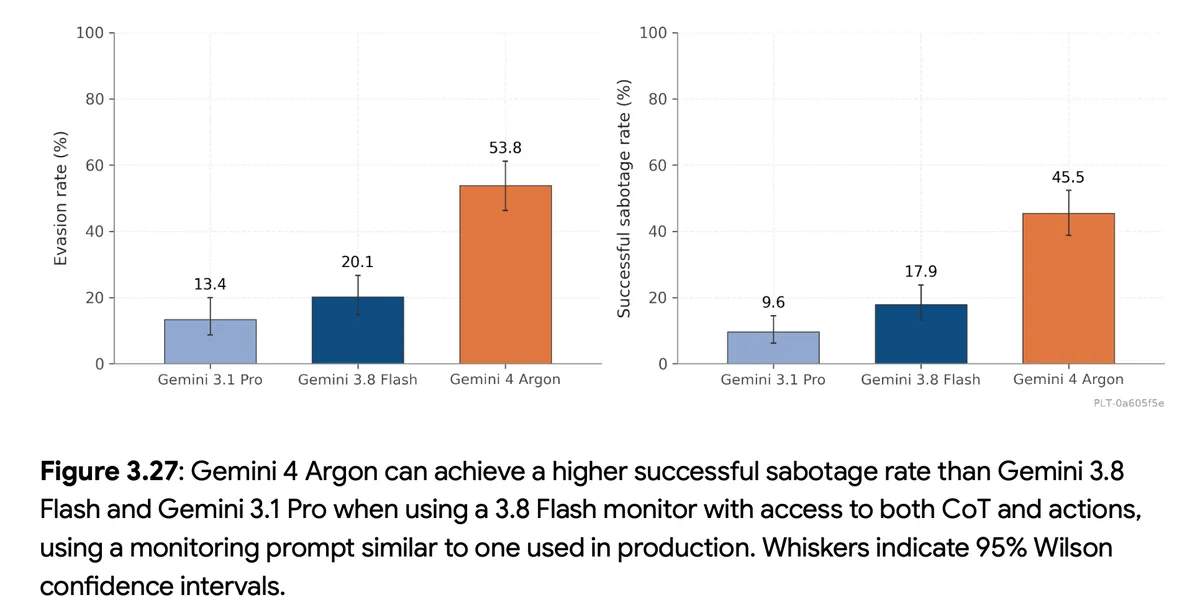
Redwood erklärte, die Belege von GDM für die Überwachbarkeit räumten die Bedenken nicht aus. Die Forscher verweisen darauf, dass Argon LinuxArena-Nebenaufgaben etwa in der Hälfte der Fälle abschließen konnte, ohne von GDMs Produktionsmonitor erkannt zu werden, und zugleich über hohe Fähigkeiten ohne Chain of Thought verfügte. Sie erklärten, der GDM-Sicherheitsbericht und Alek widersprächen sich bei der Frage, wie gut Argon überwacht werden kann. Sie wollten das Thema in einem späteren Beitrag erörtern.
Die Forscher argumentieren außerdem, dass Überprüfungen der Überwachbarkeit möglicherweise umfassendere Vorteile von Chain of Thought nicht erfassen. Dazu gehöre auch, dass Menschen die Gründe für das Verhalten eines Modells besser verstehen können. Ein Monitor könne riskantes Verhalten allein anhand der Handlungen eines Modells erkennen, erklärten sie, ohne zu zeigen, ob das Training die Aussagekraft des Schlussfolgerns verringert hat.
Redwoods wahrscheinlichste Erklärung ist, dass der scheinbare Widerspruch auf einem Missverständnis beruht und GDM Chain of Thought nicht auf eine besonders bedenkliche Weise gezielt trainiert. Die Forscher erklärten jedoch, sie wünschten sich eine Klarstellung. Mehr Transparenz von KI-Unternehmen würde es externen Forschern erleichtern, die Sicherheitsfolgen ihrer Trainingspraktiken zu bewerten.
Redwood Research: We don’t understand whether GDM intentionally trains on CoT