Spotify-Studie: Einfache Paarmodelle schlagen Transformer in vier von fünf Benchmarks
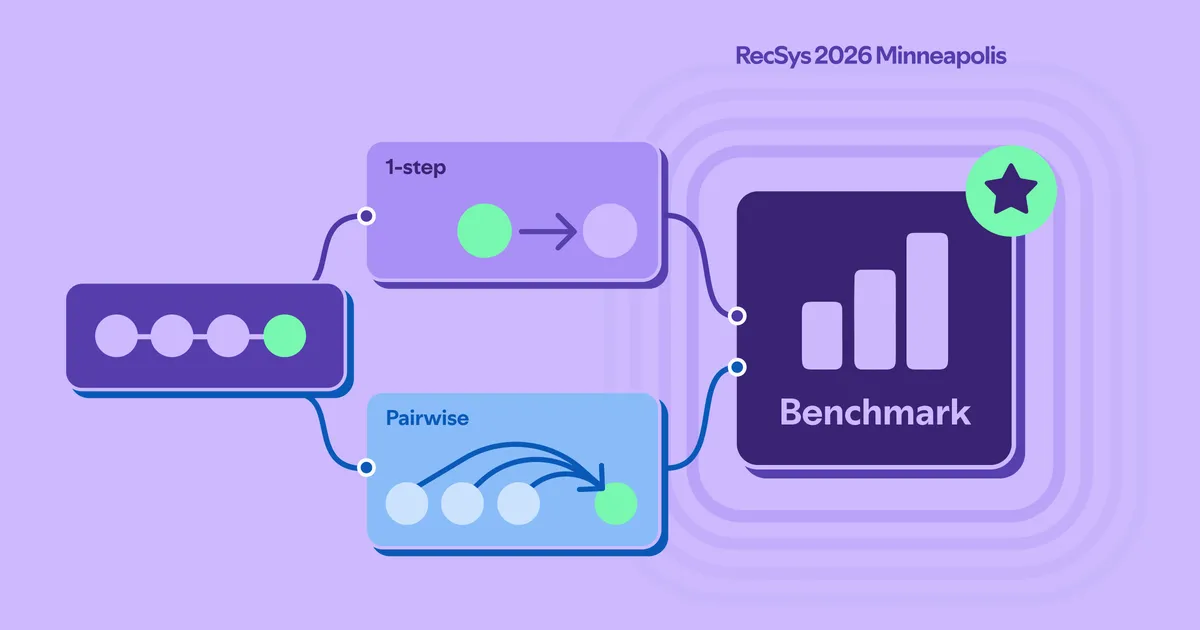
Spotify Research berichtet, dass in vier von fünf gängigen Benchmarks für sequenzielle Empfehlungen mindestens ein einfacheres Modell, das nur paarweise Übergänge berücksichtigt, besser abschneidet als beide nachgebauten Transformer-Modelle. Das Team argumentiert, hohe Benchmark-Werte belegten nicht zwangsläufig, dass die Modellierung von Sequenzen höherer Ordnung die Gewinne antreibt.
- In vier von fünf Benchmarks schlägt mindestens ein paarweises Modell beide Nachbauten von SASRec und eSASRec.
- Auf MovieLens-20M behalten die getesteten Transformer einen Vorsprung vor den paarweisen Modellen.
- Spotify schlägt mit PCTM ein zählbasiertes Modell ohne Item-Embeddings und ohne Sequenz-Encoder vor.
- Auf MovieLens-1M erreicht PCTM 0,1815 NDCG@10, eSASRec kommt auf 0,1739.
- Die Ergebnisse sind Punktschätzungen; die Arbeit weist keine Konfidenzintervalle aus.
Die Fragestellung der Studie
Modelle für sequenzielle Empfehlungen sagen voraus, womit ein Nutzer als Nächstes interagiert. Transformer-Architekturen wie SASRec sind für diese Aufgabe weit verbreitet, weil Self-Attention es ihnen erlaubt, komplexe, kontextabhängige Zusammenhänge über die gesamte Interaktionshistorie eines Nutzers hinweg abzubilden. In der Forschung werden sie üblicherweise auf Benchmarks getestet, die aus Datensätzen wie Amazon und MovieLens gebildet werden.
Spotify Research fragt, was diese Benchmarks tatsächlich prüfen. Den Forschenden zufolge können starke Vorhersagesignale bereits aus relativ simplen Mustern entstehen: der Beliebtheit von Items, paarweisen Übergängen zwischen Items und der Aktualität. Wenn einfachere Modelle, die auf diesen Signalen aufbauen, mit ausdrucksstärkeren mithalten, misst der Benchmark womöglich nicht das, was man annimmt.
Drei Stufen der Modellkomplexität
Das Team vergleicht drei Stufen dessen, was ein Modell darstellen kann, und bewertet insgesamt sieben Modelle.
- Last-Item-Modelle: Nur die jüngste Interaktion fließt in den Score ein. Die drei Kontrollmodelle sind ein Markov-Chain-Modell (MC), FMC und FMC+. FMC lernt, das tatsächlich beobachtete nächste Item von einer zufällig gezogenen Alternative zu unterscheiden, während FMC+ es im Training mit dem gesamten Katalog vergleicht.
- Paarweise Modelle: Jedes Item der Historie liefert Hinweise darauf, was danach folgt, doch jeder Beitrag bleibt getrennt und wird mit festen Aktualitätsgewichten kombiniert. Die beiden Modelle sind Sequential Rules und das neu vorgeschlagene Probabilistic Collaborative Transition Model (PCTM).
- Transformer-basierte Modelle: SASRec und eSASRec, eine auf der RecSys 2025 vorgestellte verbesserte Version, können jedes Item der Historie im Kontext der anderen interpretieren. Diese Fähigkeit nennen die Forschenden Sequenzmodellierung höherer Ordnung.
PCTM zählt, welche Items in den Trainingshistorien auf ein jeweiliges Ausgangsitem folgen, und gewichtet nahe beieinanderliegende Vorkommen stärker. Es startet mit gleichen Wahrscheinlichkeiten für alle Katalog-Items und aktualisiert sie mit den beobachteten Häufigkeiten, sodass bei knappen Daten die Ausgangsannahme stärker durchschlägt. Laut den Forschenden ergeben sich die Schätzungen direkt aus Ereigniszählungen, ohne Item-Embeddings und ohne Sequenz-Encoder.
Versuchsaufbau
Getestet wurden die Modelle auf Amazon Beauty, Sports und Toys sowie auf MovieLens-1M und MovieLens-20M. Alle nutzten die mit eSASRec veröffentlichten Datenaufteilungen und das dazugehörige Evaluationsprotokoll. Nach Angaben der Forschenden stimmten ihre Nachbauten von SASRec und eSASRec eng mit den Werten der eSASRec-Studie überein und wichen über alle fünf Datensätze hinweg um höchstens 0,0033 NDCG@10 ab. NDCG@10 belohnt ein Modell dann, wenn das Item, mit dem der Nutzer als Nächstes interagiert hat, weiter oben in den ersten zehn Empfehlungen erscheint.
Ergebnisse
In vier der fünf Benchmarks schneidet mindestens ein paarweises Modell besser ab als beide Transformer-Nachbauten. Auf MovieLens-20M behalten die getesteten Transformer jedoch einen Vorsprung vor den paarweisen Modellen.
Frühere Historie hilft deutlich. Auf jedem Datensatz schlagen beide historienbasierten paarweisen Modelle alle drei Last-Item-Kontrollmodelle, und das stärkere paarweise Modell verbessert sich laut den Forschenden gegenüber der besten Last-Item-Kontrolle um etwa 20 bis 46 %. FMC+ ist bereits konkurrenzfähig: Auf Beauty liegt es nahe an SASRec, auf Toys über beiden Transformern.
Beide paarweisen Modelle liegen in allen drei Amazon-Benchmarks über beiden Transformern. Auf MovieLens-1M schlägt PCTM ebenfalls beide und erreicht 0,1815 gegenüber 0,1739 bei eSASRec, eine relative Verbesserung von rund 4,4 %. Die Forschenden betonen, dass es sich um Punktschätzungen handelt und die Arbeit keine Konfidenzintervalle ausweist.
Was das bedeutet
Für alle, die Empfehlungssysteme entwickeln oder bewerten, ist der Befund eine Mahnung zur Vorsicht bei der Interpretation von Benchmark-Ergebnissen. Ein hoher Wert in diesen Amazon- und MovieLens-Tests zeigt für sich genommen nicht, dass ein Modell gemeinsame Wechselwirkungen innerhalb der Nutzerhistorie erfasst, denn Modelle, die jedes frühere Item getrennt behandeln, können Transformer erreichen oder übertreffen. MovieLens-20M ist in dieser Studie die Ausnahme, hier behalten die Transformer ihren Vorsprung. Der vorliegende Quelltext endet vor der vollständigen Diskussion der übrigen Ergebnisse.
Spotify Research: Do Sequential Recommendation Benchmarks Require Higher-Order Sequence Modelling?