NVIDIA TensorRT Edge-LLM bringt Nemotron-3.5 Lightning mit wenigen Befehlen auf den DGX Spark
NVIDIA hat ein Tutorial veröffentlicht, das zeigt, wie Entwickler eingebetteter Systeme das Modell Nemotron-3.5 Lightning mit der Laufzeitumgebung TensorRT Edge-LLM auf einem DGX Spark 64GB betreiben können. Laut NVIDIA steigert das spekulative Decoding mit DSpark die durchschnittliche Generierungsgeschwindigkeit bei HumanEval-Prompts von 73,4 auf 126,9 Token pro Sekunde.
- Das NVIDIA-Tutorial betreibt Nemotron-3.5 Lightning auf dem DGX Spark 64GB mit TensorRT Edge-LLM und der trtedge-CLI.
- Beim ersten Start werden rund 21GB Modelldateien geladen und Engines gebaut, die bei späteren Starts zwischengespeichert wiederverwendet werden.
- Ein lokaler OpenAI-kompatibler API-Server unterstützt Prototyping und Tests von Anwendungen.
- Mit DSpark und drei Entwurfs-Token steigt die durchschnittliche Geschwindigkeit bei HumanEval-Prompts von 73,4 auf 126,9 Token pro Sekunde.
- Die maximale Systemspeicherauslastung mit DSpark lag bei 27,9GB, einschließlich des Betriebssystems.
Eine Laufzeitumgebung von der Entwicklung bis zum Einsatz
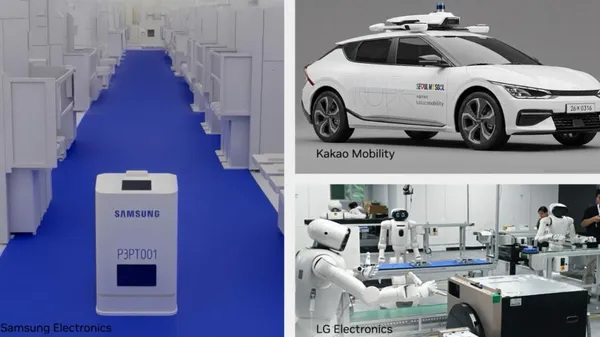
Laut NVIDIA verlässt KI zunehmend das Rechenzentrum, da Entwickler Agenten für den Edge-Bereich bauen. Als Beispiele nennt das Unternehmen die Überwachung der Fahreraufmerksamkeit und der Kabinenbedingungen, die Unterstützung von Robotern beim Verstehen ihrer Umgebung und bei der Aufgabenplanung sowie die Koordination von Maschinenflotten in Produktionslinien. Solche Anwendungen müssen mit knappen Speicher-, Energie- und Latenzbudgets auskommen, und NVIDIA weist darauf hin, dass es erheblichen Einrichtungsaufwand bedeuten kann, ein Modell lauffähig zu machen.
NVIDIA DGX Spark, inzwischen auch in einer 64GB-Konfiguration erhältlich, positioniert das Unternehmen als Plattform, auf der Entwickler eingebetteter Systeme Modelle und Agenten prototypisch aufbauen, feinabstimmen und testen können. TensorRT Edge-LLM ist eine schlanke C++-Inferenz-Laufzeitumgebung für Embedded-Workloads. Laut NVIDIA bringt sie dasselbe Inferenz-Framework sowohl in die Entwicklung auf dem Spark als auch in den Einsatz auf Plattformen wie Jetson Thor, DRIVE AGX Thor und IGX Thor.
Von der Installation bis zu Chat und API-Server
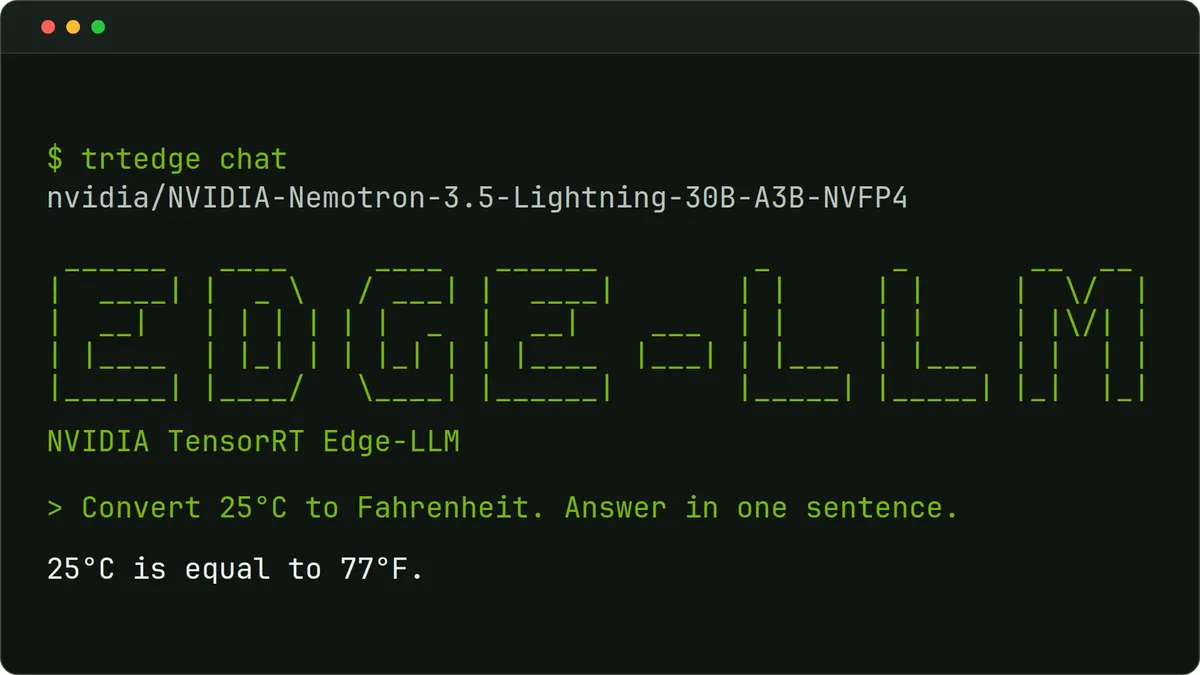
Im Mittelpunkt des Tutorials steht die Kommandozeilenschnittstelle trtedge, die ein ausgewähltes Modell herunterlädt und für die Inferenz auf dem Spark optimierte TensorRT-Engines baut. Als Beispielmodell dient NVIDIA Nemotron-3.5 Lightning, ein reines Textmodell.
Voraussetzungen sind ein DGX Spark mit unterstütztem NVIDIA-Software-Stack, NVIDIA CUDA 13, TensorRT 10.16.1.11 oder neuer innerhalb der 10.x-Reihe sowie Python 3.10 bis 3.12. Die Beispiele wurden mit TensorRT Edge-LLM 0.11.1 und TensorRT 10.16.1.11 getestet. Nutzer legen eine virtuelle Umgebung an, installieren das Paket, prüfen die TensorRT-Version und starten dann mit dem Befehl trtedge chat einen Chat.
Beim ersten Start sind ein Modell-Download von rund 21GB und ein Engine-Build nötig. Die Dateien werden standardmäßig in ~/.cache/tensorrt-edgellm abgelegt, sodass Platz für Modell und Engines vorhanden sein muss. Bei späteren Starts werden passende zwischengespeicherte Engines wiederverwendet.
Dasselbe Modell lässt sich mit trtedge serve auch über eine lokale OpenAI-kompatible API auf dem Spark bereitstellen, gedacht für Anwendungsentwicklung und Tests. Ein Health-Endpunkt bestätigt die Betriebsbereitschaft, und der Chat-Completions-Endpunkt streamt Antworten als JSON-Ereignisse.
Spekulatives Decoding mit DSpark und Benchmark-Ergebnisse
Optional können Entwickler das spekulative Decoding mit DSpark aktivieren. Dabei schlägt ein Entwurfsmodell mehrere Token vor, die das Hauptmodell in einem einzigen Durchlauf überprüft. Das Tutorial verwendet drei Entwurfs-Token und weist darauf hin, dass Nutzer mit der Zahl der spekulativen Token und weiteren Einstellungen experimentieren können, um das Tempo für ihre Workload abzustimmen.
NVIDIA nennt folgende Messwerte auf dem DGX Spark 64GB, jeweils mit medianer Zeit bis zum ersten Token (TTFT) und durchschnittlicher Generierungsgeschwindigkeit:
- SpeedBench 1K: 201,0 ms und 73,3 Token/s ohne DSpark; 203,0 ms und 108,5 Token/s mit DSpark.
- SpeedBench 2K: 329,5 ms und 72,8 Token/s ohne DSpark; 331,6 ms und 105,3 Token/s mit DSpark.
- HumanEval-Prompts: 98,1 ms und 73,4 Token/s ohne DSpark; 98,7 ms und 126,9 Token/s mit DSpark.
Die maximale Auslastung des gesamten Systemspeichers während der Inferenz mit DSpark lag bei 27,9GB, einschließlich des Betriebssystems. Laut NVIDIA liefen die Tests unter DGX OS 7.6.0 (Ubuntu 24.04.4 LTS) mit NVFP4 bei aktiviertem Thinking, Batchgröße eins, einer gleichzeitigen Streaming-Anfrage und einem Ausgabelimit von 128 Token. Die durchschnittliche Eingabelänge betrug 1.153 Token bei SpeedBench 1K, 2.247 bei SpeedBench 2K und 139 bei HumanEval.
Was das für Edge-Entwickler bedeutet
Das Tutorial senkt den Aufwand, ein Modell auf dem Spark auszuprobieren: Wenige Befehle liefern einen Terminal-Chat und eine lokale API, die die OpenAI-Schnittstelle nachbildet. Damit können Teams Anwendungen prototypisch entwickeln, bevor sie auf die Zielhardware wechseln. In NVIDIAs Messungen ließ DSpark die Zeit bis zum ersten Token nahezu unverändert und steigerte zugleich die Generierungsgeschwindigkeit bei allen drei Workloads.
NVIDIA empfiehlt, auch andere Modelle aus der Liste der unterstützten Modelle auszuprobieren, darunter Vision-Language-Modelle, die Bilder und Videos interpretieren, sowie Modelle für Spracherkennung und Sprachsynthese. Entwickler sollten in der TensorRT-Edge-LLM-Dokumentation modellspezifische Workflows und Anforderungen für ihre eingebettete Zielplattform nachlesen.
NVIDIA Developer: Run AI Models for Edge Application Development with Just a Few Commands