Mooncake
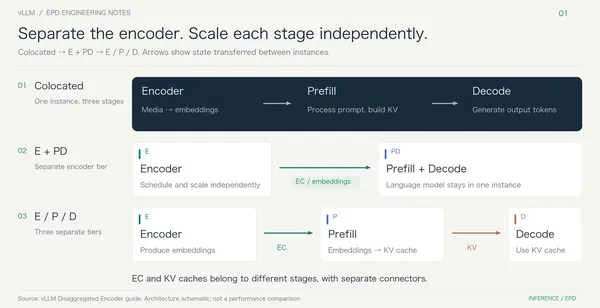
vLLM baut Encoder-Disaggregation für multimodale KI aus
vLLM hat technische Arbeiten vorgestellt, die die multimodale Kodierung vom Prefill und Decode des Sprachmodells trennen. Dadurch können Betreiber diese Phasen…
Furiosa SDK 2026.4 steigert Tokens pro Watt beim RNGD und bringt gestuftes KV-Caching
FuriosaAI hat das Furiosa SDK 2026.4 für seinen RNGD-Beschleuniger veröffentlicht und meldet eine höhere Token-Generierung pro Watt bei 18 Modellen im Vergleich zum SDK…