vLLM baut Encoder-Disaggregation für multimodale KI aus
vLLM hat technische Arbeiten vorgestellt, die die multimodale Kodierung vom Prefill und Decode des Sprachmodells trennen. Dadurch können Betreiber diese Phasen unabhängig voneinander skalieren. Das als Encoder, Prefill, Decode oder EPD bekannte Projekt ergänzt Anfragen nur mit Metadaten, die Übertragung von Embeddings aus der Ferne und einen dedizierten Ausführungspfad für Encoder.
- EPD trennt Bereitstellungen für Encoder, Prefill und Decode.
- Anfragen nur mit Metadaten vermeiden die wiederholte Verarbeitung multimodaler Medien.
- Eine Audio-Evaluierung erreichte mit der Weiterleitung nur mit Metadaten 73.13 Anfragen/s.
- Ein Kimi-K3-Encoder lud 2 von 96 Checkpoint-Shards.
- Die Kernfunktionen sind in vLLM v0.32.0 enthalten.
Multimodale Verarbeitung von der Sprachgenerierung trennen
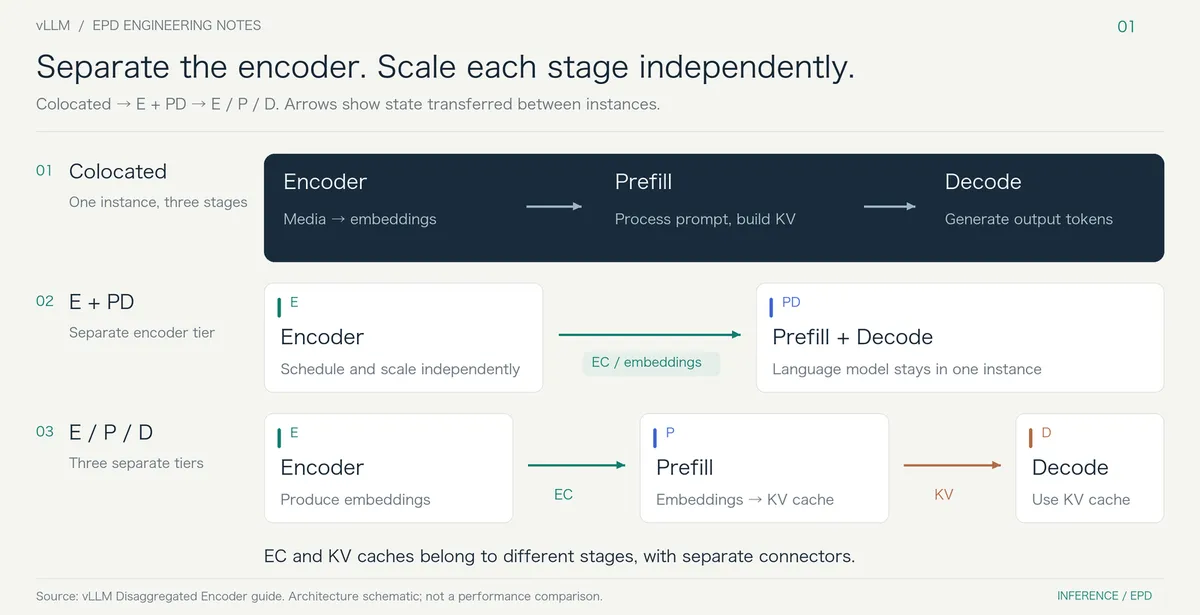
Multimodale Anfragen durchlaufen typischerweise drei Phasen. Der Encoder verarbeitet Bilder, Videoframes oder Audio vor und erzeugt Embeddings. Beim Prefill werden der Prompt und diese Embeddings verarbeitet, während der Decode die Ausgabetokens generiert.
vLLM unterstützt zwei EPD-Bereitstellungsmuster: E+PD, bei dem die Kodierung von einer kombinierten Prefill- und Decode-Instanz getrennt ist, und E/P/D, bei dem alle drei Phasen separat bereitgestellt werden. Encoder-Connectoren übertragen Embeddings, während KV-Connectoren den Zustand zwischen Prefill und Decode übertragen.
Durch diese Trennung können Betreiber die Anzahl der Instanzen und die Ausführungseinstellungen für jede Phase anpassen. Ein Arbeitsaufkommen mit vielen Bildern kann mehr Encoder-Kapazität erhalten, ohne die Decode-Kapazität entsprechend zu erhöhen. Arbeitsaufkommen mit längeren Antworten lassen sich anders konfigurieren.
Anfragen nur mit Metadaten vermeiden die wiederholte Medienverarbeitung
Die Übertragung von Embeddings zwischen Instanzen liefert allein noch nicht alle Informationen, die zur Rekonstruktion einer multimodalen Eingabe erforderlich sind. Die nachgelagerte Instanz benötigt möglicherweise weiterhin Platzhalterlängen, Bildraster, Merkmalslängen und Kennungen, die beschreiben, an welcher Stelle die Embeddings eingefügt werden.
Der Pfad für Anfragen nur mit Metadaten von vLLM ersetzt das nachgelagerte Medienelement durch eine Referenz mit strukturellen Informationen, die vom Encoder erzeugt wurden. Der Verbraucher rekonstruiert anhand dieser Metadaten das Layout der Eingabe und erhält die Embeddings über einen Encoder-Connector. Text-Prompt und Einstellungen für die Generierung bleiben unverändert.
Der Python-EPD-Pfad unterstützt diese Übergabe für Bilder, Videos und Audio in unterstützten Modellen. Bei Bildeingaben aus der Qwen-Familie kann beispielsweise image_grid_thw verwendet werden, während Videoeingaben in Qwen3-VL video_grid_thw und vom Encoder veröffentlichte Zeitstempel nutzen können. Audiopfade können Tokenzahlen und Merkmalslängen übertragen, die zum Wiederaufbau der Platzhalter erforderlich sind.
In einer Evaluierung mit Qwen3-Omni-30B-A3B-Instruct erhöhte die Weiterleitung nur mit Metadaten den Durchsatz von 62.21 auf 73.13 Anfragen/s und verringerte die mittlere Latenz von 980 auf 853 ms. Die Genauigkeit änderte sich von 75.90% auf 75.65%, ein Unterschied, den vLLM nach eigenen Angaben noch untersucht.
Dedizierte Encoder-Ausführung und breitere Integrationen für das Serving
Model Runner V2 bietet nun einen dedizierten MMEncoderModelRunner für reine Encoder-Instanzen. Diese Instanzen führen das Sprachmodell nicht aus, verwalten keinen KV-Cache des Sprachmodells und erzeugen keine abgetasteten Tokens. Der dedizierte Pfad steuert daher den GPU-Abschluss, ohne auf das Token-Sampling angewiesen zu sein.
Zu den damit verbundenen Änderungen gehören ein automatischer Nur-Encoder-Modus für reine Producer-Instanzen von Encoder-Connectoren, eine reduzierte I/O-Zeit beim Start und die optionale Aufzeichnung von Encoder-CUDA-Graphen. Bei einem gekürzten Kimi-K3-Checkpoint las der Encoder 2 von 96 Shards ein, und die Dauer des Ladens der Gewichte sank von 683 s auf 0.31 s.
vLLM beschreibt außerdem die Übertragung von Embeddings aus der Ferne über NIXL und Mooncake, die encoderübergreifende Wiederverwendung von Ausgaben über Mooncake Store sowie einen geringeren Orchestrierungsaufwand im Python-EPD-Proxy. Die EPD-Orchestrierung wird in vLLM Router, SMG und llm-d integriert.
Die beschriebenen Kernfunktionen, einschließlich der Unterstützung für MiMo und XPU, sind in vLLM v0.32.0 enthalten. Die Unterstützung für DeepSeek V4.1 Flash mit Anfragen nur mit Metadaten ist über #62802 im main-Zweig verfügbar, während die Integrationen von vLLM Router und SMG ihre jeweiligen main-Zweige verwenden. Für Nutzer und Betreiber bieten die Änderungen mehr Möglichkeiten, die Arbeit beim multimodalen Serving entsprechend den Anforderungen von Medienverarbeitung, Prompt-Verarbeitung und Tokengenerierung zu verteilen.