vLLM meldet 58-fachen Durchsatz für DeepSeek-V4.1-Flash auf Vera Rubin
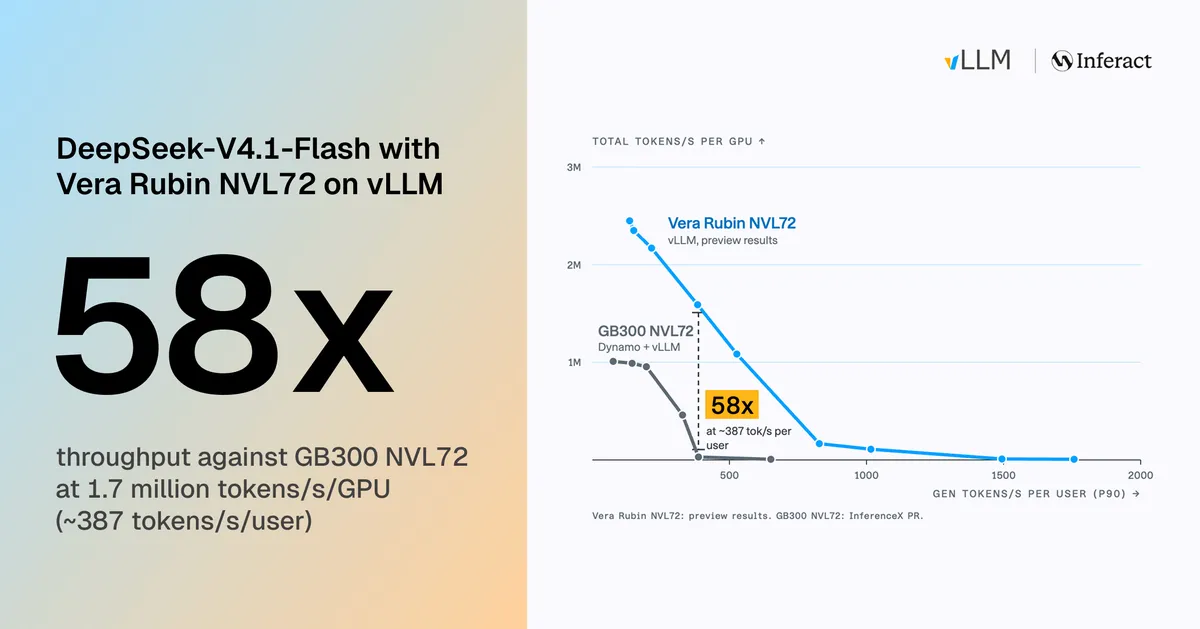
vLLM gibt an, DeepSeek-V4.1-Flash auf einem NVIDIA-Vera-Rubin-NVL72-Rack mit 1,7 Mio. Tokens pro Sekunde und GPU zu betreiben, während jeder Nutzer 387 Tokens pro Sekunde erhält. Das Unternehmen meldet den 58-fachen Durchsatz eines GB300-NVL72-Systems, wobei der Spitzendurchsatz 2,52 Mio. Tokens pro Sekunde erreicht.
- vLLM meldet 1,7 Mio. Tokens/s pro GPU auf Vera Rubin NVL72.
- Jeder Nutzer erhält laut vLLM 387 Tokens/s.
- Das Unternehmen meldet den 58-fachen Durchsatz eines GB300 NVL72.
- Der Spitzendurchsatz erreicht 2,52 Mio. Tokens/s.
- Ein einzelner Nutzer erreicht bei Batch-Größe 1 1.810 Tokens/s.
Rubin-Hardware treibt Leistungsgewinne voran
Die Ergebnisse beruhen auf der Anpassung von vLLMs DeepSeek-V4.1-Flash-Serving-Stack an Vera Rubin. Nach Angaben des Unternehmens eröffnet diese Plattform mehrere Optimierungsmöglichkeiten. Die GPUs des Racks verfügen über zwei Speicherbereiche. Daten mit begrenzter Streaming-Bandbreite aus dem eigenen Bereich eines SM zu laden, ist schneller als der Zugriff auf verschachtelten oder entfernten Speicher.
vLLM hat die MoE-, Attention-, GEMM-, mHC- und Indexer-Kernels des Modells für Rubin neu entwickelt oder überarbeitet. Außerdem nutzt das Unternehmen die breiteren blockskalierten Matrixmultiplikationsbefehle von SM107, darunter K64-Mixed-Precision-FP8×FP4-MMA und K128-FP4-MMA. Laut vLLM erzielt MegaMoE bei 8K oder mehr Tokens pro Rank 8, 11 % mehr Durchsatz, während ein GEMM mit geringer Batch-Größe 12 % schneller läuft.
Das System nutzt außerdem eine rackweite NVLink-Domäne. Laut vLLM kann TP8 dadurch zwei Compute-Trays mit nahezu keinen zusätzlichen All-Reduce-Kosten überspannen, während Prefill-Instanzen effizient auf den HBM-Speicher der jeweils anderen Instanzen zugreifen können.
Kernel-Änderungen verkürzen Prefill- und Decode-Zeit
Für Prefill meldet vLLM bei 32K Tokens pro Rank rund 28 % weniger Zeit pro DEP2-Schritt. Zu den Änderungen gehören ein lokaler mHC-Residual-Stream für jeden Speicherbereich, verbesserte Attention-Pipelines und das Herausfiltern von Experten vor ihrer Bewertung. Auch die Größe der MegaMoE-Kacheln wurde angepasst, um die jeweils größere Zahl lokaler und durchschnittlicher Tokens der Datenparallelisierung zu berücksichtigen.
Für Decode meldet das Unternehmen gegenüber seinem ersten Rubin-Build rund 25 % weniger Zeit pro DEP32-Schritt. Zu den Änderungen gehören die Nutzung von Expertengewichten auf dem jeweiligen Die und ein Wide-EP-Dispatch-Design, das den Datenverkehr zum entfernten Speicher reduziert. Laut vLLM ist der DEP2-Decode-Foreward bei einer Batch-Größe von 32 um 10,1 % und bei einer Batch-Größe von 168 um 5,5 % schneller.
Ein spezieller tensorparalleler Decode-Pfad verteilt das Modell mit TP8 auf zwei Trays. In dieser Konfiguration meldet vLLM für einen einzelnen Nutzer bei Batch-Größe 1 im 90. Perzentil 1.810 Tokens pro Sekunde.
Rack-Skalierung des Speichers ermöglicht höhere Parallelität
Die Geschwindigkeit von Vera Rubin ermöglicht es dem System laut vLLM, eine deutlich höhere Parallelität zu verarbeiten. Das Unternehmen bündelt den Rack-Speicher über ein workload-bewusstes Routing von Dynamo. Sein Mooncake-KV-Pool reicht vom DRAM bis zu freiem HBM, während Engram-Tabellen über den HBM der GPUs verteilt werden.
vLLM meldet eine Prefix-Trefferrate von 96,5, 97 % selbst bei sehr hoher Parallelität, und gibt an, dass allein das Routing die Ranks ausbalanciert. Beim Benchmark handelt es sich um SemiAnalysis AgentX, den vLLM als repräsentative agentische Serving-Last verwendet und mit gecachten Eingabe-, nicht gecachten Eingabe- und Ausgabetokens misst.
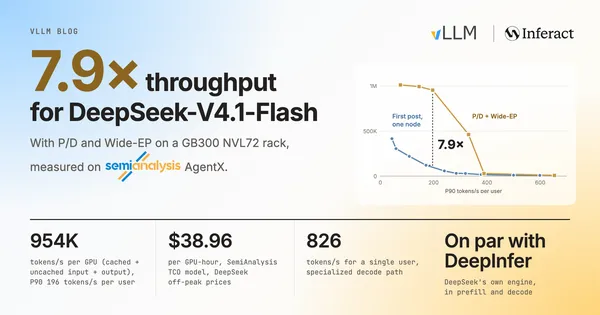
Die Ergebnisse bauen auf vLLMs früherer Arbeit zu DeepSeek-V4.1-Flash auf. Der erste Beitrag behandelte die Inbetriebnahme am ersten Tag und Kernel-Fusionen, während der zweite das Modell mithilfe von P/D-Disaggregation und Wide-EP auf ein GB300-NVL72-Rack skalierte. Die Ergebnisse mit Vera Rubin zeigen, wie sich derselbe Serving-Stack verändert, wenn er Rubins Speicheranordnung, FP4-Tensorkerne und rackweites NVLink nutzen kann.