vLLM kombiniert PCP und DCP, um GLM-5.3 mit 1 Million Token Kontext auf 16 H200 zu betreiben
Das vLLM-Team zufolge ermöglicht die Kombination aus Prefill Context Parallelism (PCP), Decode Context Parallelism (DCP) und Hybrid HiSparse, GLM-5.3 mit Kontexten von 1 Million Token auf 16 H200-GPUs zu betreiben. Laut vLLM war es die einzige getestete Konfiguration, die solche Anfragen verarbeiten konnte.
- vLLM kombiniert PCP, DCP und Hybrid HiSparse, um GLM-5.3 auf 16 H200-GPUs, aufgeteilt in Prefill- und Decode-Knoten, zu betreiben.
- Eine Anfrage mit 1 Million Token braucht 53,4 GiB FP8-KV; DCP8 senkt das auf 6,7 GiB pro GPU.
- DCP8 verursacht laut vLLM etwa 6 % Mehraufwand pro Schritt bis 64K Token Kontext und 15 % bei 248K.
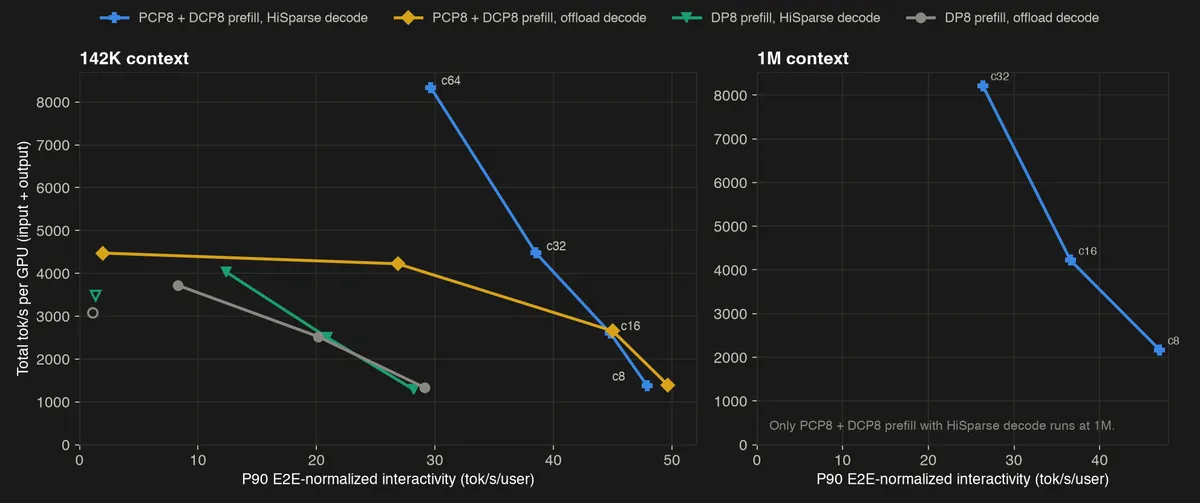
- Auf AgentX meldet vLLM das 1,7- bis 3,2-Fache der Geschwindigkeit pro Nutzer eines datenparallelen Deployments bei gleichem Durchsatz.
- Laut vLLM war es die einzige getestete Konfiguration, die Kontexte mit 1 Million Token bedienen konnte.
Das Problem: lange agentische Kontexte auf H200-GPUs
Im zweiten Teil seiner Serie zur Optimierung von GLM-5.3 beschreibt vLLM zwei Grenzen, an die lange agentische Workloads auf H200-GPUs stoßen: den KV-Cache-Speicher und die Prefill-Geschwindigkeit. Agentische Kontexte wachsen mit jeder Runde, da Tool-Ausgaben und Dateiinhalte hinzukommen. Auf H200-GPUs belegen die Gewichte von GLM-5.3 den Großteil des Speichers jeder GPU, sodass für den KV-Cache wenig Platz bleibt. Unter Last können zudem die Prefill-Engines zum Engpass des gesamten Deployments werden.
Das Setup nutzt 16 H200-GPUs, aufgeteilt in einen Prefill-Knoten und einen Decode-Knoten. Teil 1 der Serie zeigte, wie Hybrid HiSparse lange Kontexte in einem aggregierten Deployment auf einem einzelnen 8x-H200-Knoten möglich macht. Teil 2 überträgt den Ansatz auf die Trennung von Prefill und Decode (Prefill/Decode Disaggregation).
PCP und DCP auf dem Prefill-Knoten
Laut vLLM reichen die üblichen Optionen nicht aus. Bei DP8 wird jeder Prompt von einer einzelnen GPU verarbeitet, was die Time to First Token bei langen Prompts begrenzt und den gesamten KV-Cache in den Speicher dieser GPU zwingt. Bei TP8 werden die Attention-Heads auf die GPUs verteilt, doch der latente KV von MLA wird von allen 64 Heads gemeinsam genutzt, sodass jede GPU den vollständigen Cache speichert. Der Indexer, der die 2.048 Token auswählt, auf die Sparse MLA zugreift, wird nicht partitioniert, sodass sein quadratischer Aufwand auf jeder GPU erneut anfällt.
PCP teilt dagegen jeden Prompt nach Token auf. Jede GPU berechnet die Queries für ein Achtel des Prompts, und zwar mit allen 64 Heads. Um die Last der kausalen Attention auszugleichen, wird der Prompt in 16 Chunks zerlegt, von denen jede GPU einen vom Anfang und einen vom Ende erhält. Laut vLLM steigt dadurch die Intensität von Sparse MLA von rund 26 auf rund 191 FLOPs pro bewegtem Byte. Außerdem verschiebt sich der Punkt, an dem der Indexer bei einem Prefill von Grund auf Sparse MLA überholt, von etwa 32K Token bei TP8 auf etwa 256K bei PCP8.
Bei PCP speichert dennoch jede GPU den vollständigen KV-Cache. Eine GLM-5.3-Anfrage mit 1 Million Token benötigt 53,4 GiB FP8-KV, doch jede GPU hat nur Platz für etwa 15 GiB. DCP verteilt die Token reihum auf die acht GPUs, sodass dieselbe Anfrage nur 6,7 GiB pro GPU braucht. Der Preis ist ein All-Gather des gecachten Kontexts in jeder Schicht. vLLM maß bei DCP8 einen Mehraufwand von etwa 6 % pro Schritt bis 64K Token Kontext, der bei 248K auf 15 % steigt. Man arbeite daran, das All-Gather mit der Berechnung der vorherigen Schicht zu überlappen. Jenseits von etwa 250K Token kann PCP8 allein den KV-Cache nicht mehr halten, daher macht erst DCP lange Prompts möglich.
Deployment und Benchmark
Das Deployment läuft auf zwei 8x-H200-Knoten, mit FP8-KV-Cache und spekulativer MTP-Dekodierung mit drei Draft-Token auf beiden Engines.
- Prefill: eine PCP8-x-DCP8-x-EP8-Engine mit 512 GiB CPU-KV-Offload, damit spätere Runden ihr Präfix wiederverwenden.
- Decode: acht DP-Ranks mit EP8 und Hybrid HiSparse (48 GiB Host-Pool plus 16 GiB Offload pro Rank), sodass die Parallelität vom Host-Speicher statt vom HBM begrenzt wird.
Ein präfixbewusster llm-d-Router leitet jede Anfrage an die Prefill-Engine, der NIXL-Connector überträgt den KV-Cache an einen Decode-Rank, und dieser streamt die Token zurück. vLLM verglich dies mit DP8-Prefill und mit einfachem CPU-KV-Offloading auf dem Decode-Knoten, jeweils mit denselben 16 GPUs, demselben Host-Speicher und demselben vLLM-Build.
Der Test nutzte den Benchmark AgentX von SemiAnalysis, der Claude-Code-Traces mit Präfix-Wiederverwendung abspielt, mit einstündigen Läufen auf einem frischen Server pro Parallelitätsstufe. Die MTP-Akzeptanzlänge wurde synthetisch auf 2,99 festgelegt, damit alle Konfigurationen denselben Speedup durch spekulative Dekodierung erhalten.
Was das bedeutet
Laut vLLM liefert PCP8-x-DCP8-Prefill mit Hybrid-HiSparse-Decode bei gleichem Durchsatz das 1,7- bis 3,2-Fache der Geschwindigkeit pro Nutzer eines datenparallelen Deployments. Es ist zudem die einzige vom Team getestete Konfiguration, die Kontexte mit 1 Million Token bedient. Für Betreiber, die lange agentische Workloads auf speicherbeschränkter H200-Hardware fahren, deuten die Ergebnisse darauf hin, dass Parallelisierung auf Token-Ebene und KV-Speicherung im Host-Speicher Wege sind, sowohl Geschwindigkeit als auch Kontextlänge zu steigern. Die Zahlen stammen aus dem eigenen Benchmark-Setup von vLLM.