vLLM bietet ab Tag eins Unterstützung für Thinking Machines’ Inkling 2 Small
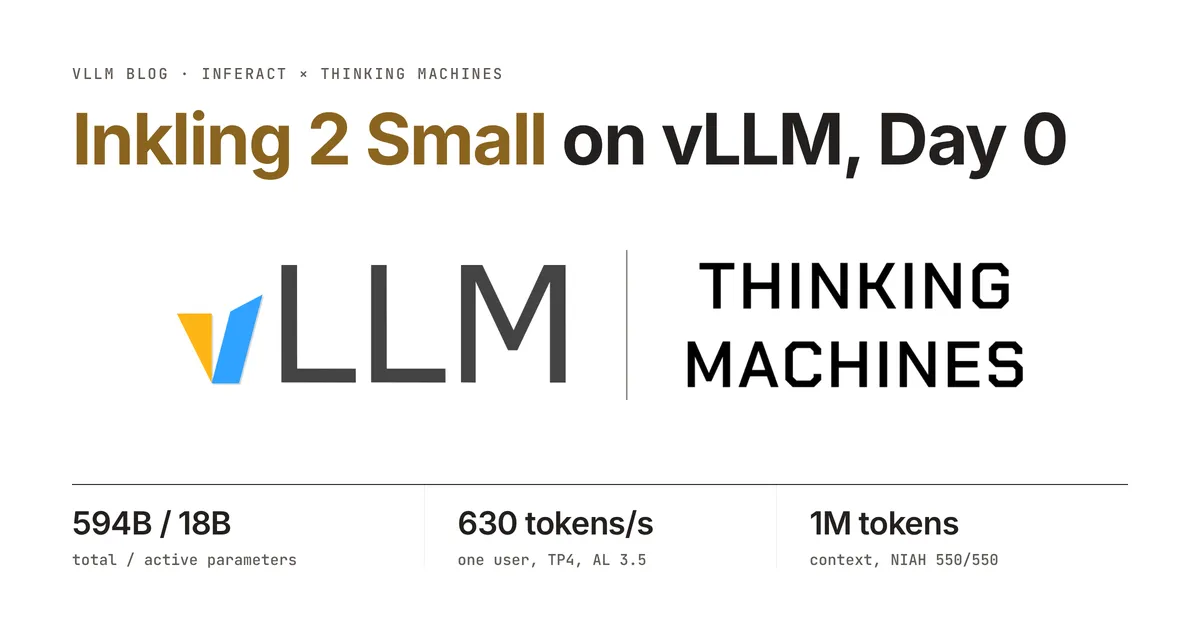
vLLM bietet ab Tag null Unterstützung für Thinking Machines’ Inkling 2 Small, ein multimodales Mixture-of-Experts-Modell, das Text und Bilder akzeptiert und Text ausgibt. Das Modell mit 48 Schichten verfügt insgesamt über 594 Mrd. Parameter, davon sind 17 Mrd. aktiv. Sein Kontextfenster reicht bis zu 1 Mio. Token.
- vLLM unterstützt Thinking Machines’ Inkling 2 Small ab Tag null.
- Das multimodale MoE-Modell verfügt insgesamt über 594 Mrd. und aktiv über 17 Mrd. Parameter.
- Sein Kontextfenster reicht bis zu 1 Mio. Token.
- DSpark erstellt nativ sieben Token pro Schritt als Entwurf.
- vLLM meldet für einen einzelnen Nutzer bei TP4 bis zu 630 Token pro Sekunde.
Größeres multimodales Modell mit überarbeiteter Architektur
Inkling 2 Small verwendet 384 geroutete Experten mit Top-8-Routing über alle Schichten hinweg. Seine 48 Schichten umfassen 40 Sliding-Window-Attention-Schichten und acht Schichten mit vollständiger Attention. Dabei nutzt das Modell ein Sliding Window mit 1.024 Token.
Das Modell behält Teile des ursprünglichen Inkling-Backbones bei, darunter Grouped-Query-Attention mit erlerntem relativem Bias, vier kurze Faltungen pro Schicht und ein per Sigmoid geroutetes MoE-Design. Hinzu kommen Block-Attention-Residuals, eine gegatete Attention mit einem Attention-Sink pro Token sowie ein 23 Schichten umfassender ViT-Bild-Encoder, der mit 20×20-Patches arbeitet.
Im Vergleich zu Inkling akzeptiert das neue Modell Text und Bilder statt Text, Bildern und Audio. Laut vLLM kann das Modell auf einem einzelnen Knoten betrieben werden, da sein MoE mit gemischter Präzision NVFP4 in den Schichten 0 und 39 sowie MXFP8 in den Schichten 40 und 47 verwendet.
Native DSpark-Unterstützung und vLLM-Optimierungen
Inkling 2 Small wird mit einem nativen DSpark-Spekulator ausgeliefert. Sein fünf Schichten umfassender RNN-Kopf erstellt pro Schritt sieben Token als Entwurf und ersetzt damit die acht verketteten MTP-Köpfe von Inkling. vLLM unterstützt spekulatives Decoding mit DSpark und bietet außerdem über SkyRL Unterstützung für Reinforcement Learning sowie LoRA-Unterstützung.
Die Integration kombiniert Kernel-Fusion, programmatische abhängige Starts und Sequenzparallelität. Laut vLLM verbinden die fusionierten Kernel Kommunikations- und speichergebundene Operationen rund um die Attention-Residuals des Modells. Die Sequenzparallelität vermeidet derweil wiederholte Arbeit während des Prefillings. Bei einem Prefill mit 8K Token verkürzt dies den Schritt nach Unternehmensangaben bei TP4 um 22 Prozent und bei TP8 um 26 Prozent. Außerdem werden 1,3 beziehungsweise 1,9 GiB pro GPU für den KV-Cache frei.
Für das Decoding entwickelte vLLM außerdem einen warp-spezialisierten Gluon-Kernel. In seinem Test sank die Dauer eines Decode-Schritts bei Batch 1 und einem Kontext von 100K von 15,1 ms auf 4,8 ms. Das Unternehmen führt die Änderung darauf zurück, dass sechs Attention-Köpfe in einem Tile gebündelt und die Schlüssel- und Wertdaten nur einmal gelesen werden.
Gemeldeter Durchsatz und Genauigkeitsprüfungen
Bei einer agentenbasierten Arbeitslast mit TP8, DSpark mit probabilistischem Drafting und Prefix-Caching maß vLLM den Ausgabe-Durchsatz pro GPU bei einer Parallelität, bei der jeder Nutzer 100 Token pro Sekunde erhielt. Bei einem Kontext von 32K lag das Ergebnis bei etwa 1.070 Ausgabe-Token pro Sekunde und GPU über rund 84 parallele Sitzungen hinweg, mit einer Prefix-Cache-Trefferrate von 91 Prozent und einer Akzeptanzlänge von 3,3.
Bei Kontexten von 64K, 128K und 256K lag der gemeldete Durchsatz bei etwa 915, 700 beziehungsweise 450 Ausgabe-Token pro Sekunde und GPU. Die entsprechenden Zahlen paralleler Sitzungen betrugen etwa 72, 55 und 37. Für einen einzelnen Nutzer bei TP4 meldet vLLM etwa 630 Token pro Sekunde bei einer Akzeptanzlänge von 3,5.
Laut vLLM bewahrt die Implementierung die numerischen Referenzwerte, darunter die FP32-Berechnung der Attention-Ausgabe und des Routers sowie dieselbe Aktivierungsquantisierung mit NVFP4 und MXFP8. Das Team überprüfte die Genauigkeit mit aktiviertem DSpark bei NIAH bis zu 1 Mio. Token, MMMU-Pro und HLE. Nach Angaben des Unternehmens stimmten die Ergebnisse mit Läufen ohne spekulatives Decoding überein.
vLLM: Inkling 2 Small on vLLM: Day-0 Support