Meta zeigt flüssigkeitsgekühltes Switch-Rack mit 102,4 Tbit/s und neues GPU-Fabric auf dem OCP 2026
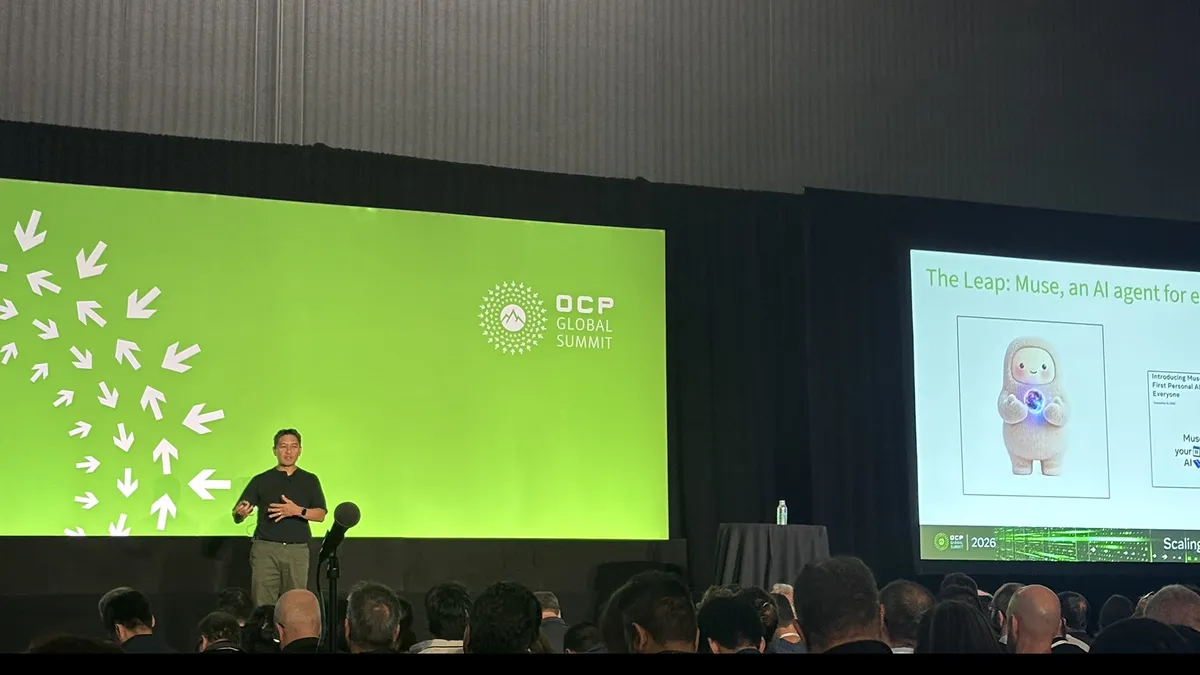
Auf dem Open Compute Project Global Summit 2026 hat Meta sein erstes flüssigkeitsgekühltes Netzwerk-Rack namens IcePack vorgestellt, dazu IceCube-Switch-Blades mit 102,4 Tbit/s und ein neues Multiplane-GPU-Fabric mit dem Namen Flattened Planar Fabric (FPF). Außerdem startete das Unternehmen innerhalb des OCP die Initiative Open Switch Platform Architecture (OSPA) und teilte mit, dass das Transportprotokoll MetaRoCE nun in Open-Source-Implementierungen vorliegt.
- Meta stellte IcePack vor, sein erstes flüssigkeitsgekühltes Netzwerk-Rack, mit IceCube-Switch-Blades für 102,4 Tbit/s unter FBOSS.
- IceCube gibt es mit Broadcom Tomahawk6C und NVIDIA Spectrum-6 und verdoppelt laut Meta die Bandbreite gegenüber den 51,2T-Plattformen.
- Flattened Planar Fabric verbindet jede GPU über acht 100G-Links mit acht Switches und wechselt von einem drei- zu einem zweistufigen Clos-Fabric.
- OSPA, gemeinsam von Meta, Microsoft und Alibaba geleitet, hat die Spezifikation v1.0 beim OCP eingereicht.
- MetaRoCE, Metas RDMA-Transportprotokoll für KI-Netzwerke, liegt nun in Open-Source-Implementierungen vor.
IcePack und IceCube: Flüssigkeitskühlung für Switching mit 102,4T
Meta zufolge steuern KI-Cluster auf Gigawatt-Größenordnungen zu. Netzwerk-Switches müssen deshalb deutlich mehr Bandbreite bei engeren Grenzen für Strom und Kühlung liefern. Die Antwort des Unternehmens heißt IcePack, laut Meta sein flüssigkeitsgekühltes Netzwerk-Rack der ersten Generation, das auf dem OCP-Rack-Standard ORV3-HPRv1 basiert.
Jedes Rack nimmt IceCube-Switch-Blades auf. Laut Meta handelt es sich um Fabric-Switches mit 102,4 Tbit/s, die 128×800G nicht blockierende Switching-Kapazität bieten. IceCube gibt es in zwei Varianten: eine auf Basis von Broadcoms Switch-ASIC Tomahawk6C und eine mit dem NVIDIA Spectrum-6 Switch ASIC. Beide laufen mit Metas quelloffenem Netzwerkbetriebssystem FBOSS, das OCP SAI (Switch Abstraction Interface) nutzt.
Meta beschreibt die Generation als Verdopplung der Bandbreite gegenüber den 51,2T-Plattformen, bei zugleich der thermischen Dichte, die für KI-Rechenzentren der nächsten Generation nötig ist.
Flattened Planar Fabric verändert die Anbindung von GPUs
FPF ist Metas Multiplane-Backend-Scale-out-Fabric. Jede GPU ist über acht unabhängige 100G-Links mit acht verschiedenen Switches verbunden, und zwar je einem pro Netzwerkebene. Laut Meta ersetzt dies das herkömmliche Uplink-Design mit einer einzigen Ebene und bringt vier Vorteile:
- Größere nicht blockierende GPU-Cluster, als es Topologien mit einer Ebene erlauben.
- Eine abgeflachte Topologie: vom dreistufigen Clos-Fabric von Metas NSF-Fabric hin zu einem zweistufigen Clos-Fabric, was Netzwerk-Hops, Latenz und Infrastrukturkosten senkt.
- Hardware-Lastverteilung auf NIC-Ebene, bei der die NIC jedes Paket in Hardware auf alle acht Ebenen verteilt.
- Eine kombinierte Control Plane für Switches und Hosts, sodass ein Host Datenverkehr an ausgefallenen Ebenen vorbeilenken kann.
Meta gibt an, bei FPF eng mit NVIDIA zusammengearbeitet zu haben und dabei die Spectrum-X-Multiplane-Innovationen von NVIDIA zu nutzen. Beide Unternehmen arbeiten zudem mit gemeinsamen Cloud-Partnern daran, Multiplane-Fabric-Implementierungen auf Grundlage der FPF-Erfahrungen von Meta zu standardisieren.
Skalierung über Clouds, Standorte und Regionen hinweg
Meta argumentiert, dass der Bau eigener Rechenzentren allein die KI-Kapazitätsziele nicht erfüllen kann, weil der Bau mehrjährige Vorlaufzeiten hat, während die Nachfrage sich in Monaten bewegt. Das Unternehmen nutzt daher neben den eigenen Campus-Standorten auch angemietete Anlagen und Kapazitäten aus der Public Cloud. Dafür muss sich das Netzwerk überall gleich verhalten, wo die GPUs stehen, was Meta als wirklich schwierig bezeichnet: Die Fabric-Topologien unterscheiden sich je nach Anbieter, das Buffering ist oft flacher, RDMA-Transporte sind anbieterspezifisch, und manche Clouds setzen weiterhin auf InfiniBand statt auf Ethernet und RoCE.
Dafür beschreibt Meta ein standardisiertes Framework zur Leistungsvalidierung. Cloud-Partner führen vor der Übergabe eines Clusters eine gemeinsame Reihe von Punkt-zu-Punkt- und Collective-Benchmarks aus, die von einigen Dutzend bis zu über tausend GPUs skalieren. Außerdem bildet Meta abweichende Traffic-Class-Schemata und Parameter der Überlastkontrolle auf seine verlustfreien RDMA-Klassen ab.
Für das Training über mehrere Standorte verweist Meta auf seine Backend-Aggregation-Schicht (BAG), einen zentralisierten, Ethernet-basierten Super-Spine, der viele Spine-Layer-Fabrics über Gebäude, Campus-Standorte und Regionen hinweg zu einem Mega-Cluster verbindet. Er arbeitet im Petabit-Bereich, wobei die Inter-BAG-Kapazität zwischen zwei Regionen zig Petabit pro Sekunde erreicht. Meta zufolge ermöglicht BAG, dass Prometheus mit rund 1 Gigawatt im Jahr 2026 als ein einziger Cluster arbeitet, während Hyperion auf 5 Gigawatt hochskaliert wird.
Da verlustfreies Ethernet Pufferreserven benötigt, die proportional zur Kabellänge sind, misst FBOSS laut Meta nun die tatsächliche Kabellänge vor Ort, indem es Probe-Traffic in einer nicht überlasteten Queue zeitlich erfasst. Die Reserven werden dann anhand dieser Messung zugewiesen, statt jeden Link für eine Worst-Case-Entfernung auszulegen.
Scale-up, OSPA und MetaRoCE
Beim Scale-up-Networking setzt Metas System MTIA 300 auf Tahan, einen Ethernet-basierten 51,2T-Scale-up-Switch, der 6,4 Tbit/s pro Beschleuniger liefert. Meta zeigte vorab ein Design der nächsten Generation mit 72 Beschleunigern pro Rack auf 102,4T-Silizium und erklärte, mit künftigen Chips auf eine ESUN-basierte Implementierung zuzusteuern.
Die Open Switch Platform Architecture ist eine neue OCP-Initiative, die von Meta, Microsoft und Alibaba gemeinsam geleitet wird. Sie soll die Switch-Plattformschicht standardisieren, die Spezifikation v1.0 wurde beim OCP eingereicht. Meta lädt Ingenieure, Chiphersteller, Systemintegratoren und Betreiber zur Mitarbeit ein. MetaRoCE, Metas RDMA-Transportprotokoll für KI-Netzwerke, liegt nun in Open-Source-Implementierungen vor.
Was das bedeutet
Meta erklärt, die Netzwerkarbeit unterstütze die neuesten KI-Workloads, darunter die Modelle Muse Wonder und Muse Spark sowie den persönlichen KI-Agenten Muse. Mit der Einreichung von OSPA v1.0 beim OCP, der Open-Source-Freigabe von MetaRoCE und dem Teilen der FPF-Erkenntnisse mit Cloud-Partnern rückt Meta Teile seines Netzwerkdesigns in Richtung gemeinsamer Standards. In den Worten des Unternehmens: „Heterogenität ist beherrschbar, aber erst Standardisierung macht sie bezahlbar.“
Engineering at Meta: OCP Summit 2026: Powering AI with Open Innovations in Scale-Up, Scale-Out, and Scale-Across Networks